
 脚本プランナー▸
 AIアプリ
 AIニュース
Cloudflare、AutoRAGを発表:フルマネージドのRAGパイプライン
小编 ·

Cloudflare、AutoRAGを発表:フルマネージドのRAGパイプライン
AutoRAGとは
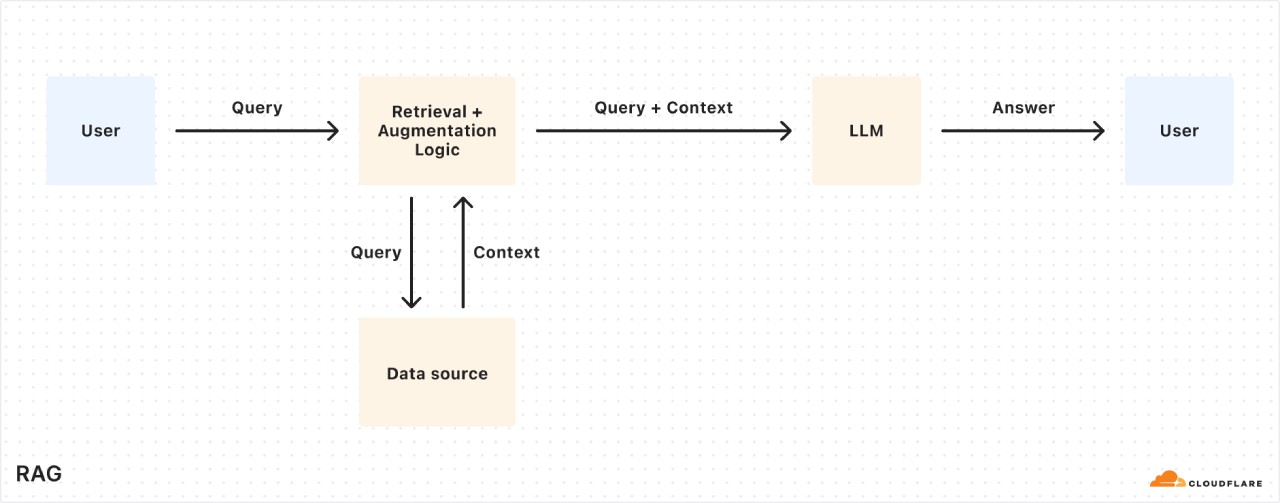
AutoRAGは、Cloudflareが提供する完全マネージドのRAGパイプラインです。RAGとは、ユーザーの自有データから情報を検索し、それを大規模言語モデル(LLM)に提供することで、より正確でより実情に即した応答を生成する方法です。
従来のRAGパイプラインの課題
RAGパイプラインの構築には、データストレージ、ベクトルデータベース、埋め込みモデル、LLMなど、複数のツールやサービスを組み合わせる必要があり、またデータが変化した場合には、システムの関連性とパフォーマンスを維持するために、手動で再インデックス化や埋め込みの再生成を行う必要があります。AutoRAGは、この複雑さを解消することを目的としており、データの取り込み、自動チャンク化と埋め込みから、CloudflareのVectorizeデータベースへのベクトル保存、意味検索の実行、Workers aiによる高品質な応答生成までを、数回のクリックで提供するエンドツーエンドの完全マネージドRAGパイプラインを実現します。さらにAutoRAGは、バックグラウンドで継続的にデータソースを監視してインデックス化を行うため、手間をかけずにAIを最新の状態に保つことができます。
RAGを利用する理由
LLMの限界 :MetaのLlama 3.3のようなLLMは強力ですが、その知識は学習時に触れた内容に限られるため、新しい情報や専有情報、あるいは特定のドメイン固有の情報については正確な回答が難しいことがよくあります。関連するシステムプロンプト情報を提供することはある程度役立ちますが、入力サイズが大きくなり、コンテキストウィンドウの制限を受けます。モデルのファインチューニングは高コストであり、最新状態を維持するためには継続的な再学習が必要です。
RAGの利点 :RAGはクエリ時にデータソースから関連情報を取得し、それをユーザーの入力クエリと組み合わせた上でLLMに入力し、ユーザーデータに基づいた応答を生成します。このためRAGは、AI駆動のカスタマーサポートボット、社内ナレッジアシスタント、複数文書にわたるセマンティック検索など、情報源が常に変化し続けるユースケースに非常に適しています。
AutoRAGの仕組み
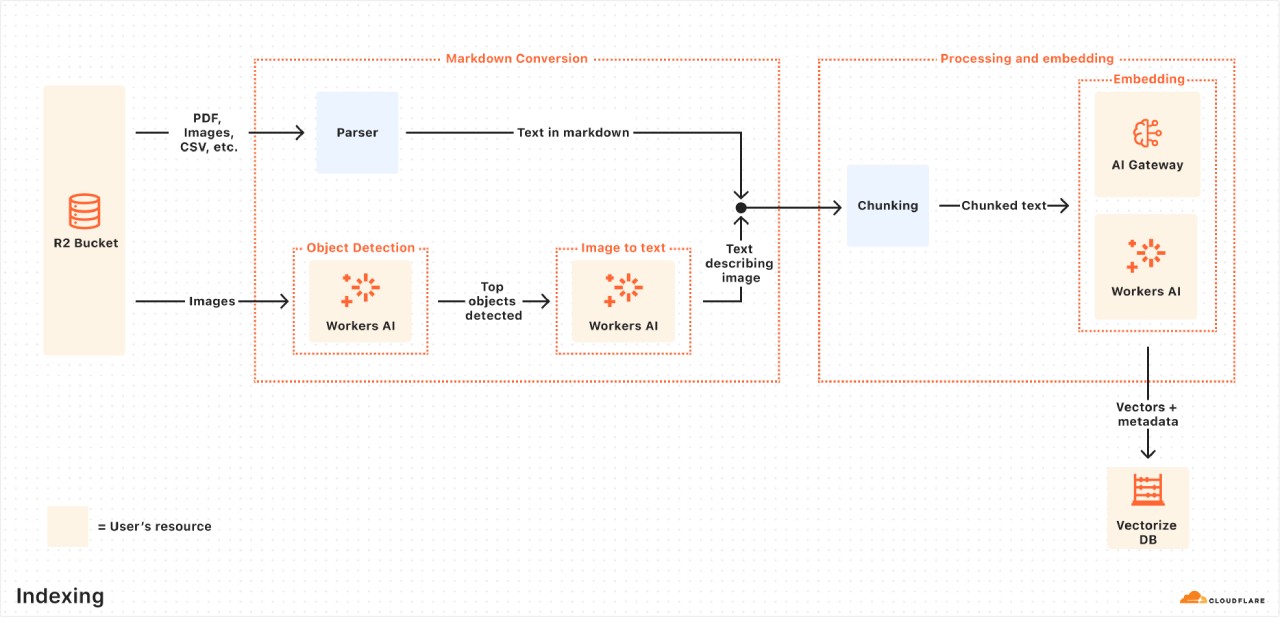
インデックス処理 :これはバックグラウンドで実行される非同期処理で、AutoRAGを作成すると自動的に開始され、毎回のジョブ完了後に、新ファイルや更新済みファイルを循環的に再処理します。インデックス処理では、コンテンツがセマンティック検索に最適化されたベクトルに変換されます。
ファイルの取り込み :AutoRAGはデータソースから直接ファイルを読み取ります。現状ではCloudflare R2との統合をサポートしており、PDF、画像、テキスト、HTML、CSVなどさまざまな形式のドキュメントをR2内に保存して処理することができます。
Markdownへの変換 :Workers AIのMarkdown変換機能を使用して、すべてのファイルを構造化されたMarkdown形式に変換し、異なるファイル種別間の一貫性を確保します。画像については、Workers AIによる物体検出を行い、その後ビジュアルからテキストへの変換を行って、画像をMarkdownテキストに変換します。
チャンク化 :抽出されたテキストは、より小さなチャンクに分割され、検索の粒度を高めます。
埋め込み :Workers AIの埋め込みモデルを使用して各チャンクを埋め込み、コンテンツをベクトルに変換します。
ベクトル保存 :得られたベクトルと、ソースの位置情報やファイル名などのメタデータが、アカウント上に作成されたCloudflareのVectorizeデータベースに保存されます。
クエリ処理 :これはユーザーが検索リクエストを送信した際にトリガーされる同期処理です。
AutoRAG APIからのクエリの受信 :AutoRAGのAI検索または検索エンドポイントにリクエストを送信すると、クエリのワークフローが開始されます。
クエリの書き換え(オプション) :AutoRAGでは、Workers AIが提供するLLMのいずれかを使用して入力クエリを書き換えるオプションが用意されており、元のクエリをより効果的な検索クエリに変換することで検索品質を向上させることができます。
クエリの埋め込み :書き換えられた(または元の)クエリを、データを埋め込んだ際と同じ埋め込みモデルに通してベクトルに変換し、ベクトル化されたデータと照合して最も関連性の高いマッチを見つけます。
Vectorizeでのベクトル検索 :クエリベクトルを、AutoRAGに関連付けられたVectorizeデータベース内のベクトルと照合します。
メタデータとコンテンツの取得 :Vectorizeは最も関連性の高いチャンクとそのメタデータを返し、R2バケットから元のコンテンツを取得します。これらのコンテンツはテキスト生成モデルに渡されます。
応答生成 :Workers AIのテキスト生成モデルを使用して、取得したコンテンツと元のユーザークエリに基づいて応答を生成します。
AutoRAGの使用方法
Browser Rendering APIの利用 :コンテンツがR2バケット内ではなく、まだウェブ上にある場合やフロントエンドUIを介して動的に表示される必要がある場合は、Browser Rendering APIを使用して自身のウェブサイトをクロールし、RAGに情報を提供するコンテンツを取得することができます。Browser Rendering REST APIは本日より一般提供を開始しており、HTMLコンテンツの抽出、スクリーンショットの撮影、PDF生成など、一般的なブラウザ操作用のエンドポイントを提供します。さらに間もなくクロールエンドポイントも提供予定で、ウェブサイトのコンテンツ取得がより便利になります。
ステップ1:Workerを作成してウェブページをクロールし、R2にアップロードする
browser-r2-workerという名前の新しいWorkerプロジェクトを作成し、適切なオプションを選択して設定を行います。
@cloudflare/puppeteerをインストールして、ブラウザレンダリングインスタンスを制御できるようにします。
html-bucketという名前の新しいR2バケットを作成します。
Wranglerの設定ファイルに適切な設定を追加し、Workerがブラウザレンダリングと新しいR2バケットを利用できるようにします。
src/index.tsの中身を置き換え、ウェブページをクロールしてR2バケットに保存するスクリプトコードを記述します。
WorkerをCloudflareアカウントにデプロイします。
cURLリクエストでWorkerをテストし、ウェブページのHTMLファイルをクロールしてhtml-bucketバケットにアップロードします。
ステップ2:AutoRAGを作成し、インデックスを監視する
Cloudflareダッシュボードで、AI > AutoRAGに移動します。
「AutoRAGを作成」を選択し、ナレッジベースを含むR2バケット、埋め込みモデル、LLM、AIゲートウェイの選択、AutoRAGの命名、サービスAPIトークンの選択または作成など、設定プロセスを完了します。
AutoRAGを作成すると、アカウント内に自動的にVectorizeデータベースが作成され、データのインデックス化が開始されます。インデックスジョブの進捗は、AutoRAGの概要ページで確認できます。
ステップ3:テストしてアプリケーションに組み込む
インデックス化が完了したら、AutoRAGに質問を始められます。AutoRAGインスタンスのPlaygroundタブで、例えば「AutoRAGとは?」などの質問を行うことができます。
Playgroundの結果に満足できれば、AutoRAGを開発中のアプリケーションに直接統合できます。Workerを使用してアプリケーションを構築している場合は、AIバインディングを通じてAutoRAGを直接呼び出すことができます。
オープンベータ期間中、AutoRAGは無料でご利用いただけます。インデックス化、検索、拡張のコンピューティング操作については、この期間の追加料金は発生しません。
公式詳細情報:https://blog.cloudflare.com/introducing-autorag-on-cloudflare/









