
 脚本プランナー▸
 AIアプリ
 AIニュース
OmniTalker:Alibabaによるリアルタイムテキスト駆動型喋りアバターフレームワーク
小编 ·

OmniTalker:Alibabaによるリアルタイムテキスト駆動型喋りアバターフレームワーク
OmniTalkerとは?
OmniTalkerは、アリババのTongyi Labが開発した、リアルタイムテキスト駆動型の話すアバターAIマルチモーダル生成フレームワークです。入力されたテキストコンテンツに基づいて、一致する音声と動画アニメーションをリアルタイムで生成します。生成される音声と動画は高品質であるだけでなく、表情や頭部の動きもリアルに再現し、まるで本物の「デジタルヒューマン」があなたと会話しているかのような体験を提供します。OmniTalkerは中国語と英語の相互変換をサポートし、平静、喜び、悲しみ、怒りなどの感情表現にも対応しており、長時間の動画生成も可能です。
OmniTalkerの機能特徴
マルチモーダル入力処理:テキスト、画像、音声、動画など複数のモーダルを認識できます。
ストリーミング生成:テキストと自然な音声応答をストリーミング方式で生成し、オーディオおよびビデオエンコーダーはチャンク処理方式を採用することで、長いシーケンスのマルチモーダルデータの処理を分離しています。
音声と映像の高精度同期:TMRoPE技術により、映像と音声入力の高精度な同期を実現します。
リアルタイムインタラクション:チャンク単位の入力と即時出力をサポートし、完全なリアルタイムインタラクションが可能です。
自然でスムーズな音声生成:音声生成の自然さと安定性に優れており、多くの既存のストリーミング型および非ストリーミング型の代替手法を上回ります。
性能上の優位性:マルチモーダルベンチマークテストで優れたパフォーマンスを発揮し、オーディオ能力は同サイズのQwen2-Audioを上回り、Qwen2.5-VL-7Bと同等のレベルを維持しています。
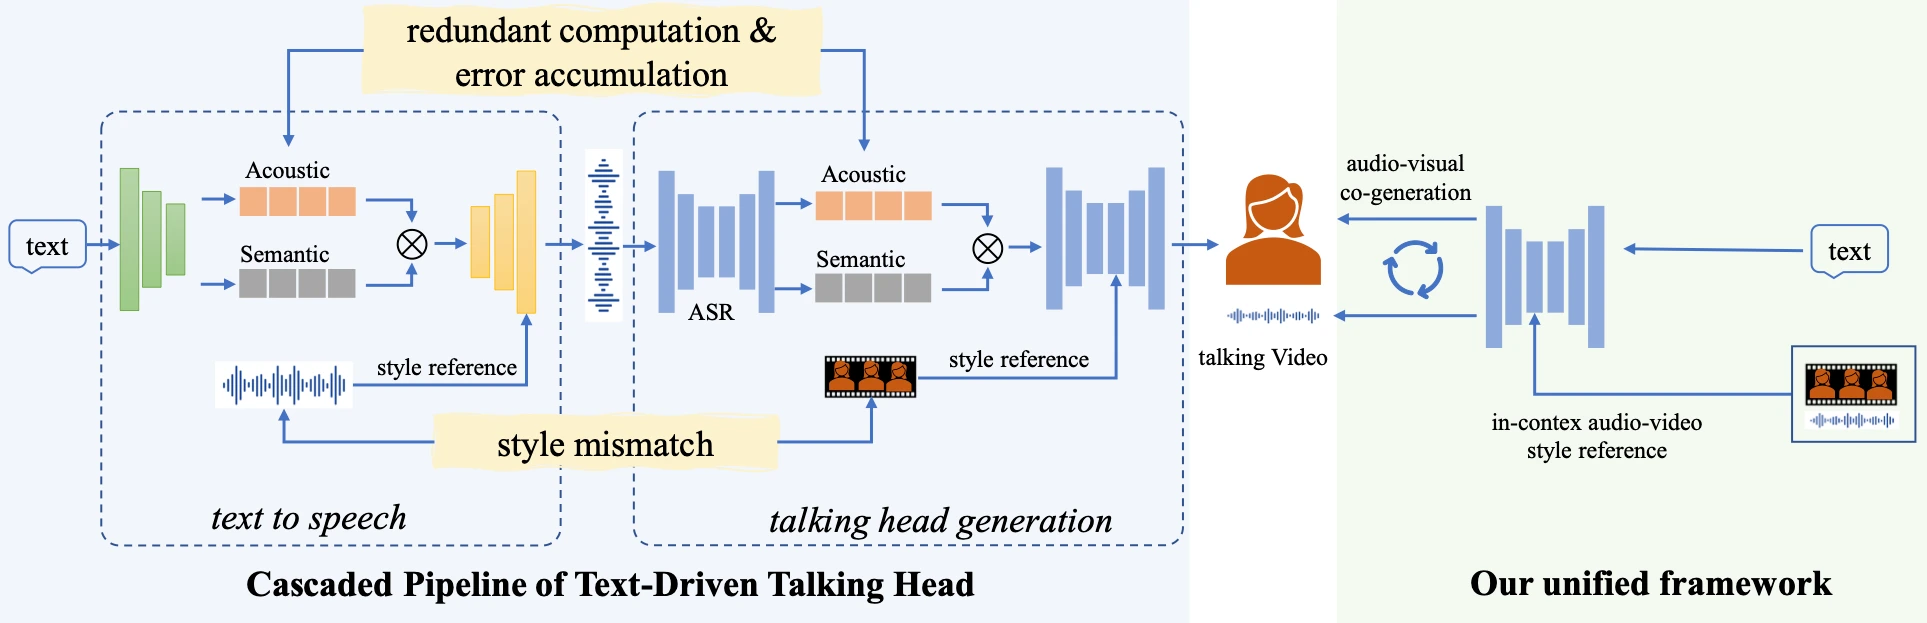
OmniTalkerのコア技術
1. デュアルブランチ拡散トランスフォーマー(DiT)アーキテクチャ
オーディオブランチとビジュアルブランチで構成されています:
オーディオブランチ:テキストから高品質な音声を合成します。
ビジュアルブランチ:頭部の姿勢と表情のダイナミクスを予測します。
新しいオーディオ-ビジュアル融合モジュールにより、オーディオと映像の出力の時間的同期とスタイルの一貫性を保証します。
2. コンテキストリファレンス学習
OmniTalkerは、単一のリファレンス動画から音声と表情のスタイル特徴を捉えることができ、追加のスタイル抽出モジュールを必要としません。つまり、入力テキストに関わらず、OmniTalkerはリファレンス動画のスタイルと高い一貫性を持つ音声と映像コンテンツを生成することができます。
3. リアルタイム性と高い効率性
OmniTalkerは25 FPSの速度で音声と映像をリアルタイムに生成することができ、同類技術の中でも非常に先進的です。この高い推論速度により、OmniTalkerはリアルタイムビデオチャットやバーチャルライブ配信などのシナリオに適用でき、ユーザーにスムーズなインタラクション体験を提供します。
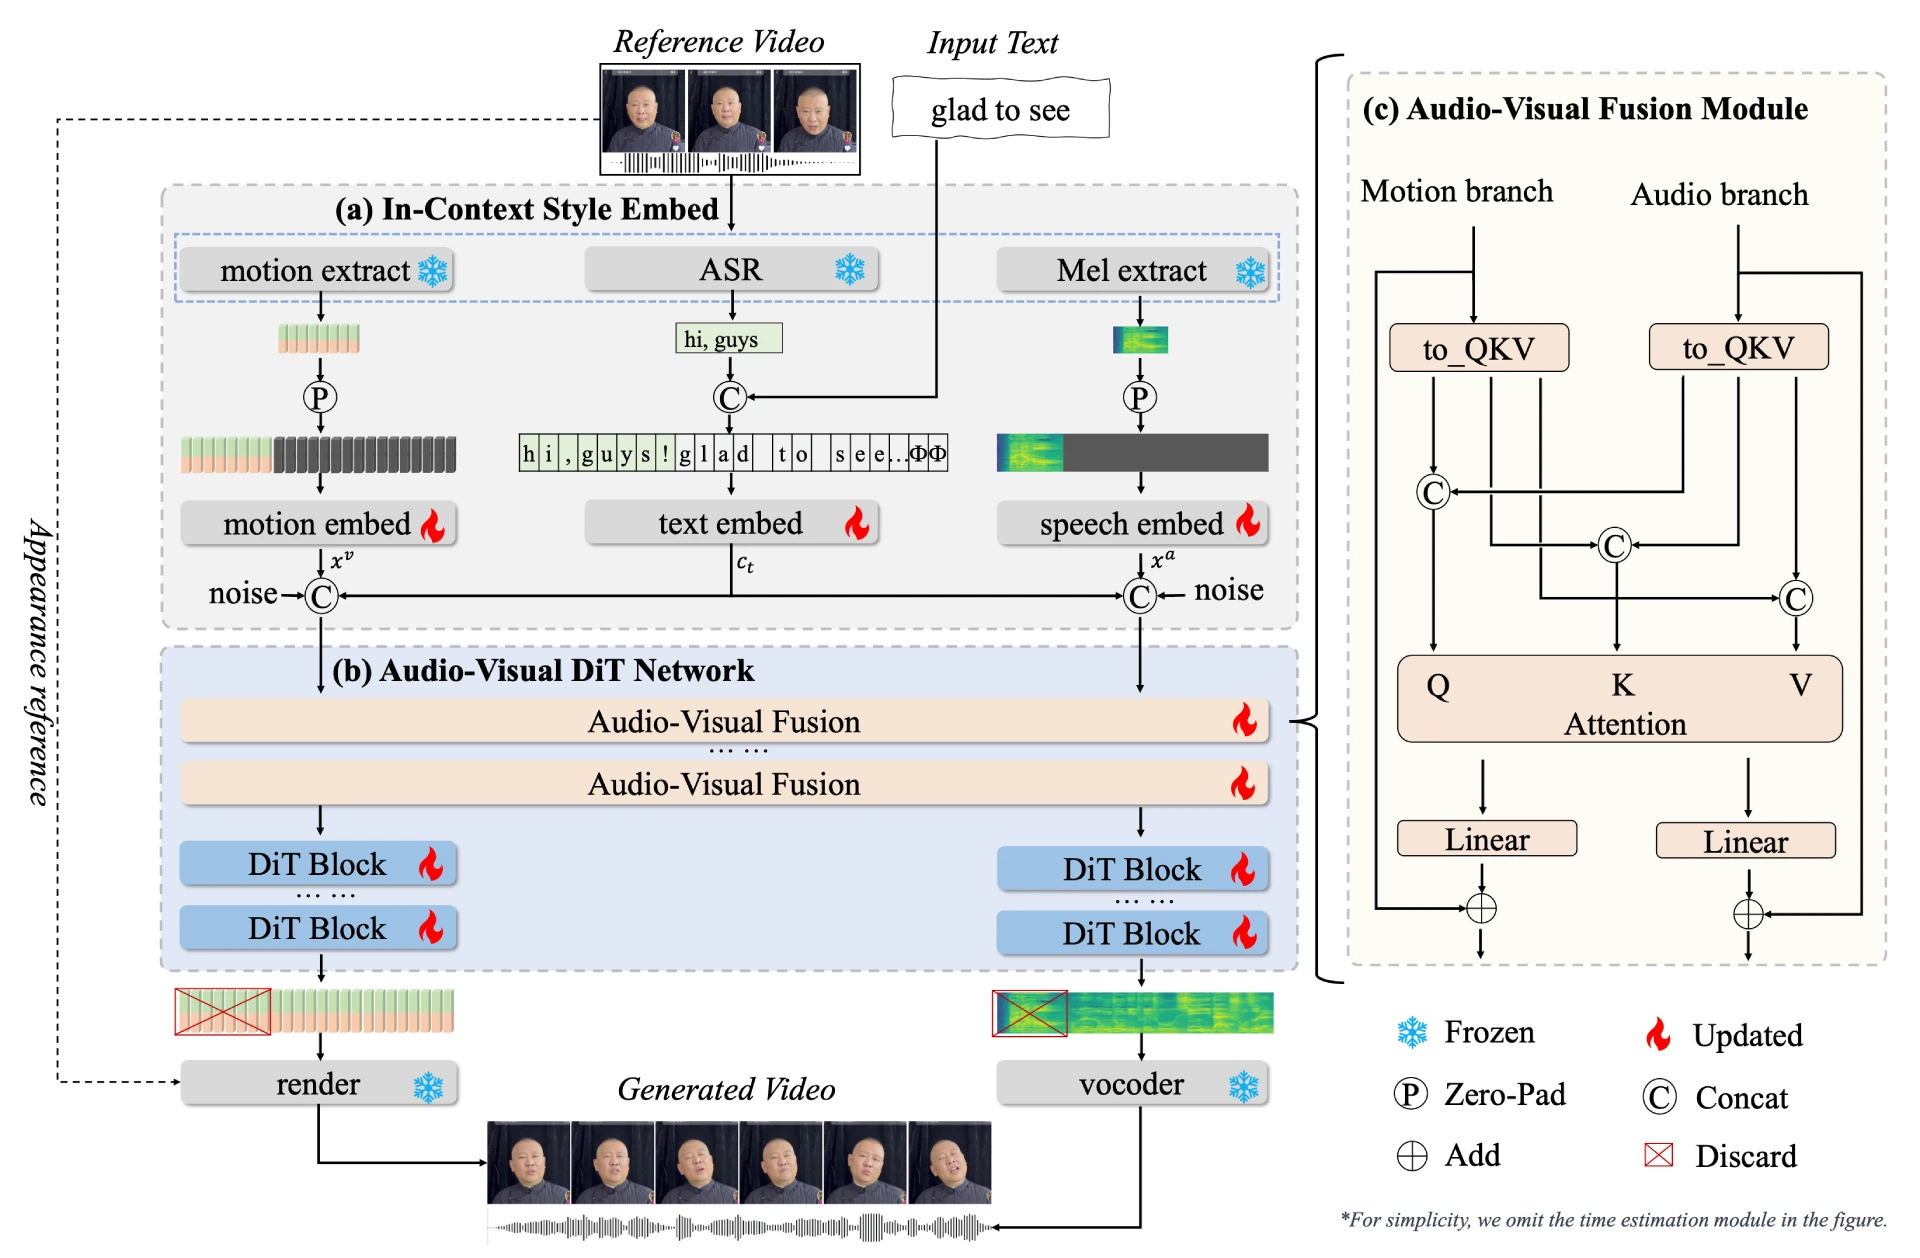
OmniTalkerの応用シーン
スマート音声アシスタント:ユーザーの音声指示を処理し、リアルタイムで音声応答を生成します。
マルチモーダルコンテンツ制作:テキスト、画像、動画の入力を同時に処理し、対応するテキストや音声の説明を生成します。
教育とトレーニング:教育コンテンツに基づいて音声と映像を生成する仮想教師を作成します。
バーチャルカスタマーサービスとアシスタント:リアルタイムで音声と映像の応答を生成するバーチャルカスタマーサービスやアシスタントを作成します。
エンターテインメントとメディア:リアルタイムでパフォーマンスコンテンツを生成するバーチャル主播や俳優を作成します。
OmniTalkerの優位性
高品質な生成:生成される音声と映像コンテンツは品質が高く、音声のトーン、リズム、表情の微妙な変化を含むリファレンス動画のスタイルを正確に再現できます。
ゼロショット学習:大量のトレーニングデータを必要とせず、入力テキストとリファレンス動画に基づいて迅速にコンテンツを生成でき、さまざまなシーンやニーズに対応します。
リアルタイムインタラクション:25 FPSの速度で音声と映像をリアルタイムに生成し、遅延が低く、リアルタイムビデオチャットやバーチャルライブ配信などのシナリオに適しています。
プロジェクト公式サイト:https://humanaigc.github.io/omnitalker/
技術論文:https://arxiv.org/pdf/2504.02433v1









