
 脚本プランナー▸
 AIアプリ
 AIニュース
Llama 4 ScoutとMaverickの違いは?
小编 ·

Llama 4 ScoutとMaverickの違いは?
2025年4月5日、Metaは最新世代のオープンソースaiモデルLlama 4を発表しました。これにはLlama 4 ScoutとLlama 4 Maverickが含まれています。どちらのAIモデルも、混合专家(MoE)アーキテクチャを採用した初のマルチモーダルモデルですが、それぞれどのような違いがあるのでしょうか?
Llama 4 ScoutとLlama 4 Maverickの主な違い:
Llama 4 Scout
パラメータ規模:170億のアクティブパラメータ、16個の「专家」モデル、総パラメータ数は1090億。
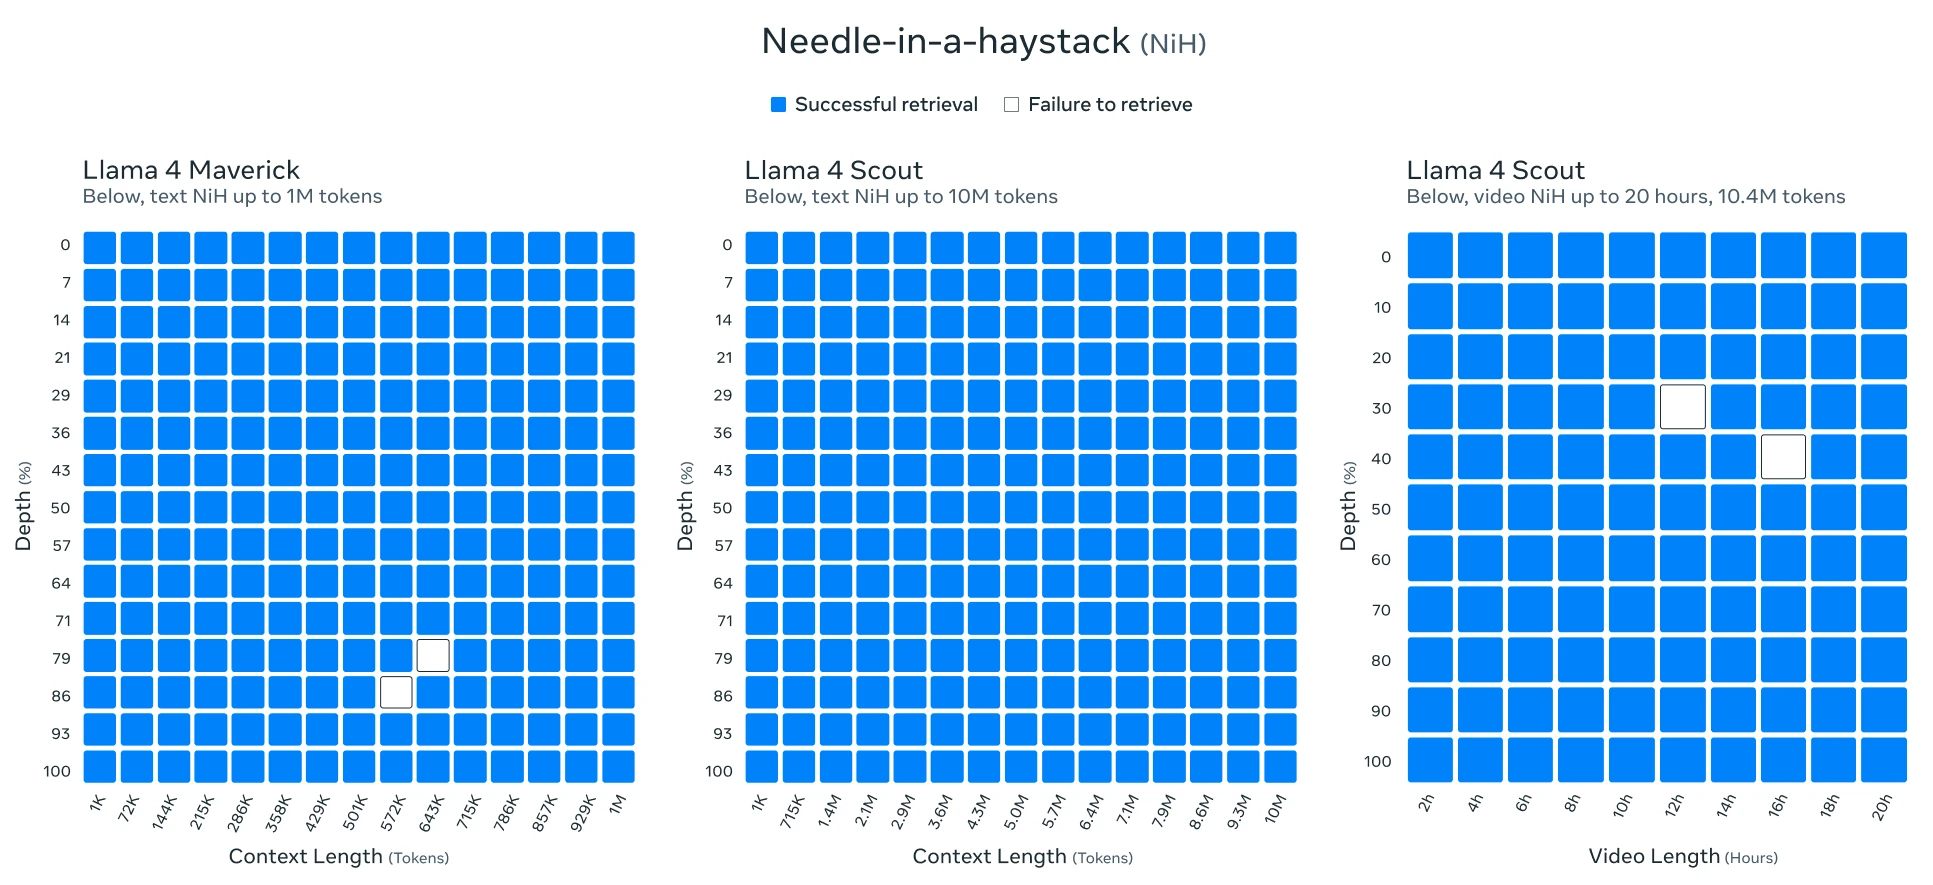
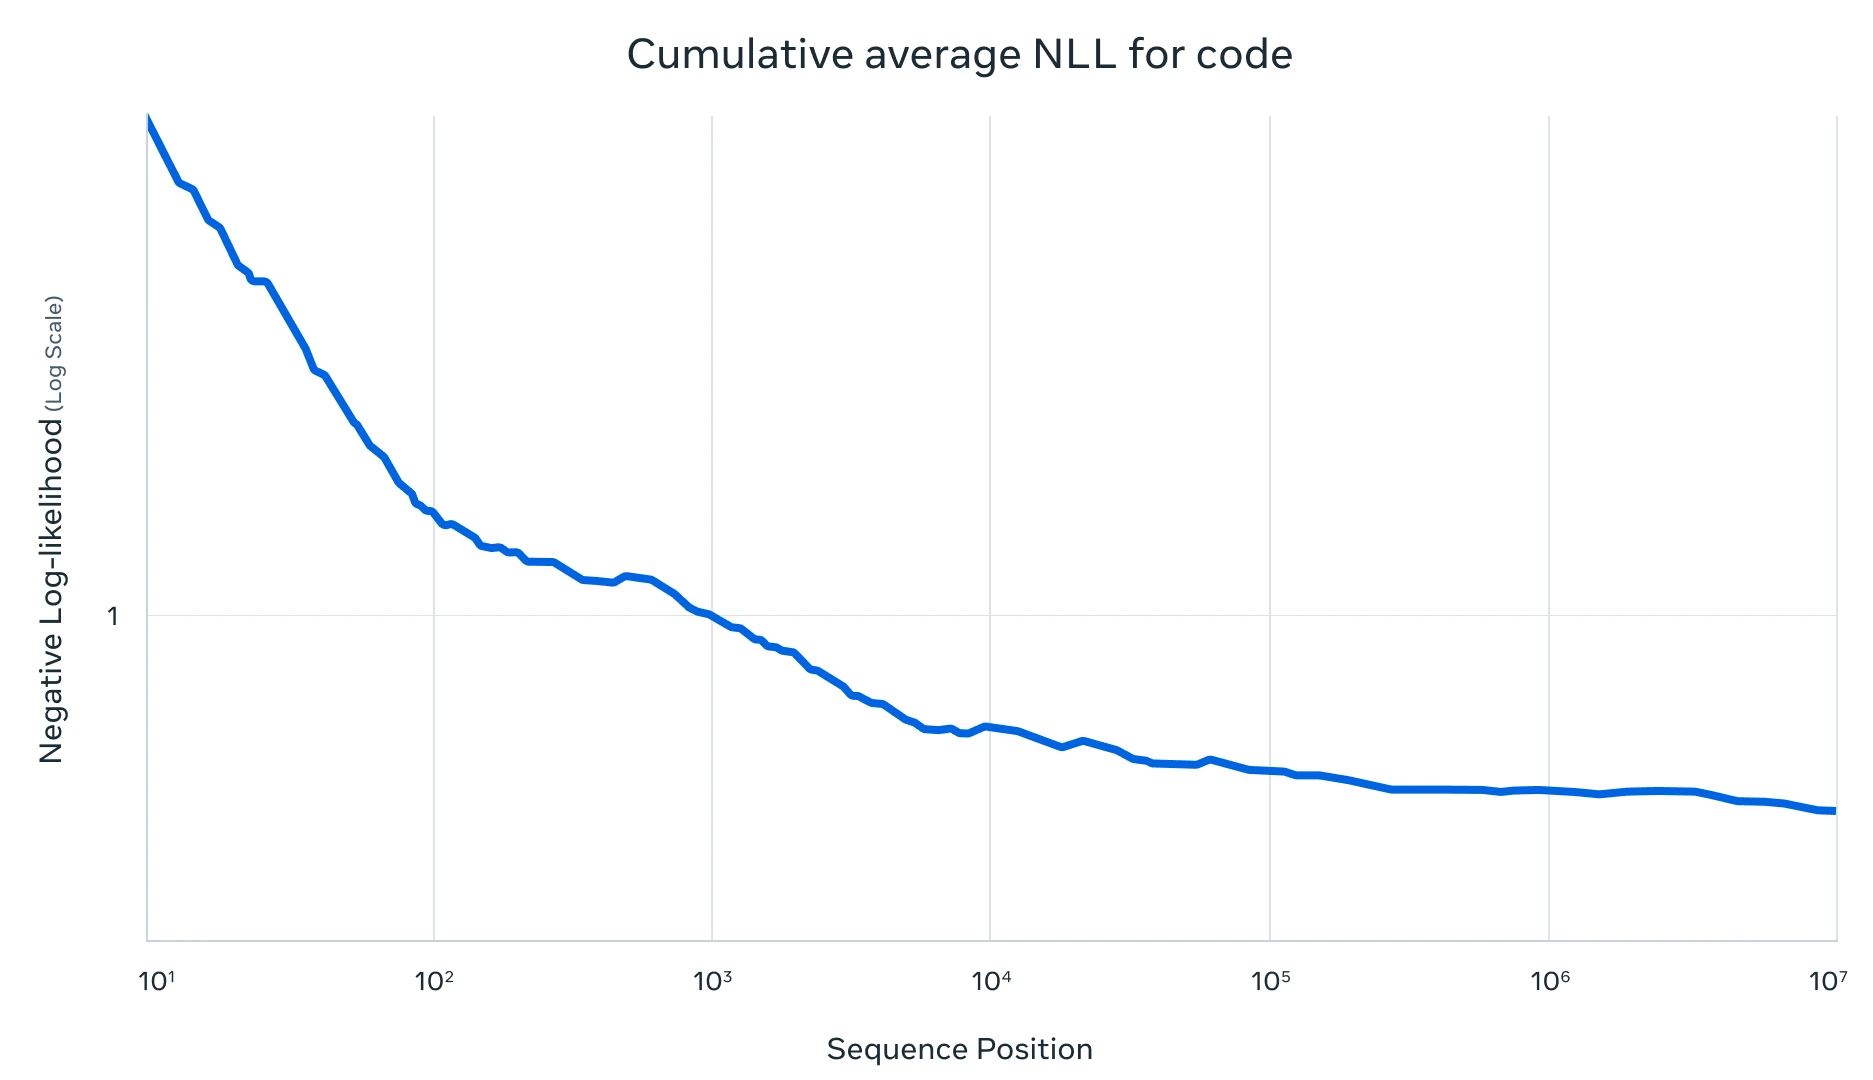
コンテキストウィンドウ:最大1000万トークンのコンテキストウィンドウをサポートし、長文ドキュメントの処理に特に優れた性能を発揮します。
応用シナリオ:ドキュメント要約や大規模コードベースに基づく推論に長けており、効率的な推論と長文処理が必要なシナリオに適しています。
ハードウェア要件:単一のNVIDIA H100 GPU上で動作可能で、Int4量子化によりリソース要件は低くなります。
Llama 4 Maverick
パラメータ規模:170億のアクティブパラメータ、128個の「专家」モデル、総パラメータ数は最大4000億。
コンテキストウィンドウ:100万トークンのコンテキストウィンドウをサポート。
応用シナリオ:クリエイティブライティング、コード生成、翻訳、推論、長文コンテキスト要約、画像ベンチマークテストにおいて、OpenAIのGPT-4oやGoogleのGemini 2.0などのモデルを上回る性能を発揮します。
ハードウェア要件:NVIDIA H100 DGXホストまたは同等の性能を持つデバイス上で動作させる必要があります。
両者の比較
性能:Maverickはマルチモーダルタスクと推論能力においてより強力な性能を発揮し、Scoutは長文処理とドキュメント要約においてより優位性があります。
リソース要件:Scoutは単一GPU上で動作可能なため、リソース制限のあるシナリオにより適しています。Maverickはより高いハードウェア構成を必要とします。
応用シナリオ:Scoutはドキュメント処理やコード推論など、大量のテキスト処理が必要なシナリオに適しています。Maverickはクリエイティブライティングや画像処理など、マルチモーダルインタラクションと複雑な推論が必要なタスクにより適しています。
推論コスト
Llama 4 Scout:モデル規模が小さく効率的な量子化技術を採用しているため、推論コストは比較的低く、高速な応答と低リソース消費が求められるアプリケーションに適しています。
Llama 4 Maverick:総パラメータ数はより多いものの、混合专家アーキテクチャの採用により推論コストも最適化されています。MetaはLlama 4 Maverickの推論コストを100万トークンあたり0.19ドルから0.49ドル(入力と出力の比率3:1)と見積もっており、GPT-4oのような専有モデルよりも大幅に安価です。
Llama 4 Scoutは長文処理とリソース制限のあるシナリオに適しており、Llama 4 Maverickは推論とコード生成能力に優れ、高性能とマルチモーダル処理が必要なアプリケーションに適しています。どちらも混合专家アーキテクチャにより効率的なリソース利用を実現していますが、具体的なリソース要件とコストは個々の応用シナリオとハードウェアに依存します。









