
 脚本プランナー▸
 AIアプリ
 AIニュース
Dolphin:Datatangと清華大学が共同発表した東洋言語向け自動音声認識モデル
小编 ·

Dolphin:Datatangと清華大学が共同発表した東洋言語向け自動音声認識モデル
Dolphinとは?
Dolphinは、海天瑞声と清華大学電子工学科音声・オーディオ技術研究室が共同で開発した、東方言語専用の自動音声認識モデルです。Dolphinは40種類の方言と22種類の中国方言(中国語の方言を含む)をサポートしています。高い精度と強いロバスト性を備え、さまざまな複雑な音声環境に対応できます。Dolphinは音声テキスト変換、音声インタラクション、音声コンテンツ分析などのシナリオで広く利用されており、ワンクリックインストールと複数の呼び出し方法をサポートしています。
Dolphinモデルの特徴
多言語サポート:Dolphinは40種類の方言(東アジア、南アジア、東南アジア、中東地域を含む)をサポートし、さらに22種類の中国方言(中国語を含む)もサポートしています。
言語適応:入力音声の言語種類を自動的に識別し、手動で指定する必要はありません。
高い精度:複数のテストセットにおいて、単語誤り率(WER)は同種のモデルよりも顕著に低くなっています。
強いロバスト性:異なるアクセント、話速、背景ノイズなどの複雑な音声環境に対応できます。
高性能:海天瑞声、Fleurs、CommonVoiceの3つのテストセットにおいて、Whisperと同等サイズのモデルと比較して、Dolphinの単語誤り率(WER)は顕著に低下しています。例えば、baseバージョンの平均WERは63.1%低下、smallバージョンの平均WERは68.2%低下しています。
オープンソース:Dolphinのbaseおよびsmallバージョンのモデルと推論コードは完全にオープンソース化されています。
Dolphinの技術アーキテクチャ
ネットワーク構造:CTC-Attentionアーキテクチャに基づき、E-BranchformerエンコーダーとTransformerデコーダーを採用し、4倍のダウンサンプリング層を導入しています。この構造はCTCのシーケンスモデリング能力とアテンション機構のコンテキスト捕捉能力を組み合わせ、モデルの認識精度と効率を効果的に向上させます。
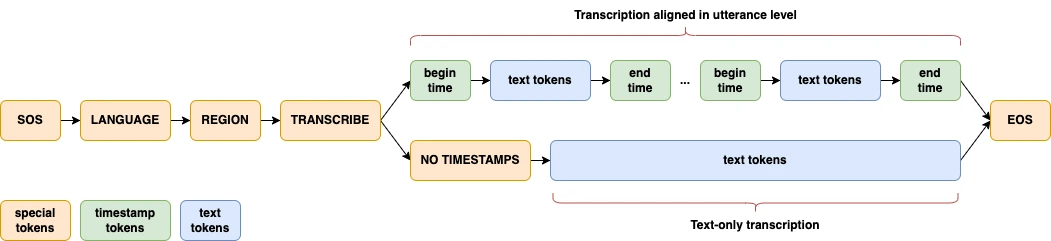
マルチタスク形式:DolphinはWhisperとOWSMの設計手法を参考に、ASRに焦点を当てていくつかの重要な修正を行っています。例えば、previous textとその関連タグの使用を廃止し、入力形式を簡素化しています。さらに、Dolphinは言語と地域の多様性をより適切に処理するために、二段階の言語タグシステムを導入しています。
データ基盤
Dolphinの学習データセットは、海天瑞声の独自データと複数のオープンソースデータセットを統合したもので、合計21.2万時間以上におよびます。そのうち、海天瑞声データセットには38種類の方言をカバーする137,712時間のオーディオが含まれています。
応用シナリオ
音声テキスト変換:会議記録、音声入力などのシナリオに適用されます。
音声インタラクション:AIスマート音声アシスタント、スマートホームなどに使用され、インタラクション体験を向上させます。
音声コンテンツ分析:音声メディアコンテンツを迅速に転写および分析します。
Dolphinの使用チュートリアル
インストール:ユーザーはコマンド pip install -U dataoceanai-dolphin でワンクリックインストールできます。
コマンドライン呼び出し:例えば、dolphin audio.wav を使用して音声認識を行い、モデルバージョン、言語、地域のタグを指定することもできます。
Python呼び出し: dolphin モジュールをインポートし、オーディオとモデルを読み込むことで、音声認識を行うことができます。
関連リンク
Githubアドレス:https://github.com/DataoceanAI/Dolphin
プロジェクトホームページ:https://huggingface.co/DataoceanAI









