
 脚本プランナー▸
 AIアプリ
 AIニュース
QVQ-Max:Alibabaが発表した画像と動画の内容を理解できる視覚推論モデル
小编 ·

QVQ-Max:Alibabaが発表した画像と動画の内容を理解できる視覚推論モデル
QVQ-Maxとは?
QVQ-Maxは、画像や動画の内容を理解する能力を備えた視覚推論モデルであり、関連情報に基づいて分析・推論を行い、解決策を提供することができます。QVQ-Maxモデルは、数学の問題解決、生活上の問題処理、プログラミング支援、芸術創作など、多くの分野で優れたパフォーマンスを発揮します。
設計の初衷
従来のAIモデルの多くはテキスト入力に依存していますが、現実には多くの情報が画像、図表、動画の形式で存在します。QVQ-Maxは、視覚情報を捉えることに長け、かつ迅速な分析能力を備えたアシスタントを構築し、ユーザーがさまざまな実際的な問題を解決できるよう支援することを目指しています。
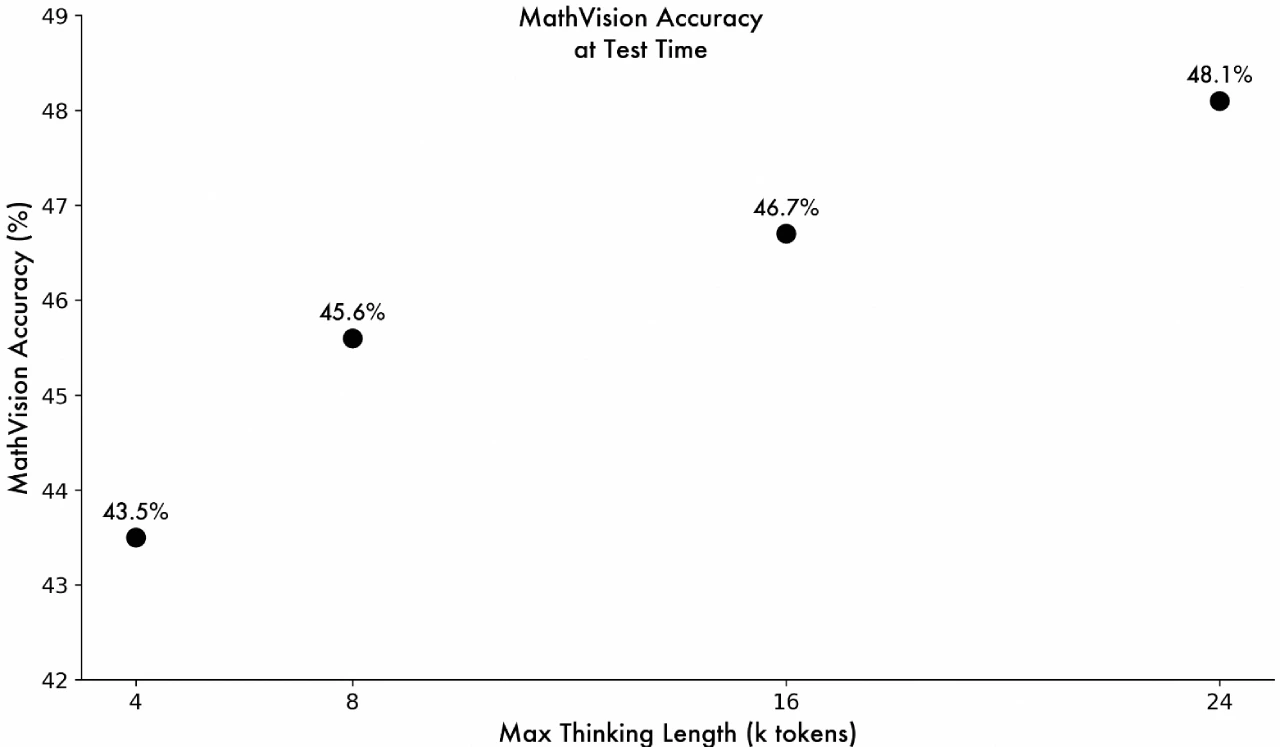
QVQ-Maxの中核能力
詳細な観察:QVQ-Maxは画像内の重要な要素を迅速に識別でき、複雑な図表から日常の写真まで、細部を捉えることができます。
深い推論:モデルは内容を識別するだけでなく、背景知識と組み合わせて推論を行います。例えば、幾何学の問題の図形を解析し、解答を導き出すことができます。
柔軟な応用:分析や推論以外にも、QVQ-Maxは創作にも活用できます。例えば、挿絵のデザイン、短編動画スクリプトの作成、ユーザーのニーズに応じたロールプレイングコンテンツの創作などです。
QVQ-Maxの活用シーン
ビジネスでの活用:データ分析、情報整理、プログラミングなどの業務を支援します。
学習支援:数学や物理などの科目の難問解決、特に図表付きの問題の解決をサポートします。
生活支援:クローゼットの写真に基づいたコーデの提案や、レシピ画像に基づいた調理の指導を行います。
QVQ-Maxの使用方法
1、https://chat.qwen.ai/にアクセスします
2、QWQ-32Bモデルを選択します
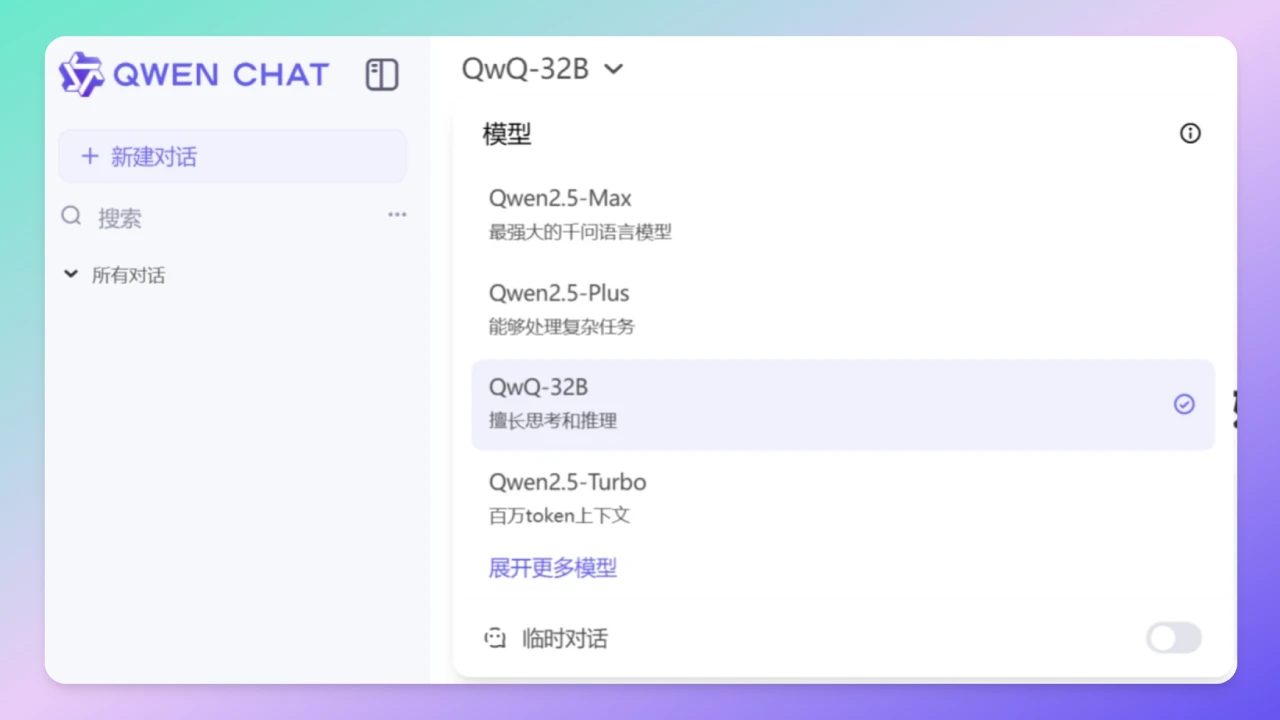
3、入力ボックスの「+」をクリックして画像または動画をアップロードします。
4、画像の内容について質問します。
今後の方向性
観察能力の向上:視覚的内容検証技術(groundingなど)を活用し、識別精度を高めます。
タスク処理能力の強化:視覚Agentを発展させ、複数ステップや複雑なタスクを処理する能力を向上させます。例えば、スマホやPCの操作、ゲームプレイなどです。
インタラクション体験の最適化:ツール検証や視覚生成など、インタラクションモダリティを拡張します。
QVQ-Maxは視覚推論モデルとして大きな可能性を秘めています。画像の内容を識別するだけでなく、情報を組み合わせて分析・推論を行い、さらにはクリエイティブなタスクもこなせます。現在は最初のバージョンに過ぎませんが、すでに大きな可能性を示しており、将来的には実用的な視覚Agentとなり、実際の問題解決を強力にサポートすることが期待されます 。
詳細紹介:https://qwenlm.github.io/zh/blog/qvq-max-preview/
利用アドレス:https://chat.qwen.ai/









