
 脚本プランナー▸
 AIアプリ
 AIニュース
Qwen2.5-Omni:Alibabaが発表したエンドツーエンドの全能マルチモーダルフラッグシップモデル
小编 ·

Qwen2.5-Omni:Alibabaが発表したエンドツーエンドの全能マルチモーダルフラッグシップモデル
Qwen2.5-Omniとは?
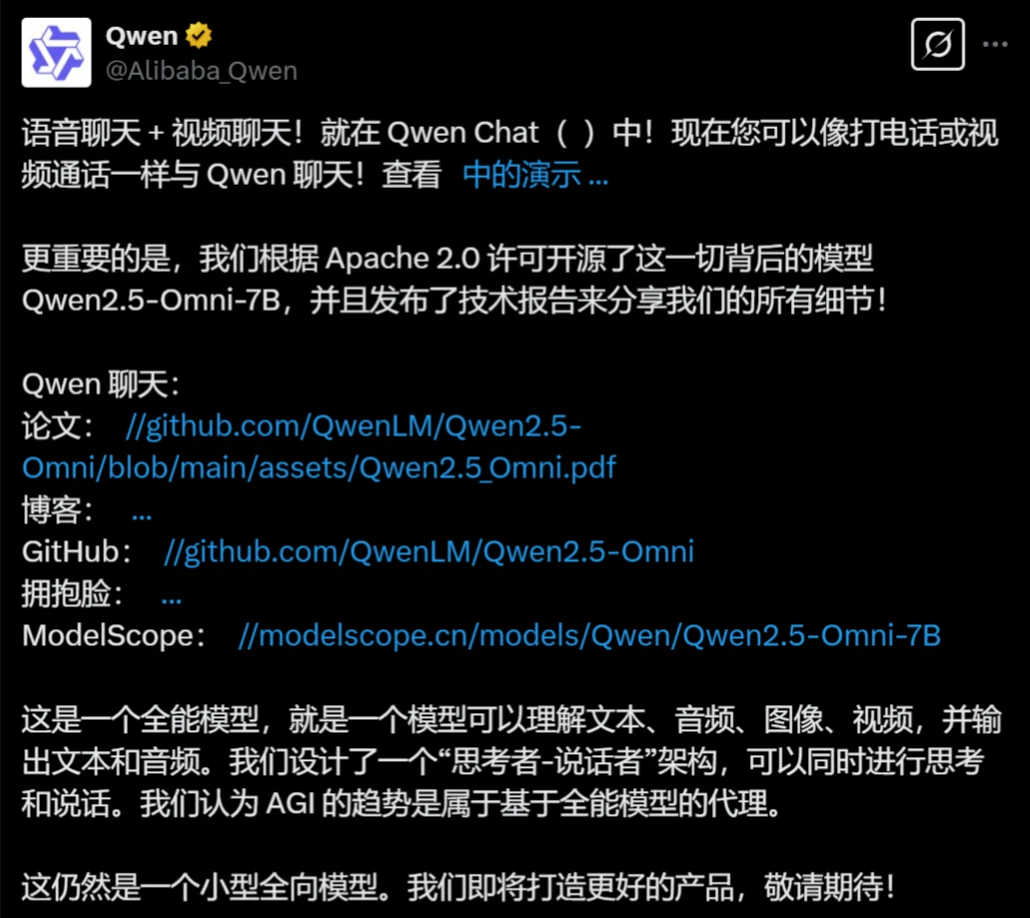
Qwen2.5-Omniは、Alibabaが発表したQwenシリーズの新しい世代のエンドツーエンドマルチモーダルフラッグシップモデルです。あらゆるマルチモーダル認識のために設計されており、テキスト、音声、画像、動画を理解し、同時に思考と発話を行い、リアルタイムのストリーミング応答によってテキストと自然な音声合成出力を同時に生成できるAIモデルです。
Qwen2.5-Omniの主な特徴
革新的なアーキテクチャ:
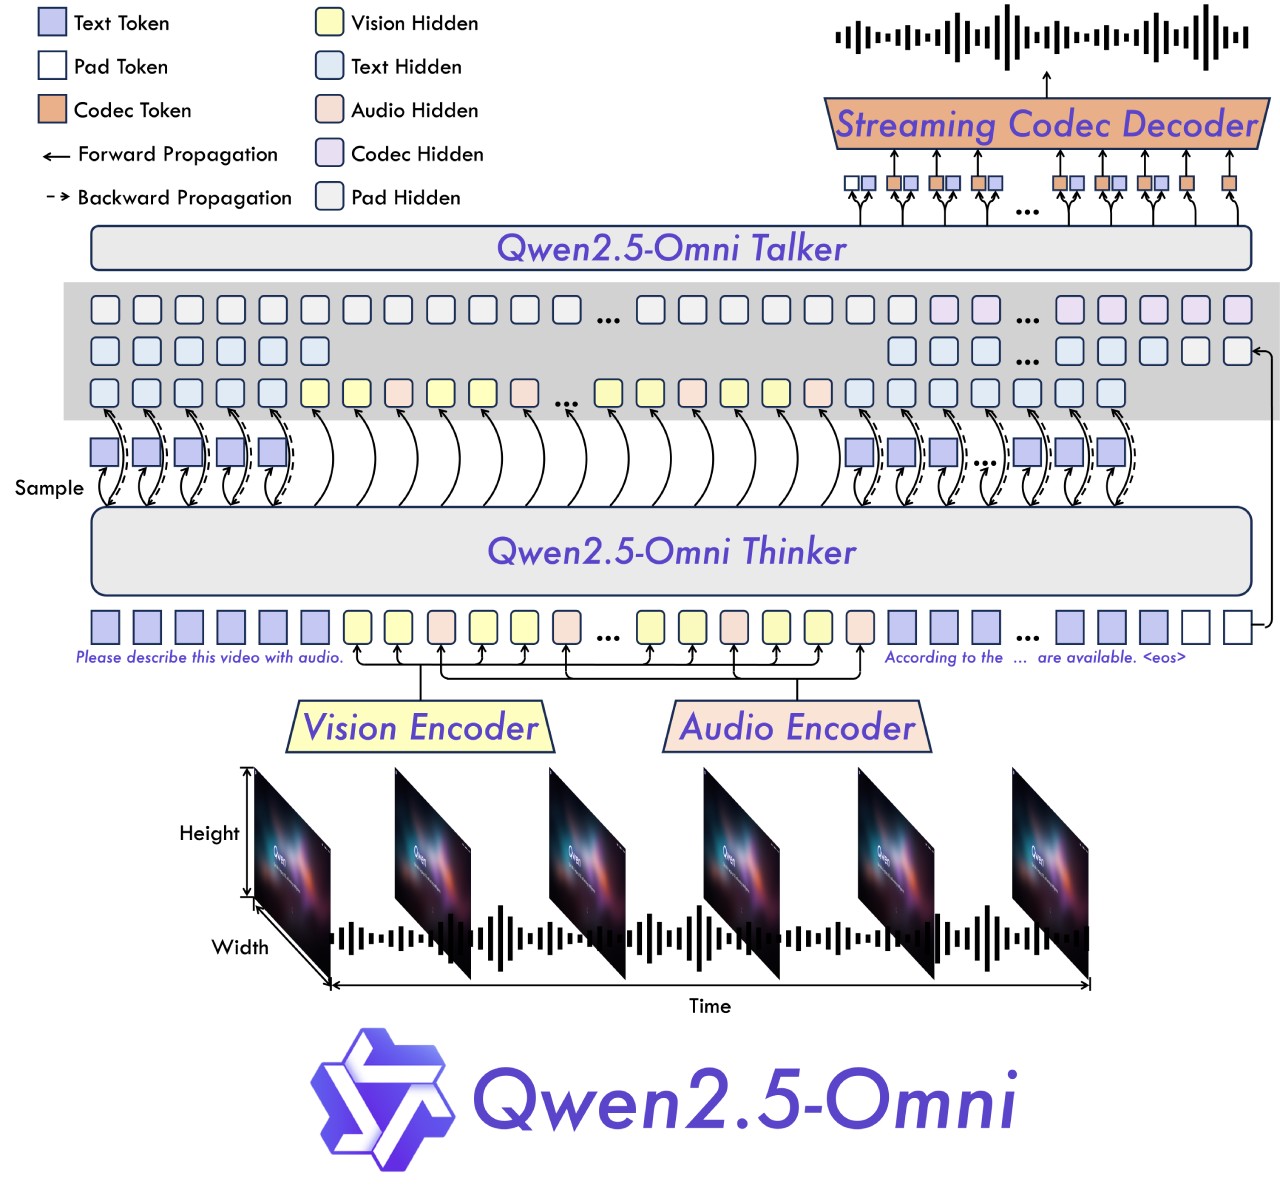
Thinker-Talkerアーキテクチャ:Thinkerはテキスト、音声、動画モーダルからの入力を処理・理解し、高度な意味表現と対応するテキストコンテンツを生成します。Talkerはこれらのコンテンツを自然な音声出力に変換します。
TMRoPE技術:TMRoPE(Time-aligned Multimodal RoPE)と呼ばれる新しい位置エンコーディング技術を提案し、動画入力と音声のタイムスタンプを同期させます。
リアルタイムインタラクション:
完全なリアルタイムインタラクションをサポートし、チャンク化された入力を処理して即座に出力できます。
自然でスムーズな音声生成:
音声生成の自然性と安定性の面で、多くの既存のストリーミングおよび非ストリーミングの代替手段を上回ります。
全モーダルにおける性能優位性:
OmniBenchなどのマルチモーダルタスクで優れた性能を発揮すると同時に、音声認識、翻訳、音声理解、画像推論、動画理解などの単一モーダルタスクでも優れた性能を発揮します。
エンドツーエンド音声指示追従能力:
エンドツーエンドの音声指示追従において、テキスト入力の処理に匹敵する性能を示し、MMLUやGSM8Kなどのベンチマークテストで優れた成績を収めています。
Qwen2.5-Omniのアーキテクチャ設計
Thinker:脳のように機能し、テキスト、音声、動画モーダルからの入力を処理・理解し、高度な意味表現と対応するテキストコンテンツを生成します。
Talker:人間の口に相当し、Thinkerが生成した高度な意味表現とテキストコンテンツを受け取り、ストリーミング方式で自然な音声を出力します。
全体アーキテクチャ:ThinkerはTransformerデコーダーであり、音声と画像用のエンコーダーを備えて情報を抽出します。Talkerはデュアルトラック自己回帰Transformerデコーダーアーキテクチャです。学習と推論のプロセスにおいて、TalkerはThinkerからの高次元表現を直接受け取り、Thinkerのすべての履歴コンテキスト情報を共有します。全体のアーキテクチャは統一されたモデルとしてエンドツーエンドで学習・推論されます。
Qwen2.5-Omniの性能
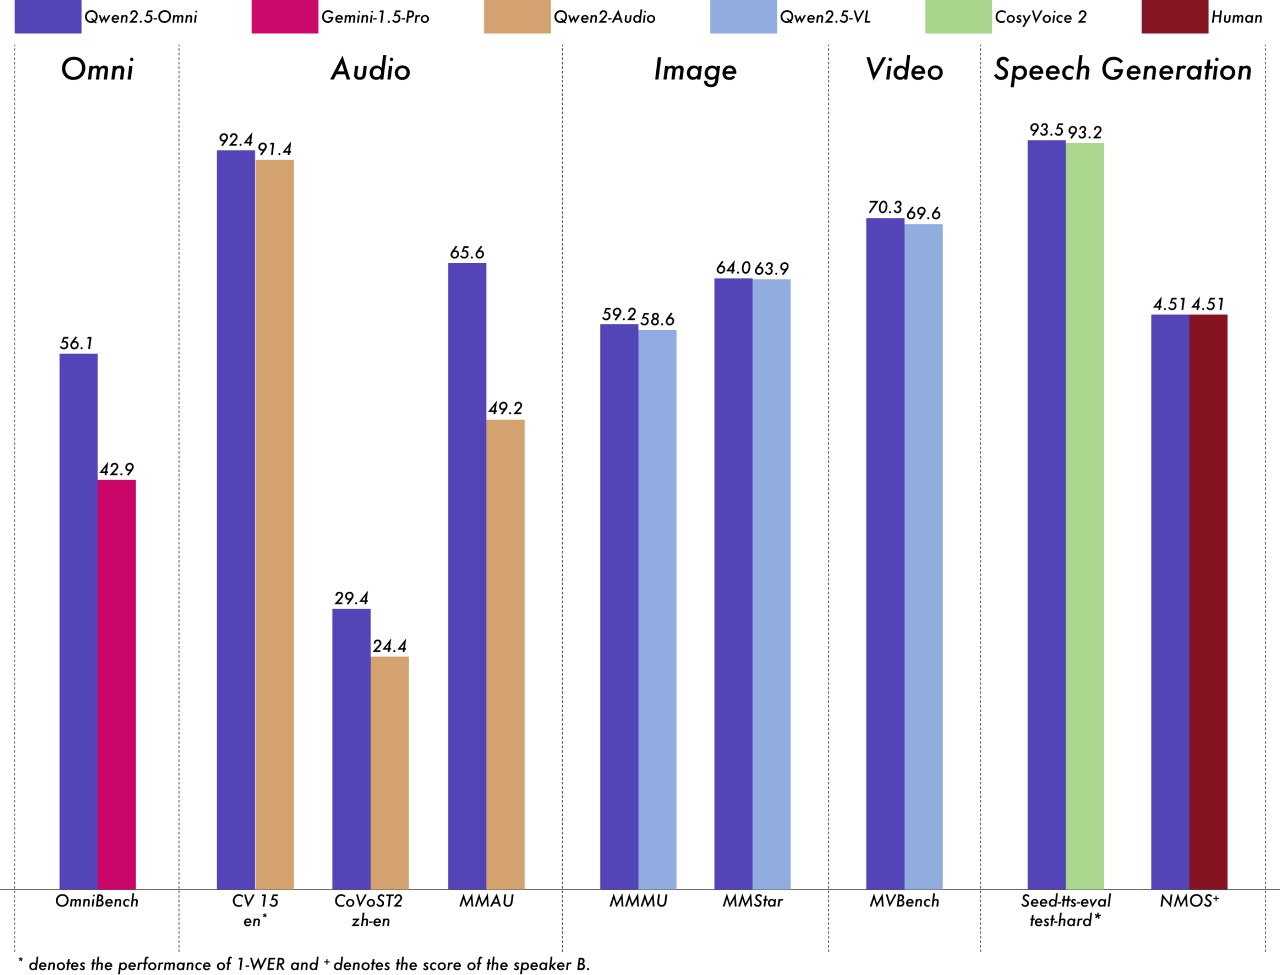
OmniBenchなどのマルチモーダルタスクにおいて、Qwen2.5-Omniは最先端の性能を達成しています。
単一モーダルタスクでは、音声認識(Common Voice)、翻訳(CoVoST2)、音声理解(MMAU)、画像推論(MMMU、MMStar)、動画理解(MVBench)、音声生成(Seed-tts-eval、主観的自然性)などの分野で優れた性能を発揮しています。
関連リンク
Qwen Chat:https://chat.qwenlm.ai
Hugging Face:https://huggingface.co/Qwen/Qwen2.5-Omni-7B
ModelScope:https://modelscope.cn/models/Qwen/Qwen2.5-Omni-7B
DashScope:https://help.aliyun.com/zh/model-studio/user-guide/qwen-omni
GitHub:https://github.com/QwenLM/Qwen2.5-Omni
デモ体験:https://modelscope.cn/studios/Qwen/Qwen2.5-Omni-Demo









