
 脚本プランナー▸
 AIアプリ
 AIニュース
PDF-Craft:スキャン書籍PDFをMarkdown/EPUBに変換するツール
小编 ·

PDF-Craft:スキャン書籍PDFをMarkdown/EPUBに変換するツール
PDF-Craftとは?
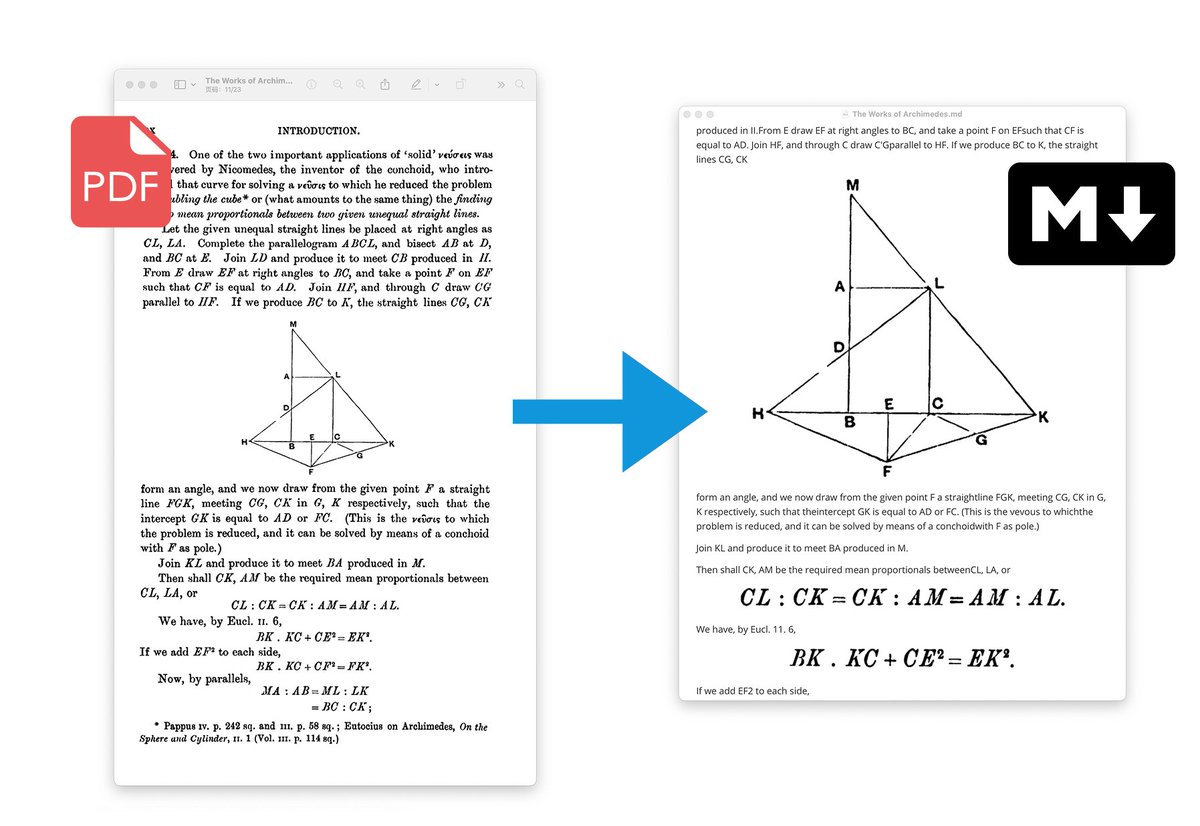
PDF-Craftは、PDFファイルを処理するためのオープンソースプロジェクトで、スキャンした書籍のPDFをMarkdownまたはEPUB形式に変換することに焦点を当てています。OCR技術によって文字を認識し、aiアルゴリズムを利用してテキストを抽出し、ヘッダーやフッターなどの要素をフィルタリングして、構造化されたコンテンツを生成します。ローカルでの計算とLLM支援機能をサポートしており、学術論文、小冊子、長編書籍の形式変換に適しています。
PDF-Craftの主な特徴
形式変換:
PDFをMarkdown形式に変換でき、論文や小冊子に適しています。
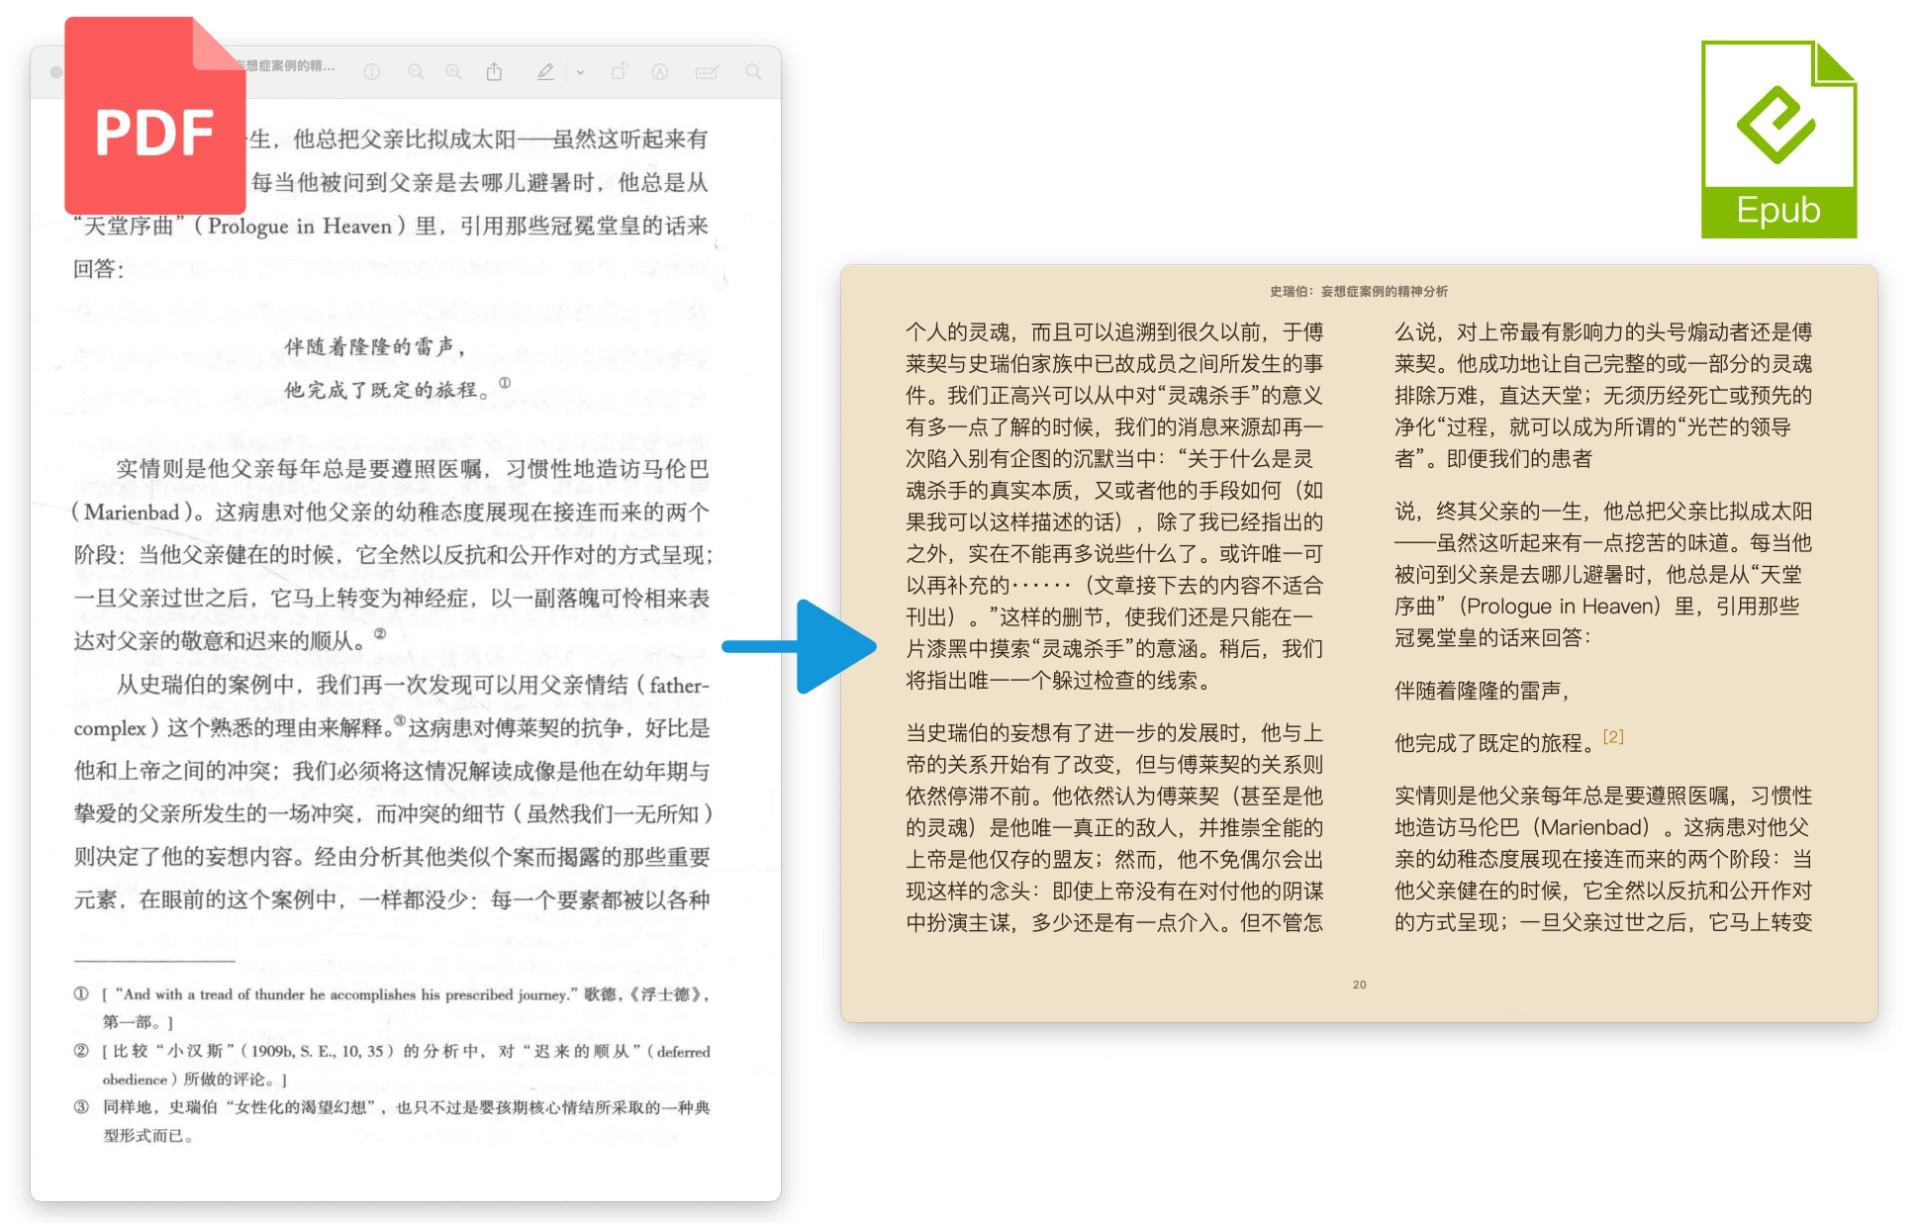
100ページを超える場合は、ローカルOCRとクラウドLLM処理を組み合わせて、ディレクトリ付きの章分けされたEPUBを生成します。
スマート抽出:
DocLayout-YOLOと独自アルゴリズムを使用して本文を抽出し、ヘッダー、フッター、脚注、ページ番号などの要素をフィルタリングします。
ページをまたぐ場合、アルゴリズムが前後の文脈の接続を処理します。
OCR認識:
OnnxOCRを使用して文字認識を行い、図、表、数式のスクリーンショットをサポートし、出力ファイルに直接挿入します。
読み順序の最適化:
layoutreaderを通じて、人間の読書習慣に合った順序を決定します。
LLM支援:
EPUB変換プロセスでは、LLM(DeepSeekなど)を通じて注釈や引用情報を読み取り、EPUBに表示します。
LLMはOCRエラーをある程度修正することもできます。
ローカル実行:
CPUとGPUアクセラレーションをサポートし、ネット接続なしでほとんどの操作を完了できます。
PDF-Craftの使用シーン
学術研究:スキャンした学術論文をMarkdownまたはEPUB形式に変換し、編集や閲覧を容易にします。
電子書籍制作:スキャンした書籍をEPUB形式に変換し、ディレクトリと章を含む電子書籍を生成します。
文書処理:PDF内のテキストや画像を抽出し、更なる編集やアーカイブに利用します。
PDF-Craftの使用方法
1. インストール:Python 3.10以上が必要で、CUDAアクセラレーションをサポートします。
2. PDFからMarkdownへの変換:
from pdf_craft import PDFPageExtractor, MarkDownWriter
extractor = PDFPageExtractor(device="cpu", model_dir_path="/path/to/model")
with MarkDownWriter(markdown_path, "images", "utf-8") as md:
    for block in extractor.extract(pdf="/path/to/pdf"):
        md.write(block)
3. PDFからEPUBへの変換:
from pdf_craft import PDFPageExtractor, LLM, analyse, generate_epub_file
extractor = PDFPageExtractor(device="cpu", model_dir_path="/path/to/model")
llm = LLM(key="sk-XXXXX", url="https://api.deepseek.com", model="deepseek-chat")
analyse(llm=llm, pdf_page_extractor=extractor, pdf_path="/path/to/pdf", analysing_dir_path="/path/to/analysing", output_dir_path="/path/to/output")
generate_epub_file(from_dir_path="/path/to/output", epub_file_path="/path/to/output.epub")
githubプロジェクト:https://github.com/oomol-lab/pdf-craft









