
 脚本プランナー▸
 AIアプリ
 AIニュース
OpenAIのGPT-4oに大規模アップデート ― ChatGPTに画像生成・編集機能を追加
小编 ·

OpenAIのGPT-4oに大規模アップデート ― ChatGPTに画像生成・編集機能を追加
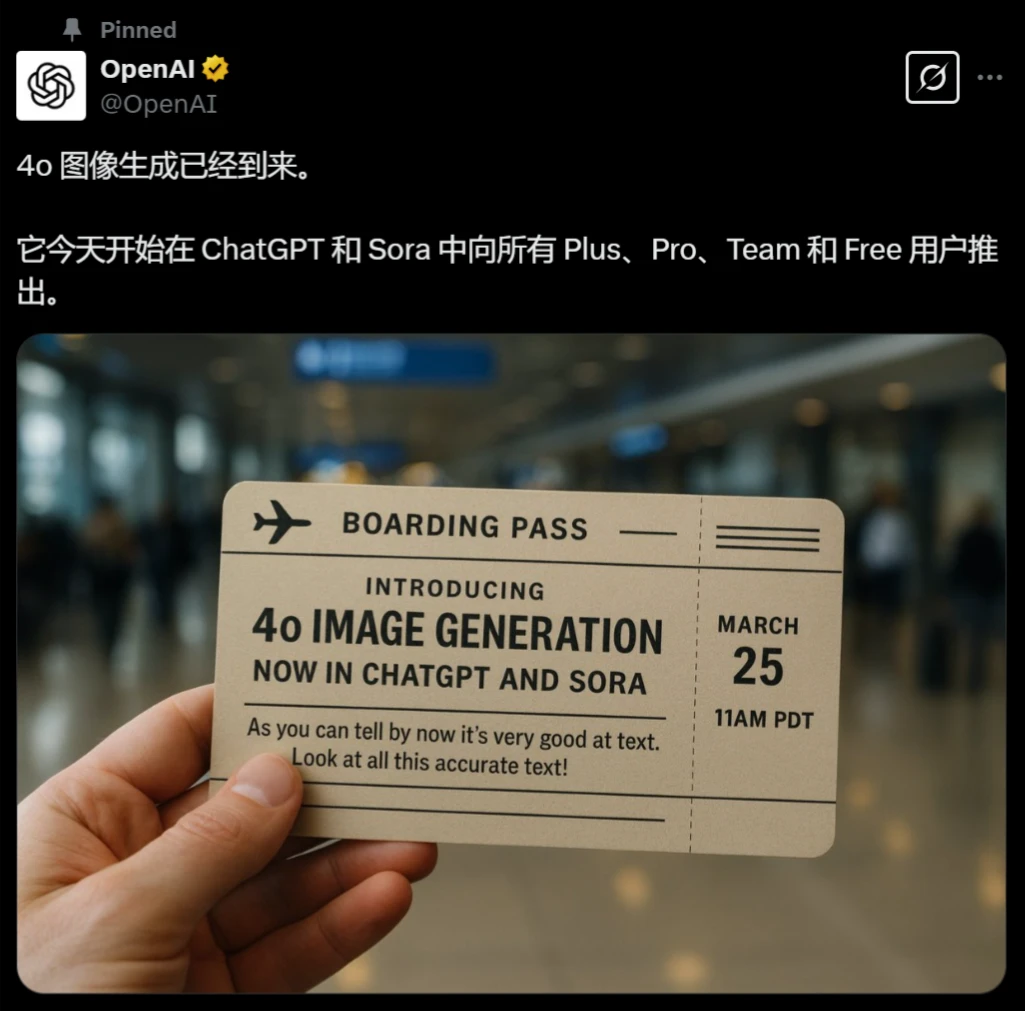
Openaiは2025年3月25日、GPT-4oモデルに画像編集および視覚生成機能を正式に統合すると発表しました。これによりユーザーは対話形式で画像を生成したり、既存の視覚コンテンツを修正したり、さらにはインフォグラフィック、メニュー、地図などの複雑な資料をデザインしたりすることが可能になります。
機能の特徴:
リアルタイム反復:ユーザーは画像リクエストをリアルタイムで反復処理できます。例えば「都市にいるカタツムリ」の生成を要求した後、背景を変更したり小物を追加したりしてシーンを細部まで作り込むことができます。
複雑な指示の処理:このシステムはより複雑な画像構図の指示を処理できます。
テキストレンダリングの改善:GPT-4oは画像内できれいで構造化されたテキストをレンダリングする面で顕著に向上し、インフォグラフィック、グラフ、ロゴなどの専門的な視覚コンテンツをより適切に生成できるようになりました。
「修正」機能:ユーザーは既存画像に対して「修正」を行い、写真に人物が写っている場合でも前景と背景の要素を編集することができます。
パフォーマンスと速度
GPT-4oは画像リクエストの処理速度において前身であるDALL·E 3より遅いものの、生成される画像がより正確で詳細になっています。画像生成には最大1分かかる場合があります。
データトレーニング
OpenAIは、GPT-4oの画像能力のトレーニングには「公開されているデータ」と、Shutterstockなどのパートナーからの独自コンテンツが使用されたと述べています。
技術的な改善
マルチモーダル生成:GPT-4oの画像ジェネレーターはテキストジェネレーターと同じモデルに統合されており、テキストと画像をより適切に組み合わせることができます。
自己回帰的な生成方式:DALL-E 3などの拡散モデルとは異なり、GPT-4oは自己回帰方式を採用し、左から右へ、上から下へ段階的に画像を生成します。これがおそらくテキストレンダリングとオブジェクト結合能力がより優れている理由です。
この機能アップデートは現在、OpenAIの月額200ドルのProプラン購読ユーザーに開放されており、その後無料およびPlusティアのユーザー、そしてOpenAI API経由の開発者にも展開される予定です。
詳細情報:https://openai.com/index/introducing-4o-image-generation/









