
 脚本プランナー▸
 AIアプリ
 AIニュース
KDTalker:音声信号からリアルな表情・動作の動画を生成
小编 ·

KDTalker:音声信号からリアルな表情・動作の動画を生成
KDTalkerとは?
KDTalkerは、オーディオ駆動で動的なポートレートを生成するツールであり、入力されたオーディオ信号に基づいてリアルな表情と動作を生成することができます。KDTalkerは、暗黙的なキーポイント技術、時空間拡散モデル、ポーズの多様性などの特徴を備えています。仮想現実、ソーシャルメディア、ビデオ会議など、さまざまなシーンに適しています。簡単な環境準備とコマンドライン操作により、ユーザーは高品質な動的ポートレート動画を迅速に生成することができます。
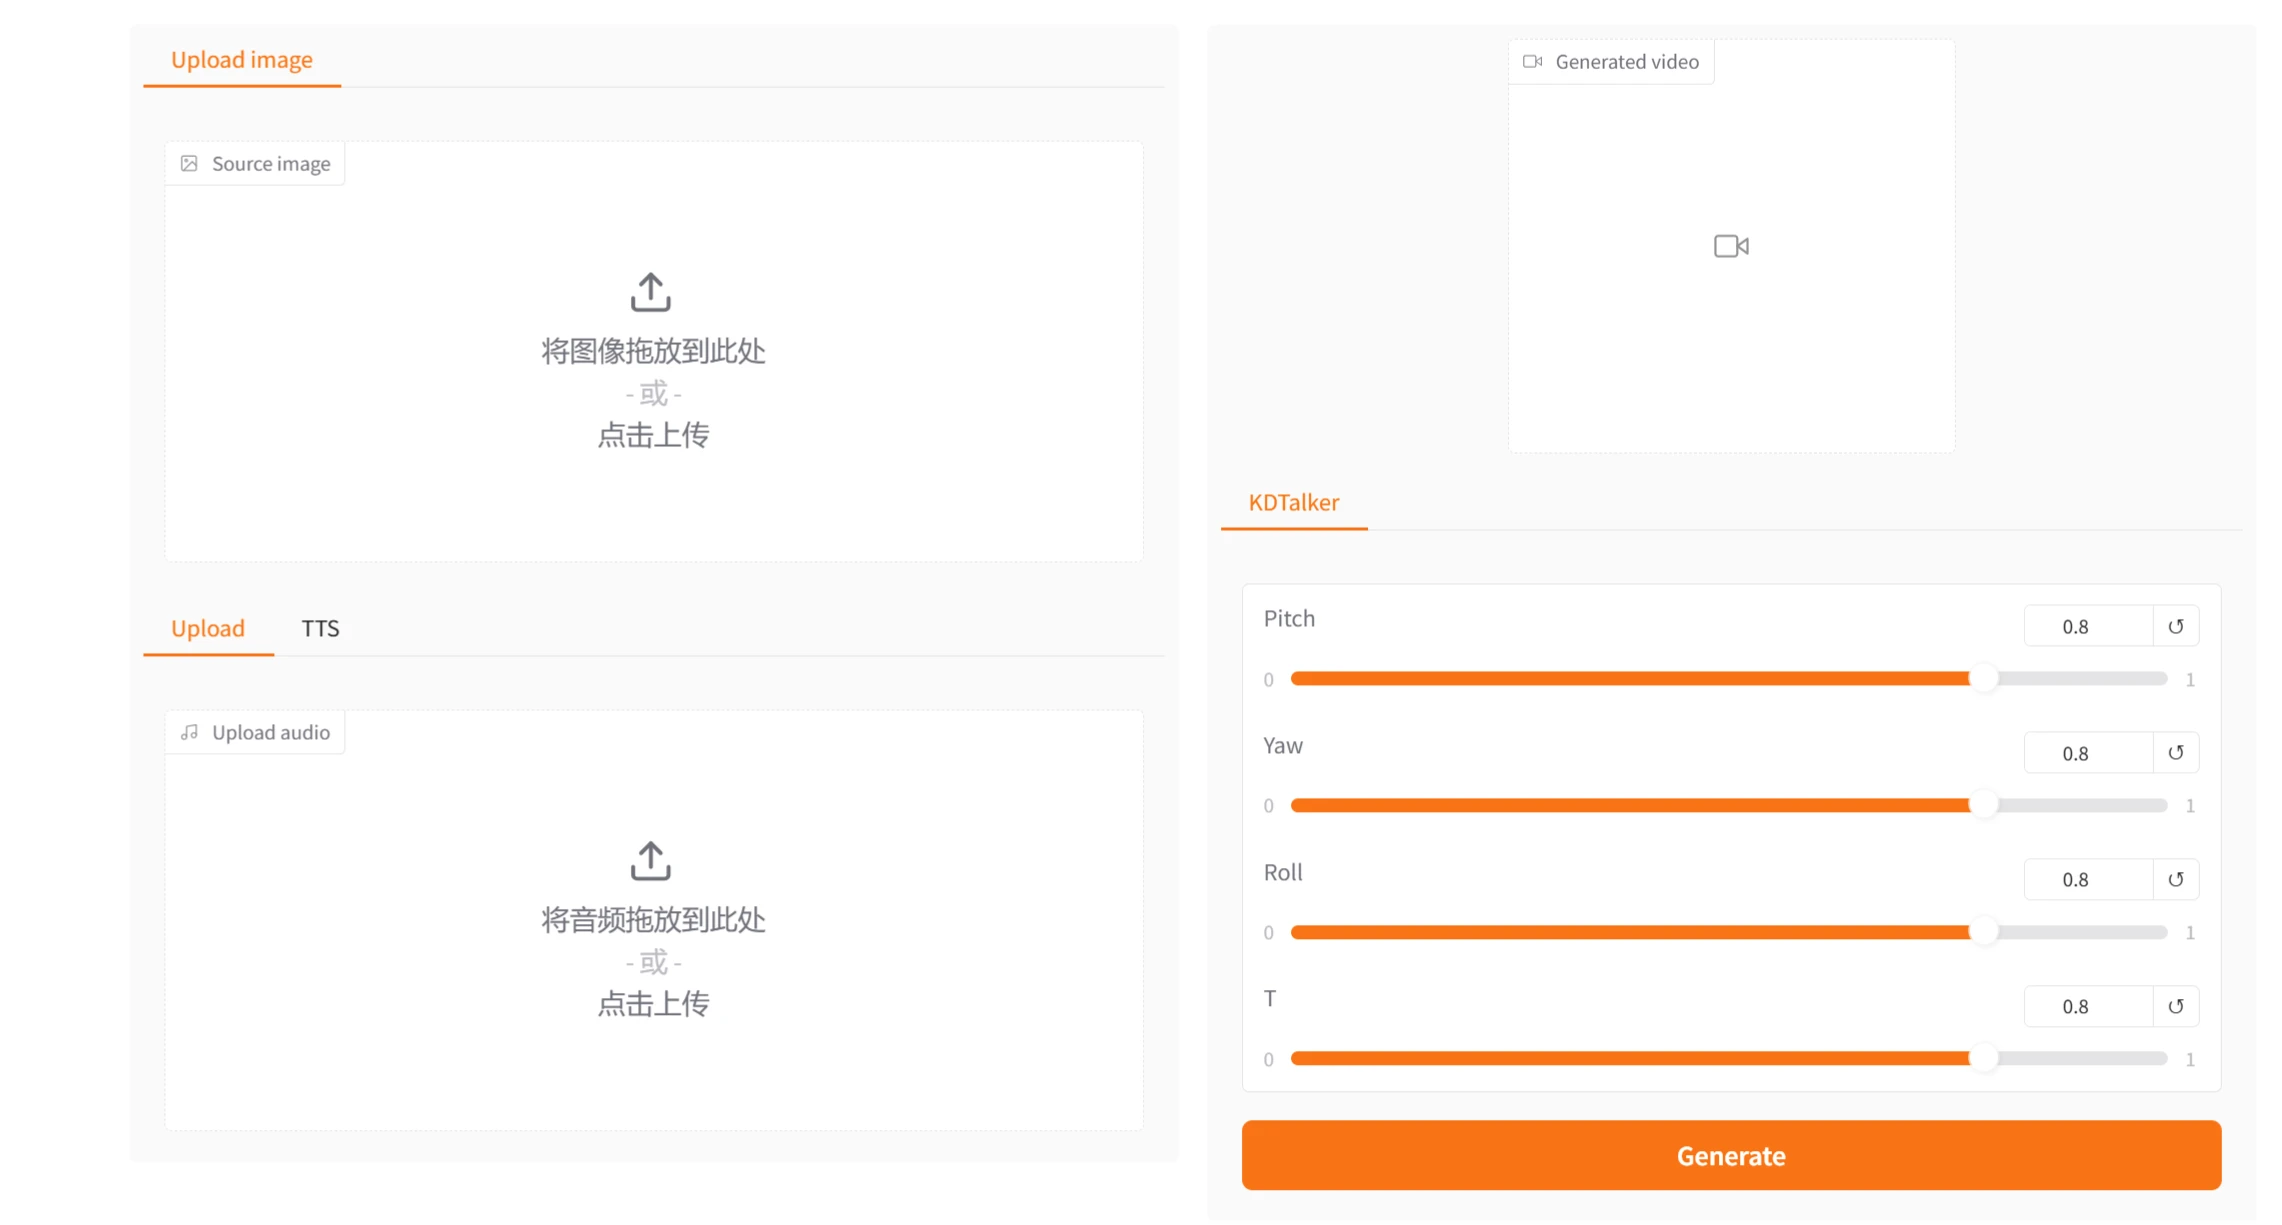
KDTalkerの主な機能
暗黙的なキーポイント技術:
暗黙的なキーポイントを利用して表情や動作の微妙な変化を捉え、オーディオと顔の動作の関係をより自然に反映します。
従来の明示的なキーポイント方法と比較し、暗黙的なキーポイントは明示的なアノテーションの複雑さやエラーを回避できます。
時空間拡散モデル:
時空間拡散モデルを組み合わせることで、より滑らかで连贯した動的効果を生成し、同時に画質と安定性を維持します。
時空間拡散モデルにより、動画シーケンスにおける時間的な連続性をより適切に処理できます。
ポーズの多様性:
複数のポーズ生成をサポートしており、オーディオ内容に応じてキャラクターの姿勢を動的に調整し、生成結果の多様性と自然さを向上させます。
ユーザーは異なるポーズスタイルを指定でき、より個別化された動的ポートレートを生成できます。
高い効率性:
最適化されたモデル設計と効率的な計算フローにより、この技術は単一のRTX4090またはRTX3090グラフィックカードで動作し、高い実用性と拡張性を備えています。
高品質な生成:
生成される動的ポートレートは高い解像度とリアルさを持ち、高品質な動画生成のニーズを満たします。
事前学習済みモデルと最適化された推論フローにより、生成結果の安定性と一貫性を確保します。
KDTalkerの応用シナリオ
仮想現実(VR)および拡張現実(AR):
VRおよびARアプリケーションにおいて、KDTalkerはリアルな仮想キャラクターの動的ポートレートを生成し、ユーザー体験を向上させます。
例えば、バーチャル会議では、ユーザーはオーディオ駆動によって自分の動的ポートレートを生成でき、遠隔コミュニケーションをより自然にすることができます。
ソーシャルメディアおよび動画コンテンツ制作:
ユーザーは自分の写真とオーディオをKDTalkerに入力し、ソーシャルメディアでの共有用の個別化された動的ポートレート動画を生成できます。
コンテンツ制作者はこの技術を利用して興味深い動画コンテンツを生成し、動画の魅力を高めることができます。
ビデオ会議:
ビデオ会議では、ネットワークの不安定さにより映像のカクつきやぼやけが発生することがあります。KDTalkerはオーディオ駆動によってスムーズな動的ポートレートを生成でき、低帯域環境でも良好な視覚効果を維持します。
エンターテインメントおよびゲーム:
ゲームやエンターテインメントアプリケーションにおいて、KDTalkerは仮想キャラクターの動的な表情や動作を生成し、ゲームの没入感を高めます。
例えば、ロールプレイングゲームでは、プレイヤーはオーディオ駆動によって自分のキャラクターの動的ポートレートを生成できます。
教育および研修:
教育や研修のシナリオにおいて、KDTalkerは教師やトレーナーの動的ポートレートを生成し、オンラインコースや研修動画に使用できます。
オーディオ駆動によって生成された動的ポートレートにより、教育内容がより生き生きとし、学習効果を高めることができます。
KDTalkerの使用方法
1. 環境準備
ハードウェア要件:RTX4090またはRTX3090グラフィックカードの使用を推奨します。
ソフトウェア依存関係:
git、conda、FFmpegをインストールします。
コードをクローンし、Python環境を作成します:
git clone https://github.com/chaolongy/KDTalker
cd KDTalker
# conda環境を作成して有効化
conda create -n KDTalker python=3.9
conda activate KDTalker
# PyTorchとその他の依存関係をインストール
conda install pytorch==2.3.0 torchvision==0.18.0 torchaudio==2.3.0 pytorch-cuda=11.8 -c pytorch -c nvidia
pip install -r requirements.txt
2. 事前学習済み重みのダウンロード
Google DriveまたはHugging Faceから事前学習済み重みファイルをダウンロードし、./pretrained_weightsおよび./ckptsディレクトリに配置します。
ディレクトリ構造が以下のようになっていることを確認します:
pretrained_weights
├── insightface
│   └── models
│       └── buffalo_l
│           ├── 2d106det.onnx
│           └── det_10g.onnx
└── liveportrait
    ├── base_models
    │   ├── appearance_feature_extractor.pth
    │   ├── motion_extractor.pth
    │   ├── spade_generator.pth
    │   └── warping_module.pth
    ├── landmark.onnx
    └── retargeting_models
        └── stitching_retargeting_module.pth
3. 推論の実行
以下のコマンドを使用して推論スクリプトを実行し、動的ポートレート動画を生成します:
python inference.py -source_image ./example/source_image/WDA_BenCardin1_000.png -driven_audio ./example/driven_audio/WDA_BenCardin1_000.wav -output ./results/output.mp4
-source_image:入力ソース画像のパスを指定します。
-driven_audio:入力駆動オーディオのパスを指定します。
-output:出力動画の保存パスを指定します。
プロジェクトアドレス:https://github.com/chaolongy/KDTalker
DEMO:https://kdtalker.com/









