
 脚本プランナー▸
 AIアプリ
 AIニュース
Fin-R1:Qwen2.5ベースの金融推論型大規模言語モデル
小编 ·

Fin-R1:Qwen2.5ベースの金融推論型大規模言語モデル
Fin-R1とは?
Fin-R1 は、上海財経大学統計・データサイエンス学部の張立文教授チーム(SUFE-aiFLM-Lab)と財跃星辰が共同開発した、金融分野向けの推論型大規模言語モデルです。Fin-R1 モデルは Qwen2.5-7B-Instruct をベースモデルとし、DeepSeek-R1 のフレームワークを用いた「データ蒸留」と「二段階品質スクリーニング」により、高品質な思考連鎖データでの教師ありファインチューニングと強化学習を通じて、金融分野におけるデータの断片化、推論ロジックの制御困難、業務汎化能力の不足といった課題を解決し、金融業界のインテリジェント化変革を強力に支援します。
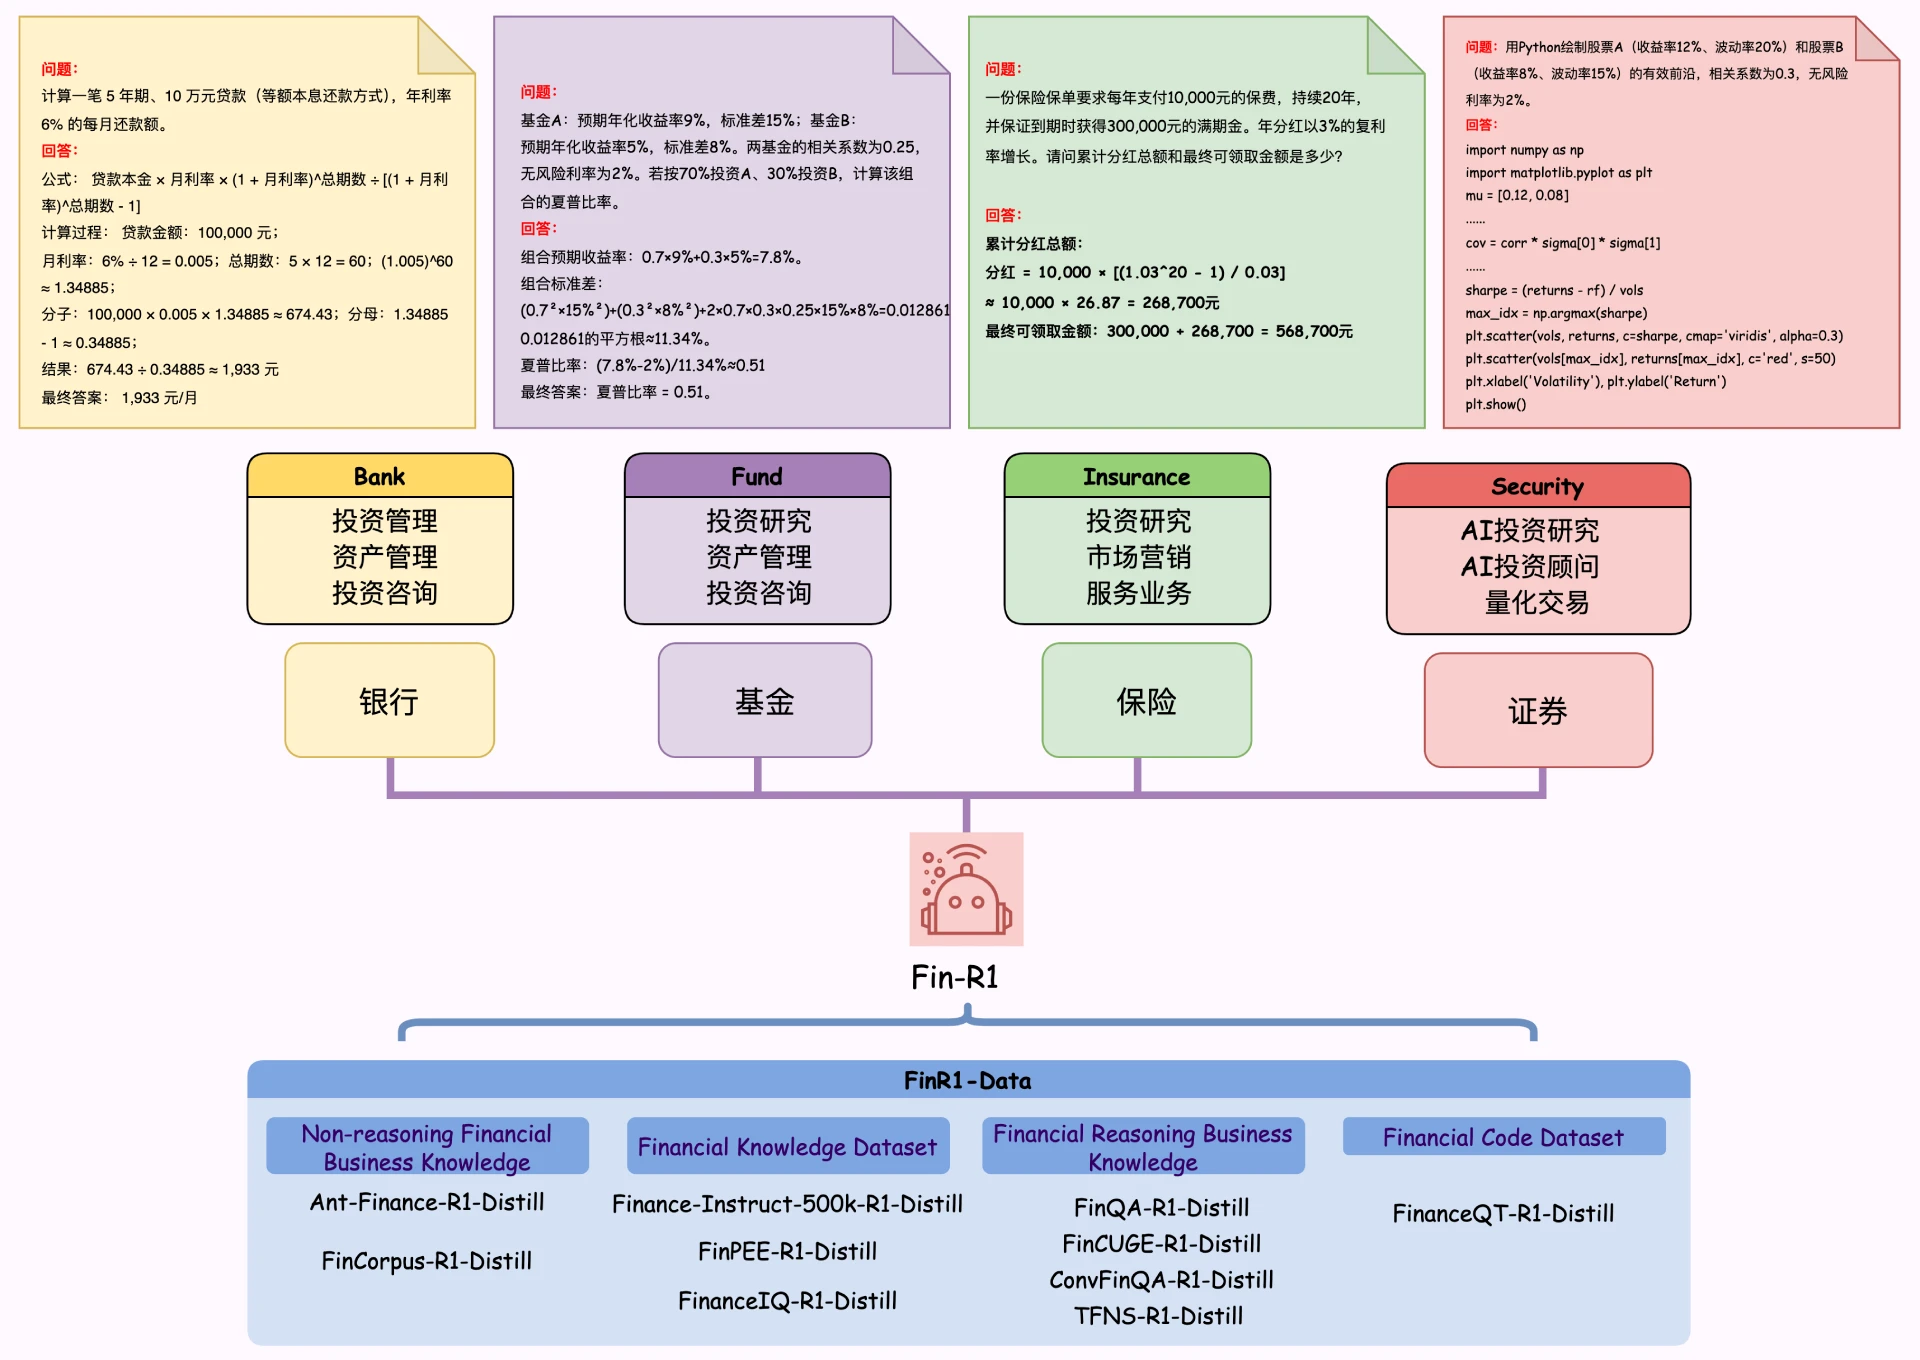
モデルアーキテクチャ
Fin-R1 は二段階アーキテクチャを採用して学習を行います:
データ生成段階:データ蒸留とスクリーニング手法により、複数の権威あるデータソースから高品質な金融推論データセット Fin-R1-Data を構築します。
モデル学習段階:Qwen2.5-7B-Instruct モデルをベースとし、教師ありファインチューニング(SFT)と強化学習(RL)によって学習を行います。
Fin-R1 データセットの特徴
規模と品質:Fin-R1-Data には約 60,091 条の完全な思考連鎖(CoT)が含まれており、中英両語にわたる金融分野の多次元的な専門知識をカバーしています。
モジュラー設計:データセットは金融コード、金融専門知識、金融非推論型業務知識、金融推論型業務知識の 4 つのモジュールに分けられています。
Fin-R1 の主な特徴
専門分野:金融推論に特化し、金融コード、専門知識、業務知識など複数の次元をカバーしています。
データ駆動:高品質な金融推論データセット Fin-R1-Data に基づき学習されており、約 60,091 条の完全な思考連鎖を含みます。
学習手法:教師ありファインチューニング(SFT)と強化学習(RL)を組み合わせた方式を採用し、金融推論タスクにおけるモデルの正確性と信頼性を確保しています。
軽量設計:パラメータ数はわずか 70 億ですが、卓越した性能を発揮します。
パフォーマンス
権威ある評価:金融分野における権威ある評価で、平均スコア 75.2 点、2 位にランクインしました。
タスク別成績:FinQA および ConvFinQA タスクでそれぞれ 76.0 点、85.0 点を取得し、参加モデル中 1 位となりました。
汎化能力:他の金融ベンチマークテストにおいても、タスクを横断する強力な汎化能力を示しています。
Fin-R1 の応用
金融コード:金融モデルやアルゴリズム、分析タスクを実装するためのプログラミングコード。
金融計算:定量分析と計算を行い、金融意思決定の基礎を提供します。
金融セキュリティ・コンプライアンス:金融犯罪を防止し、業務操作が規制要件に適合していることを確認します。
スマートリスク管理:AI とビッグデータ技術を活用して金融リスクを識別・管理します。
ESG 分析:企業の環境、社会、ガバナンスにおけるパフォーマンスを評価します。
Fin-R1 の利用手順
モデルのダウンロード:Hugging Face のページからモデルの重みをダウンロードします。
サービスの起動:vllm ツールを使用してモデルサービスを起動します。
推論の実行:OpenAI API 形式を介してモデルを呼び出し、推論を行います。
Fin-R1 関連リンク
モデルダウンロード:https://huggingface.co/SUFE-AIFLM-Lab/Fin-R1
論文:https://arxiv.org/pdf/2503.16252









