
 脚本プランナー▸
 AIアプリ
 AIニュース
OpenAIの音声モデルGPT-4o-transcribe、GPT-4o-mini-transcribe、GPT-4o-mini-ttsの特徴・価格・ユースケース
小编 ·

OpenAIの音声モデルGPT-4o-transcribe、GPT-4o-mini-transcribe、GPT-4o-mini-ttsの特徴・価格・ユースケース
Openaiは次世代音声モデルを発表し、開発者により強力な音声インタラクション能力を提供し、音声エージェントの開発をサポートしています。これらのモデルには、2つの音声テキスト変換モデル(gpt-4o-transcribeおよびgpt-4o-mini-transcribe)と、1つのテキスト音声変換モデル(gpt-4o-mini-tts)が含まれています。それぞれどのような特徴があるのでしょうか?
1. GPT-4o-transcribe(音声テキスト変換モデル)
特徴:
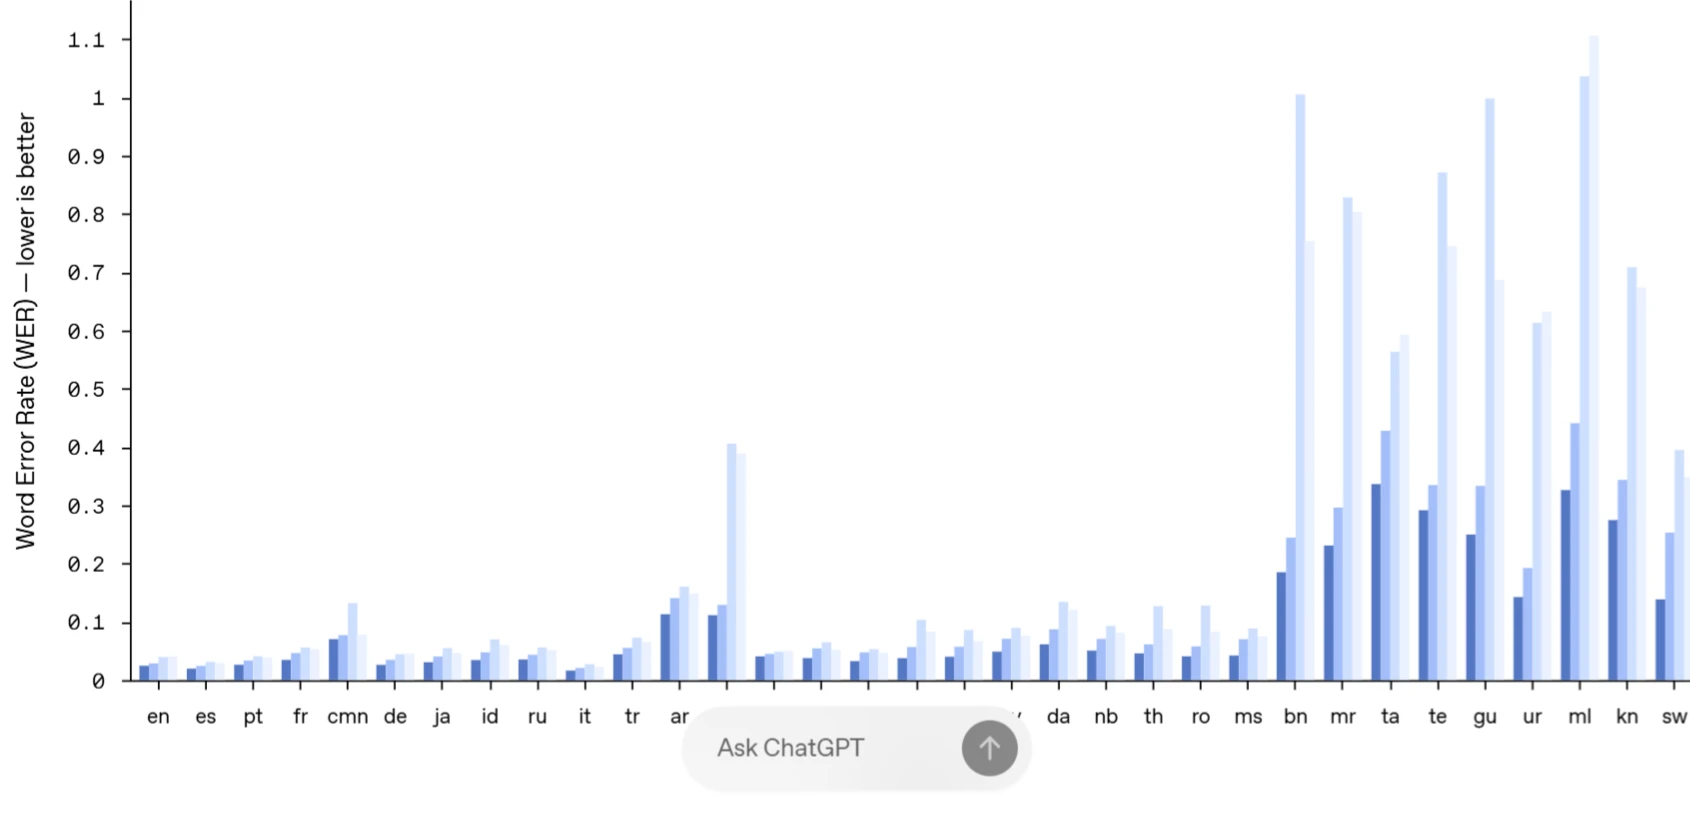
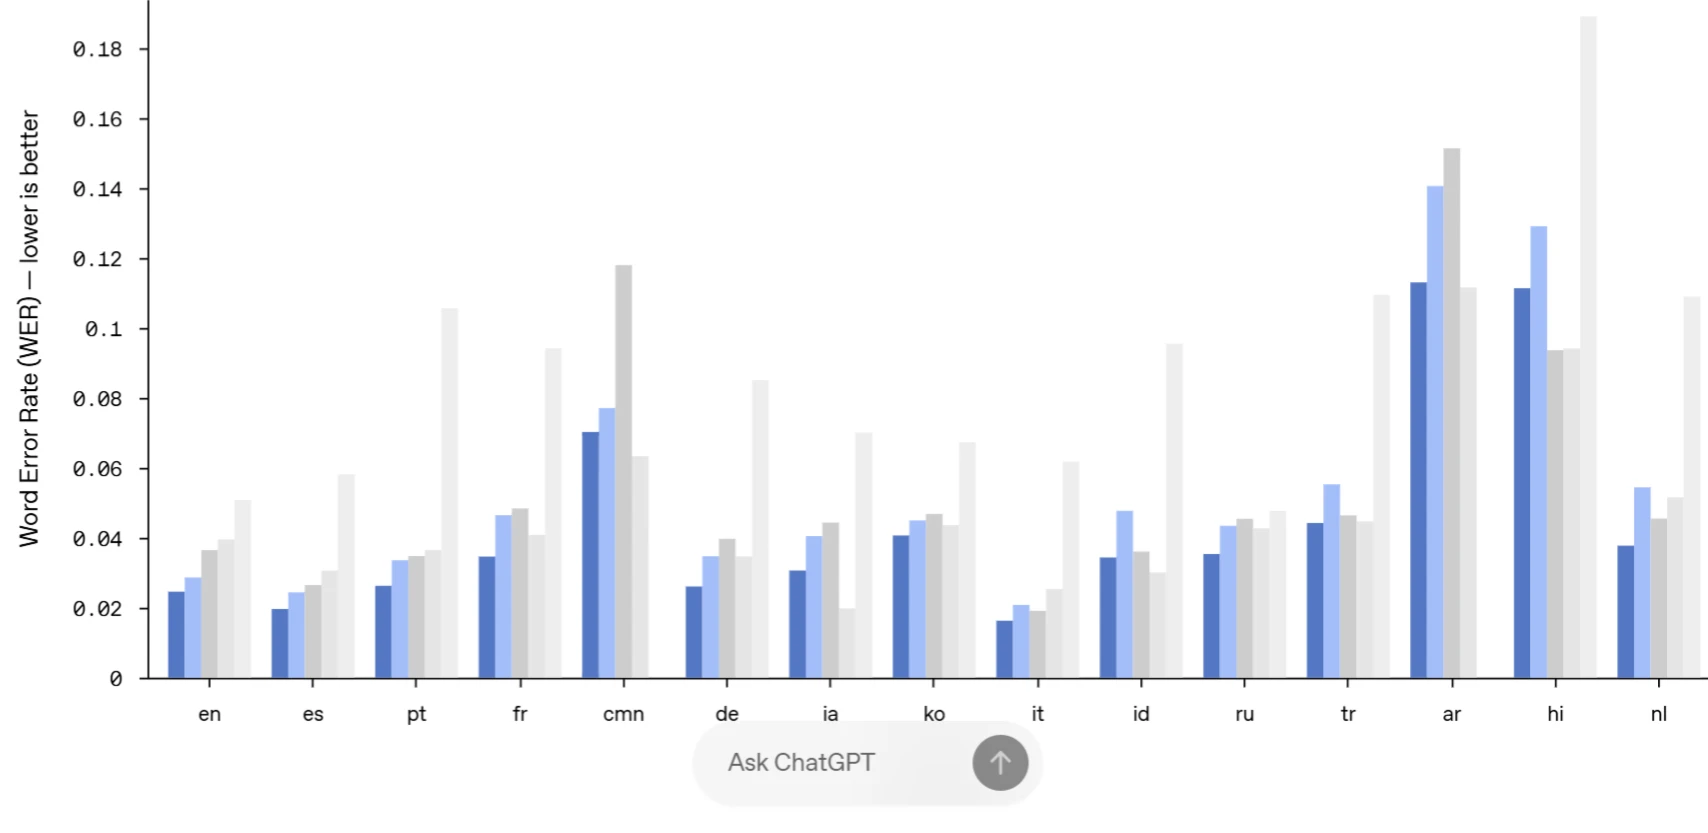
高精度文字起こし:多様で高品質なオーディオデータセットを用いて長時間のトレーニングを行うことで、音声の微妙なニュアンスをより正確に捉え、誤認識を削減し、文字起こしの信頼性を大幅に向上させます。
複雑なシーンへの適応:アクセント、話速、環境ノイズなどに対して高い適応性を持ち、背景に騒音がある場合や話者のアクセントが強い場合、話速が速い場合でも、音声を正確に認識して文字起こしすることができます。
長時間の音声処理能力:比較的長い音声入力の処理が可能で、長時間の連続した音声文字起こしが必要なシーンに適しています。
使用シーン:
会議の記録:会議での音声内容をリアルタイムまたは事後にテキストへ文字起こしし、会議後の整理や振り返りを容易にして業務効率を向上させます。
インタビューの記録:ニュース取材や人物インタビューなどのシーンで、取材者の音声内容を迅速かつ正確にテキストへ文字起こしし、その後の編集や公開を容易にします。
音声メモ:ユーザーの音声メモをテキストへ文字起こしし、ユーザーがいつでも確認・整理できるようにします。
カスタマーコールセンター:顧客の音声を正確に認識してテキストへ文字起こしし、カスタマーサービス担当者が顧客のニーズを迅速に把握し適切な対応を行えるようにします。
価格:
オーディオ入力100万トークンあたり$6.00で、約1分あたり$0.006です。
2. GPT-4o-mini-transcribe(音声テキスト変換モデルの軽量版)
特徴:
高効率・高速:モデルサイズが小さく、演算速度が速いため、短時間で音声文字起こしタスクを完了できます。
低いリソース消費:ハードウェアリソースへの要求が比較的低く、リソースが限られたデバイスでの実行に適しています。
高いコストパフォーマンス:単語誤り率(WER)は完全版モデルよりわずかに高いものの、従来のWhisperモデルよりも優れています。
使用シーン:
モバイルデバイスの音声入力:スマートフォンやタブレットなどのモバイルデバイスで、ユーザーに高速な音声入力文字起こし機能を提供します。例えば、音声によるテキストメッセージ入力などです。
小規模な音声アプリケーション:文字起こし精度の要求が比較的低くないが、高速な応答が必要な小規模な音声アプリケーション、たとえば音声コマンド認識やシンプルな音声メモなどに適しています。
リソースが限られた環境:コンピューティングリソースが限られたシーン、例えば一部の中小企業や個人開発者のプロジェクトにおいて、高効率かつ低コストの音声文字起こしソリューションを提供します。
価格:
オーディオ入力100万トークンあたり$3.00で、約1分あたり$0.003です。
3. GPT-4o-mini-tts(テキスト音声変換モデル)
特徴:
誘導可能性:初めて「誘導可能性」をサポートし、開発者はモデルに「何を話すか」だけでなく「どのように話すか」を制御できます。例えば、音声スタイルを「穏やか」「サーファー」「プロフェッショナル」「中世の騎士」などとプリセットでき、「思いやりのあるカスタマーサービスエージェントのように話してください」といった指示に従って音声スタイルを調整することも可能です。
自然で滑らかな音声:生成される音声は自然で滑らか、表現力豊かで、テキストの内容とプリセットされたスタイルに応じた音声表現が可能です。
多言語サポート:複数言語のテキスト音声変換をサポートし、異なる言語のユーザーのニーズに応えます。
使用シーン:
オーディオブック:テキストの書籍や記事などをオーディオコンテンツに変換し、より生き生きとした興味深い読書体験をユーザーに提供します。
スマートカスタマーサービス:スマートカスタマーサービスシステムに音声合成機能を提供し、カスタマーサービスロボットが自然で表現力豊かな声でユーザーとコミュニケーションできるようにし、ユーザー体験を向上させます。
音声放送:ニュース放送、天気予報、交通情報などのシーンで、テキストコンテンツを音声に変換して放送します。
クリエイティブコンテンツ制作:クリエイティブストーリーテリング、広告制作、映像ナレーションなどの分野で、異なるクリエイティブニーズに応じて特定のスタイルや感情を持つ音声を生成します。
価格:
テキスト入力100万トークンあたり$0.60、オーディオ出力100万トークンあたり$12.00で、約1分あたり$0.015です。
GPT-4o-transcribeなどのモデルは、すでにOpenAIのAPIインターフェースを通じて開発者に開放されており、少量のコードでアプリケーションへの統合が可能です。開発者は機能や環境のニーズに応じて適切なモデルを選択でき、公式サイトで体験することもできます。
公式サイト:http://open ai.fm/
ブログ:https://openai.com/index/introducing-our-next-generation-audio-models/









