
 脚本プランナー▸
 AIアプリ
 AIニュース
OpenAIが新しい音声モデル3種類を発表—音声認識2種と音声合成1種
小编 ·

OpenAIが新しい音声モデル3種類を発表—音声認識2種と音声合成1種
2025 年 3 月 20 日、Openai は 3 つの全新的音声モデルを発表しました。内訳は、2 つの音声テキスト変換モデル(GPT-4o-transcribe および GPT-4o-mini-transcribe)と、1 つのテキスト音声変換モデル(GPT-4o-mini-tts)です。
音声テキスト変換モデル
GPT-4o-transcribe:このモデルは、多様で高品質な音声データセットを用いて長時間トレーニングされており、音声の微妙なニュアンスをより正確に捉え、誤認識を低減させ、転写の信頼性を大幅に向上させています。アクセントの多様性、環境ノイズ、話す速度の変化など複雑なシナリオの処理に適しており、カスタマーコールセンターや会議の記録転写などの分野で活用できます。
GPT-4o-mini-transcribe:これは GPT-4o-transcribe の軽量版で、処理速度が速く、効率に優れています。単語誤り率(WER)は完全版モデルよりわずかに高いものの、従来の Whisper モデルを上回っており、リソースは限られているものの高品質な音声認識を必要とするアプリケーションシナリオにより適しています。
テキスト音声変換モデル
GPT-4o-mini-tts:このモデルは、初めて「誘導性(steerability)」をサポートし、開発者はモデルに「何を話すか」だけでなく「どのように話すか」も制御できます。例えば、音声スタイルを「穏やか」「サーファー」「プロフェッショナル」「中世の騎士」などに設定したり、「思いやりのあるカスタマーサービスエージェントのように話してください」などの指示に従って音声スタイルを調整したりすることも可能です。
技術的イノベーション
実際の音声データセットを用いた事前トレーニングにより、モデルのパフォーマンスを最適化。
蒸留手法の強化により、大モデルから小モデルへの知識伝達を実現。
強化学習により、転写精度を向上させ、「幻覚」現象を低減。
応用シナリオ
コールセンター:より正確な音声認識とより自然な音声合成を提供し、顧客サービス体験を向上させます。
会議記録:会議の音声内容を迅速かつ正確にテキストに転写します。
パーソナライズされたカスタマーサービス:音声スタイルのカスタマイズにより、より温かみと表現力豊かな音声体験を提供します。
クリエイティブなストーリーテリング:物語に生き生きとした音声効果を加えます。
価格
GPT-4o-transcribe の価格は従来の Whisper モデルと同じで、1 分あたり 0.006 ドルです。
GPT-4o-mini-transcribe の価格は 1 分あたり 0.003 ドルです。
GPT-4o-mini-tts の価格は 1 分あたり 1 セントです。
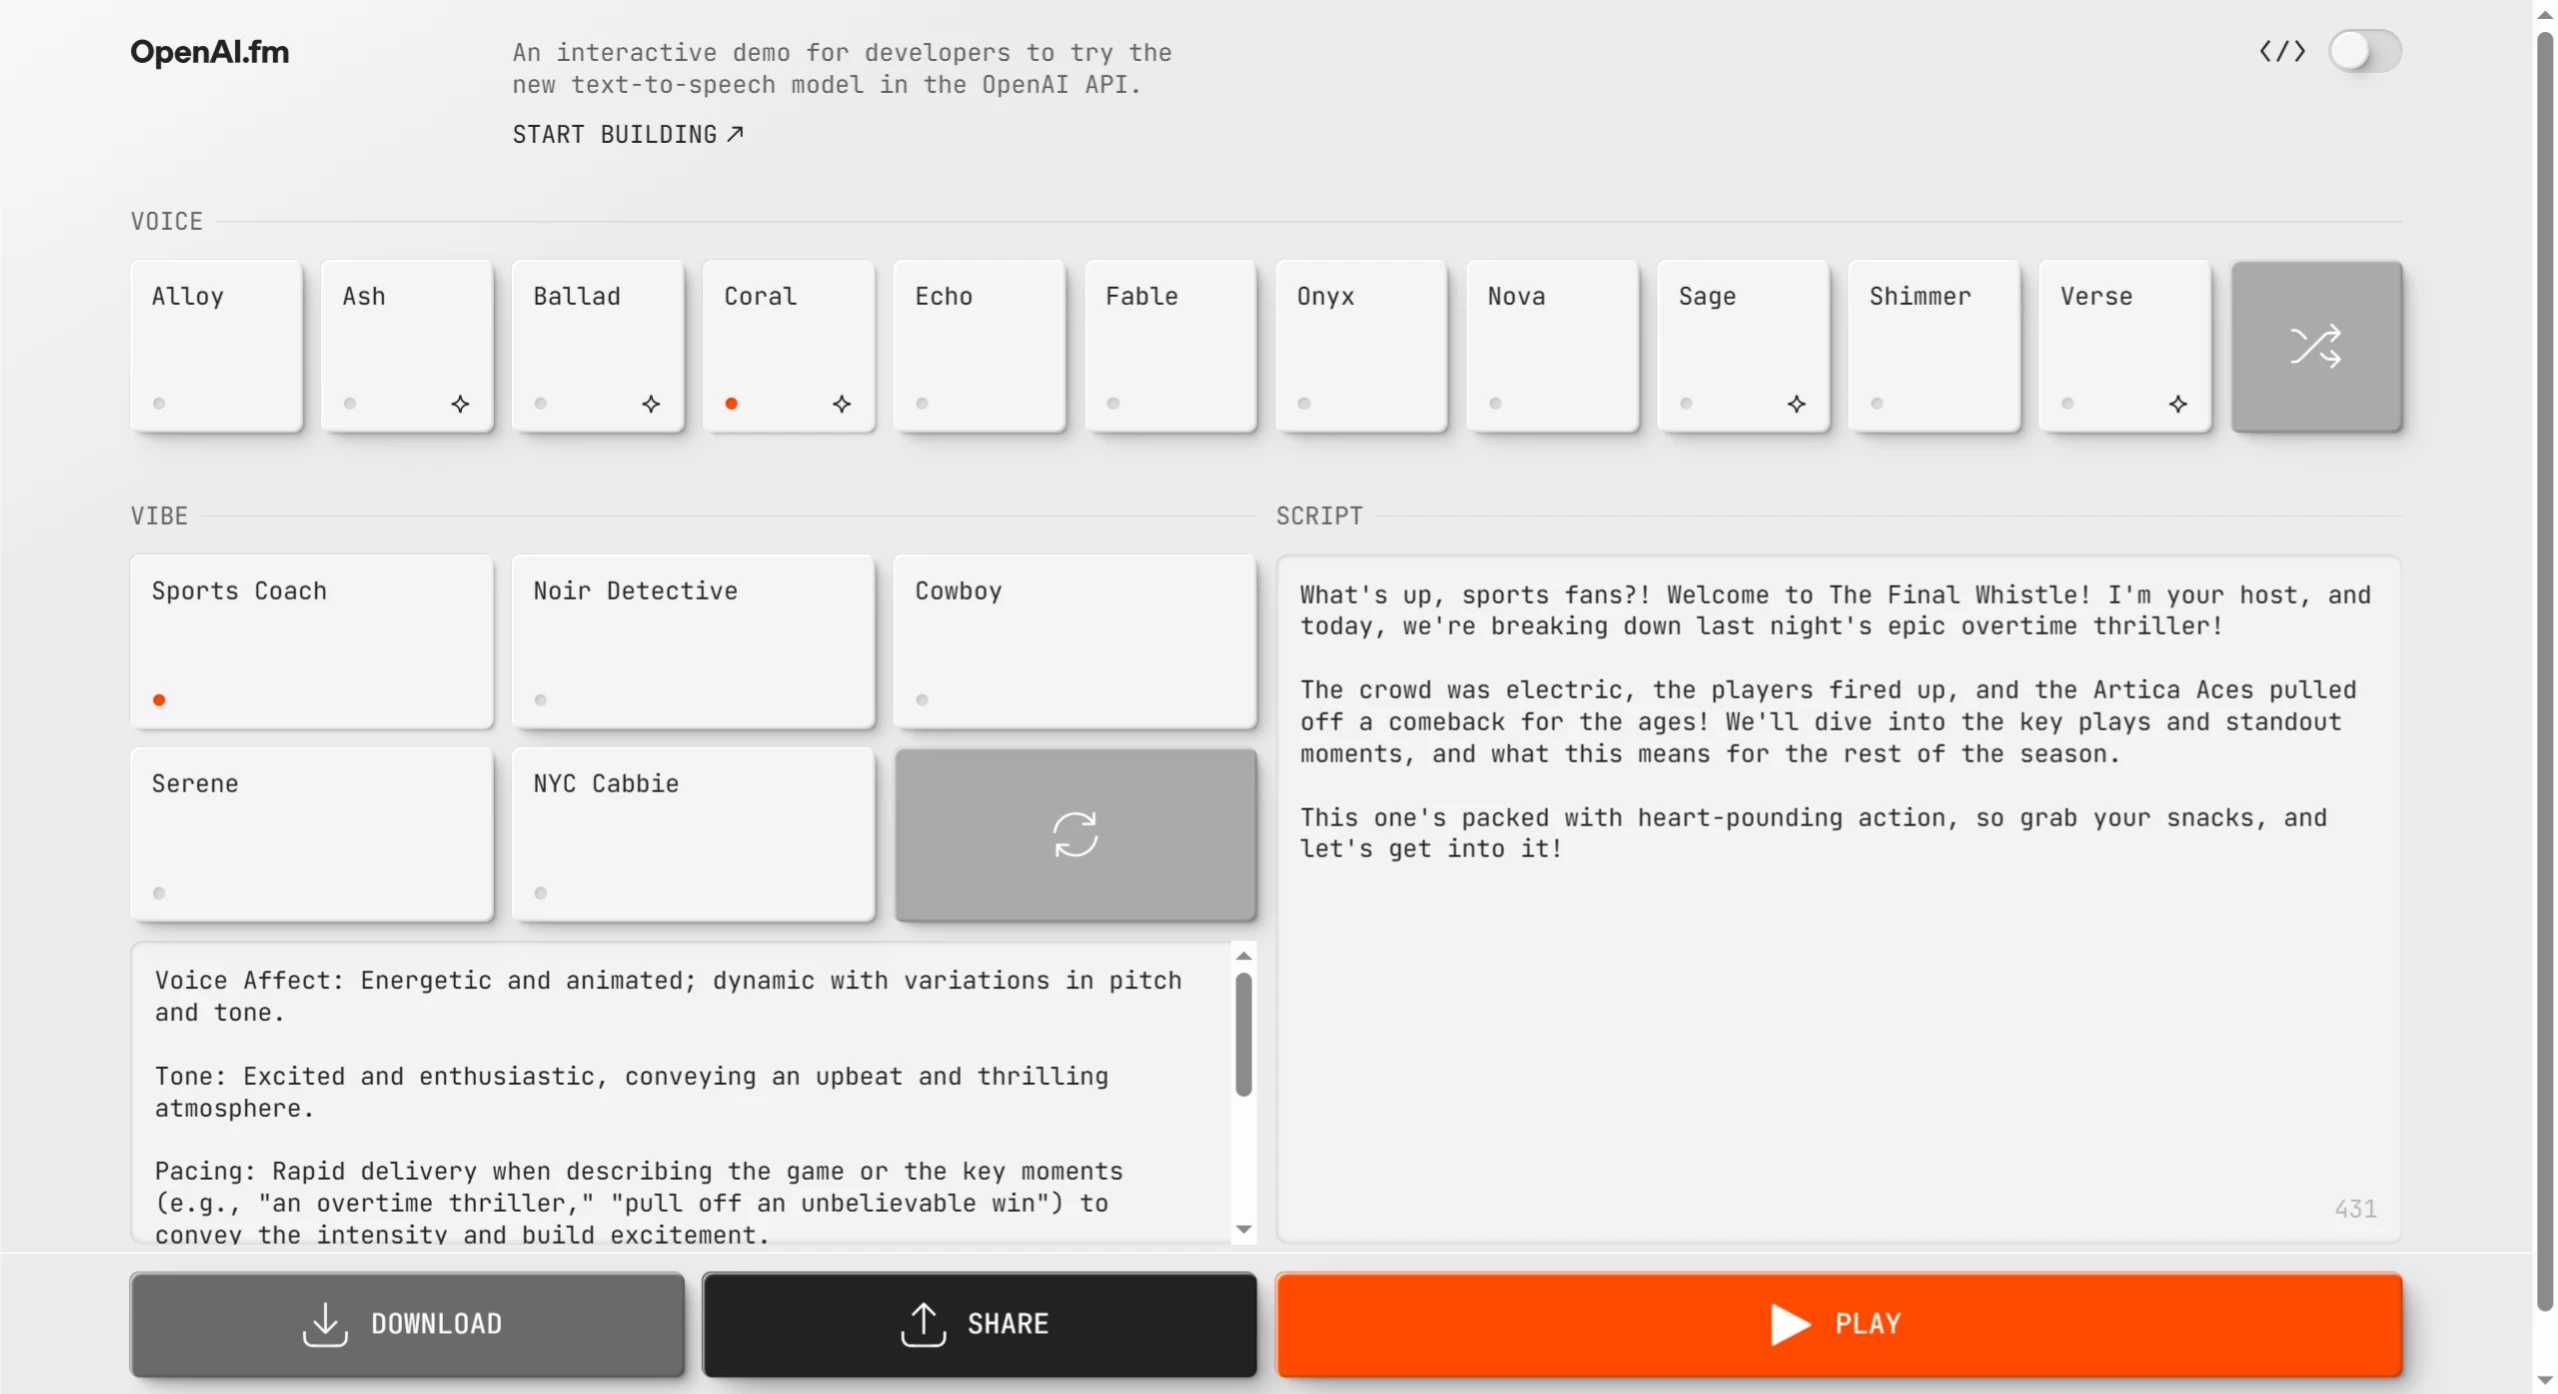
OpenAI 音声モデルのウェブサイト:OpenAI.fm では、人格、トーン、方言、発音などの設定を含む豊富なプリセットテンプレートが提供されています。ユーザーはここで GPT-4o-mini-tts に関連する音声を体験・制作することができます。さらに、OpenAI はアップグレード版の Agent SDK も提供しており、開発者がより便利に音声エージェントを構築できるよう支援しています。
公式サイト:http://openai.fm/
公式ブログ:https://openai.com/index/introducing-our-next-generation-audio-models/









