
 脚本プランナー▸
 AIアプリ
 AIニュース
SmolDocling:複雑なドキュメントを構造化テキストに変換する軽量視覚言語モデル
小编 ·

SmolDocling:複雑なドキュメントを構造化テキストに変換する軽量視覚言語モデル
SmolDoclingとは?
SmolDoclingは、IBM ResearchとHugging Faceが共同で開発した軽量な視覚言語モデルで、エンドツーエンドのマルチモーダル文書変換を目的としています。パラメータ数はわずか256Mで、コンシューマー向けGPU上でも高速に処理でき、1ページあたりの処理時間はわずか0.35秒です。SmolDoclingの核心的なミッションは、任意の画像に含まれる複雑なコンテンツを編集可能な構造化データへと変換することです。
SmolDoclingの機能
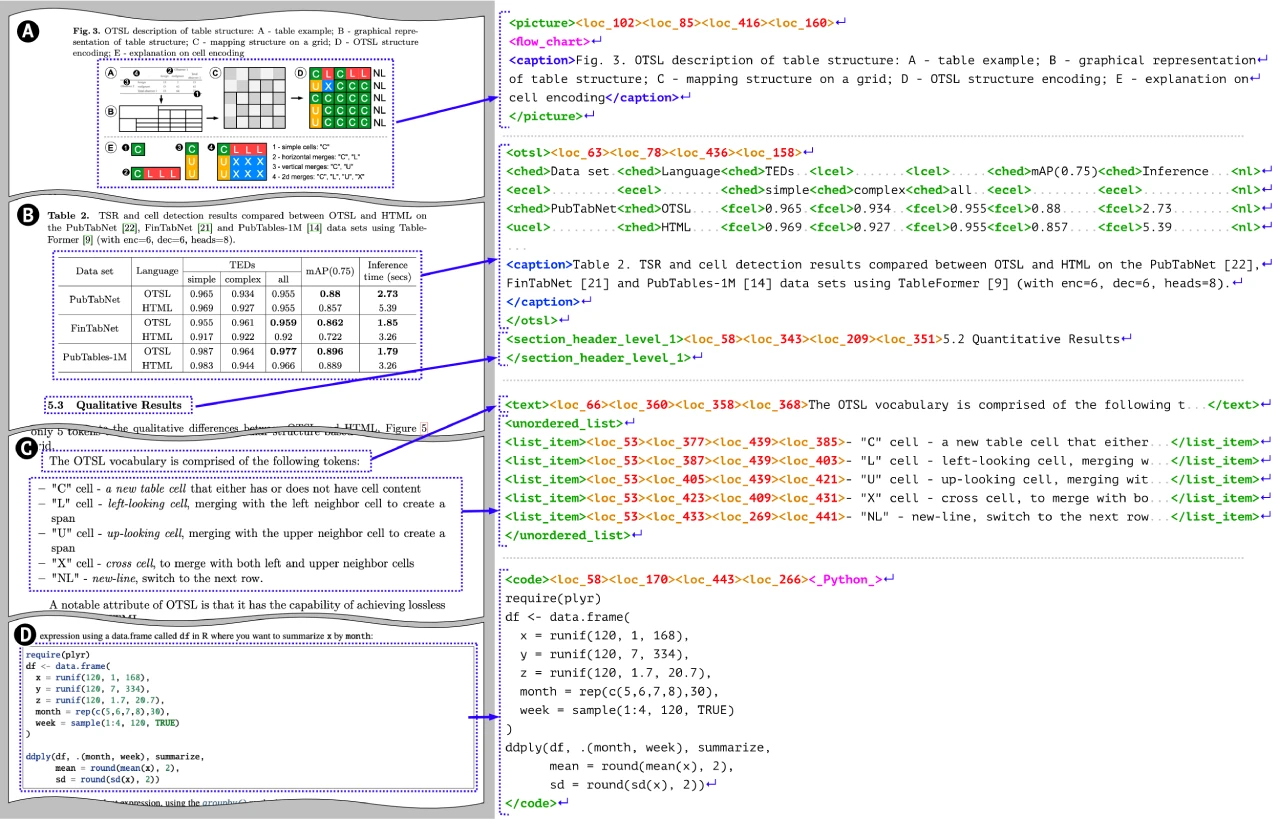
DocTagsによる効率的なマークアップ:DocTagsを導入します。これは、DoclingDocumentsと完全に互換性のある、効率的で簡潔な文書表現方式です。
OCR(光学文字認識):画像から正確にテキストを抽出できます。
レイアウトと位置情報の保持:文書構造と文書要素の境界ボックスを保持します。
コード認識:インデントを含むコードブロックを検出し、フォーマットします。
数式認識:数学的表現を認識し、処理します。
図表認識:図表のデータを抽出し、解釈します。
テーブル認識:列見出しと行見出し付きの構造化されたテーブル抽出をサポートします。
図形分類:図形と図形要素を区別します。
キャプションの紐付け:キャプションを関連する画像や図表にリンクします。
リストのグループ化:リスト要素を正しく整理し、構造化します。
ページ全体の変換:コード、数式、テーブル、図表など、ページ上のすべての要素を含むページ全体を処理します。
境界ボックス付きOCR:境界ボックスを使用してOCR領域を認識します。
汎用文書処理:科学文書と非科学文書の両方に対する学習に対応しています。
Doclingとのシームレスな統合:Doclingにインポートでき、HTML、Markdownなどさまざまな形式でエクスポートできます。
高速推論:A100 GPU上で1ページあたりの平均処理時間は0.35秒です。
モデルの拡張と最適化
多様な指示のサポート:ページをDocTagsに変換する、グラフをテーブルに変換する、数式をLaTeXに変換するなど、多様な指示をサポートします。
多言語サポート:主に英語をサポートしていますが、拡張によりより多くの言語をサポートする可能性もあります。
継続的な改善:図表認識の改善、複数ページにまたがる推論のサポート、化学認識などの機能が改善されています。
SmolDoclingの応用シナリオ
学術研究:学術論文や研究報告書を素早く構造化フォーマットに変換し、重要な情報の抽出を容易にします。
ビジネス文書処理:ビジネス契約書、レポート、表格を自動変換し、企業による文書の保存、検索、分析を容易にします。
技術文書管理:技術マニュアルやコードドキュメントなどを編集可能なフォーマットに変換し、コードスニペットの正確な認識とフォーマット化をサポートします。
教育分野:教材や講義資料内のコンテンツ(数式、図表など)を抽出し、理解しやすいフォーマットに変換します。
医療文書処理:医療報告書や研究論文を処理して重要な情報を抽出し、医療意思決定を補助します。
モバイルおよび低リソースデバイスでのサポート:モバイルデバイスやリソースが限られた環境でも実行できます。
SmolDoclingの使用方法
モデルのダウンロード:Hugging FaceのモデルライブラリからSmolDoclingをダウンロードできます。
ローカルデプロイ:サイズが小さいため、通常のノートパソコンやモバイルデバイスで実行できます。
API呼び出し:Hugging Faceが提供するAPIインターフェースを介してSmolDoclingを呼び出すことができます。
モデルのファインチューニング:開発者は、医療報告書の解析や財務表格の認識など、特定のシナリオに適応させるためにモデルをファインチューニングできます。
Hugging Face モデルライブラリ:https://huggingface.co/ds4sd/SmolDocling-256M-preview
DEMO:https://huggingface.co/spaces/ds4sd/SmolDocling-256M-Demo









