
 脚本プランナー▸
 AIアプリ
 AIニュース
赤兎Chitu:清華大学チームによる高性能LLM推論フレームワーク
小编 ·

赤兎Chitu:清華大学チームによる高性能LLM推論フレームワーク
赤兔(Chitu)とは何ですか?
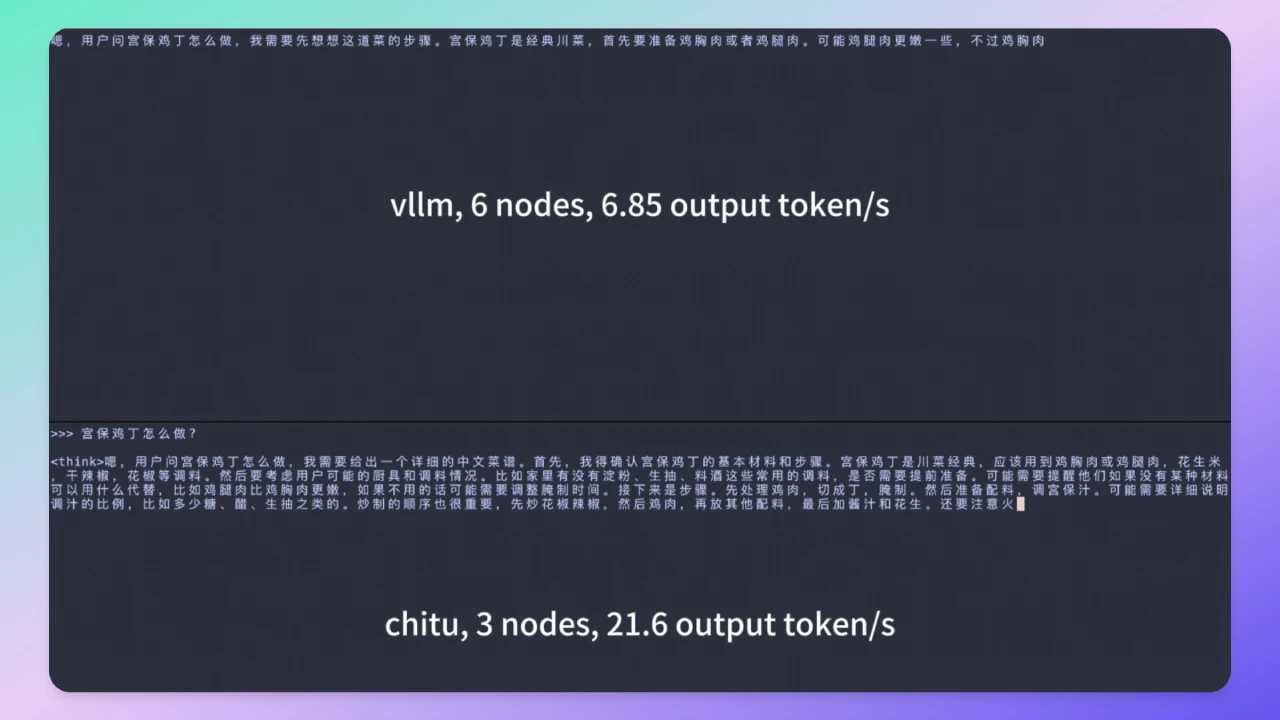
赤兔(Chitu)は、清華大学のチームによってオープンソース化された高性能な大規模言語モデル推論フレームワークで、推論効率の 향상、コスト削減に焦点を当て、複数のハードウェアプラットフォームとデプロイシナリオをサポートしています。これを利用することで、DeepSeekの推論コストを半分に削減し、性能を倍にすることができます。赤兔(Chitu)の目標は、企業や開発者に対して、高効率で柔軟かつデプロイしやすい推論エンジンを提供し、大規模言語モデル(LLM)の実用化を促進することです。
赤兔(Chitu)の機能と特徴
多様なコンピューティング対応:NVIDIAの最新フラッグシップから旧モデルまでの複数シリーズをサポートし、国産チップ向けの最適化も提供します。
全シナリオスケーラビリティ:純粋なCPUデプロイ、単一GPUデプロイから大規模クラスタデプロイまで、柔軟に拡張可能なソリューションを提供します。
長期安定稼働:実際の本番環境に適しており、同時並行の業務トラフィックを安定的に処理できます。
高効率な推論性能:A800クラスタでのテストにおいて、一部の国外オープンソースフレームワークと比較して、GPU使用量を50%削減した状態で推論速度が3.15倍向上しました。
コスト削減:ハードウェアリソースの使用を最適化することで、企業がaiモデルをデプロイする際のハードルとコストを低減します。
赤兔(Chitu)の応用シナリオ
エンタープライズ向けAIアプリケーション:高パフォーマンス、低遅延、高スループットが求められる推論サービス。
大規模クラスタデプロイ:複数GPUまたは複数ノード環境で効率的に動作させる必要があるシナリオ。
リソース制限のある環境:限られたハードウェアリソースで高効率な推論を実現する必要があるシナリオ。
国産チップ対応:大規模言語モデルを国産ハードウェアプラットフォーム上で実行する必要があるシナリオ。
赤兔(Chitu)の使用方法
1. ソースコードからのインストール
git clone --recursive https://github.com/thu-pacman/chitu && cd chitu
pip install -r requirements-build.txt
pip install -U torch --index-url https://download.pytorch.org/whl/cu124  # 根据 CUDA 版本调整
TORCH_CUDA_ARCH_LIST=8.6 CHITU_SETUP_JOBS=4 MAX_JOBS=4 pip install --no-build-isolation
2.単一GPU推論
torchrun --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1 infer.pp_size=1 infer.tp_size=8
3.ハイブリッド並列化 (TP+PP)
torchrun --nnodes 2 --nproc_per_node 8 test/single_req_test.py request.max_new_tokens=64 infer.pp_size=2 infer.tp_size=8 models=DeepSeek-R1 models.ckpt_dir=/data/DeepSeek-R1
4.サービスの起動
export WORLD_SIZE=8
torchrun --nnodes 1 \
--nproc_per_node 8 \
--master_port=22525 \
example/serve.py \
serve.port=21002 \
infer.stop_with_eos=False \
infer.cache_type=paged \
infer.pp_size=1 \
infer.tp_size=8 \
models=DeepSeek-R1 \
models.ckpt_dir=/data/DeepSeek-R1 \
keep_dtype_in_checkpoint=True \
infer.mla_absorb=absorb-without-precomp \
infer.soft_fp8=True \
infer.do_load=True \
infer.max_reqs=1 \
scheduler.prefill_first.num_tasks=100 \
infer.max_seq_len=4096 \
request.max_new_tokens=100 \
infer.use_cuda_graph=True
5.パフォーマンステスト
python benchmarks/benchmark_serving.py \
--model "deepseek-r1" \
--iterations 10 \
--seq-len 10 \
--warmup 3 \
--base-url http://localhost:21002
GitHubリポジトリ:https://github.com/thu-pacman/chitu









