
 脚本プランナー▸
 AIアプリ
 AIニュース
VACE:Alibaba Tongyi Wanチームの動画生成・編集統合モデル
小编 ·

VACE:Alibaba Tongyi Wanチームの動画生成・編集統合モデル
VACEとは?
VACE(Video Creation and Editing)は、アリババのTongyi研究所が発表した、ワンストップのAI動画生成・編集統合モデルです。統一されたモデルアーキテクチャにより、さまざまな動画制作および編集タスクを実現できます。テキストや画像から動画を生成したり、既存の動画に対してスタイル変換、修復、拡張を行ったりすることができます。複数の機能を1つのモデルに統合しており、操作が簡単で、クリエイティブ動画制作や古い動画の修復に適しています。
VACEの主な機能
動画生成:
テキストから動画生成:テキストプロンプトに基づいて動画を生成します。
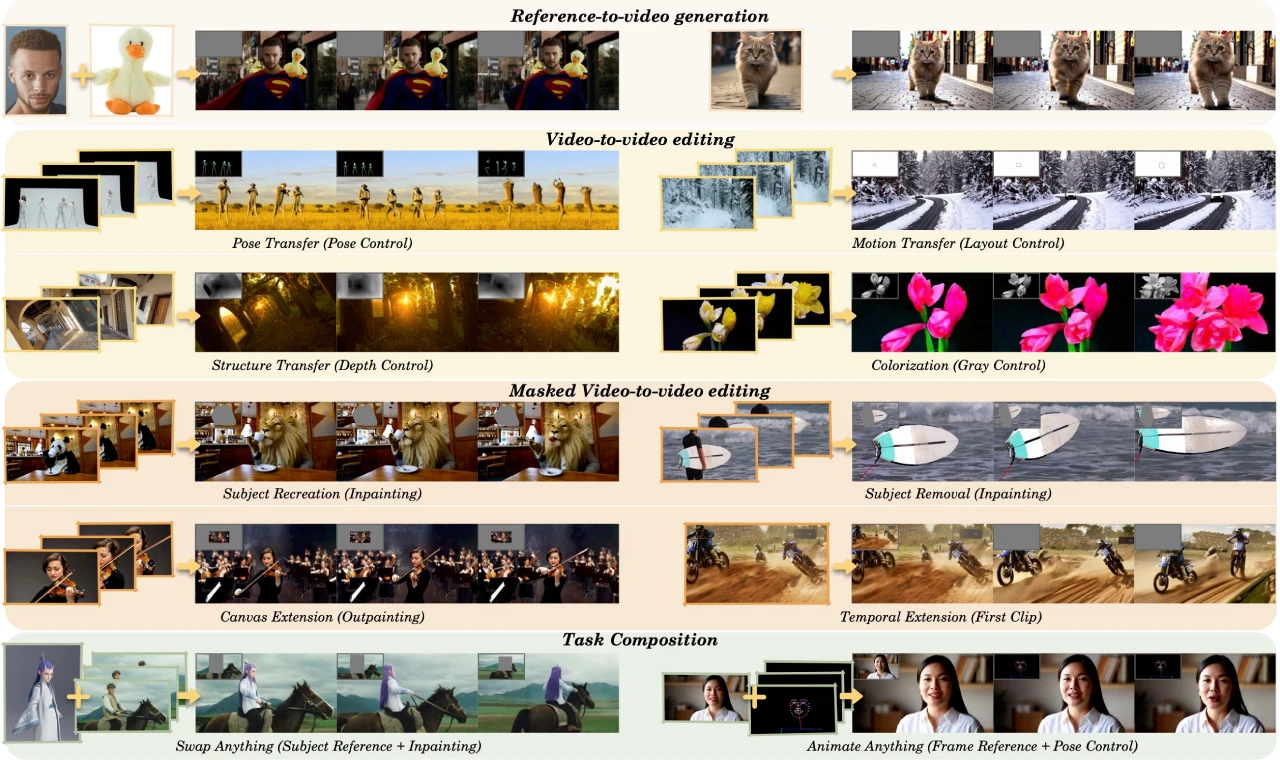
リファレンスから動画生成:テキストとリファレンス画像を組み合わせて動画を生成します。
動画拡張:既存の動画クリップに基づいて新しい冒頭や结尾を生成します。
動画編集:
動画から動画編集:入力動画に対して全体的なスタイル変換(カラーリング、スタイリングなど)を行います。
マスク動画編集:指定された領域のみ編集し、修復(Inpainting)や拡張(Outpainting)などを行います。
被写体除去と再構築:動画内の特定の被写体を除去し、背景を補完します。
タスクの組み合わせ:
リファレンス生成+被写体置き換え、ポーズ制御+動画拡張など、複数のタスクを柔軟に組み合わせることができます。
VACEの技術原理
Video Condition Unit(VCU):テキスト、画像、動画、マスクなど複数のモーダル入力を統一された条件ユニットに統合し、さまざまなタスクの柔軟な組み合わせをサポートします。
Context Adapter構造:時間と空間の次元での形式的な表現により、異なるタスクの概念をモデルに注入し、さまざまなタスク要件に適応できるようにします。
拡散モデル:拡散モデル(Diffusion Transformerなど)をベースに構築されており、段階的なノイズ除去により高品質な動画コンテンツを生成します。
VACEのメリット
統一フレームワーク:動画生成と編集タスクを1つのモデルに統合し、タスク切り替えの複雑さを軽減します。
高い効率性:さまざまなタスクにおいて、タスク特化型のモデルに匹敵する性能を達成します。
多様性:複数のタスクの組み合わせをサポートし、動画コンテンツ制作により幅広い応用可能性を提供します。
VACEの応用シナリオ
クリエイティブ動画生成:テキストや画像から広告、アニメなどのクリエイティブ動画コンテンツを素早く生成します。
動画修復と強化:古い動画の修復、欠損部分の補完、動画スタイルの強化を行います。
効率的な動画編集:被写体置き換え、アニメーション追加などの複雑な編集タスクを実現します。
動画拡張:ショート動画に対して新しいクリップを生成し、動画コンテンツを延長します。
インタラクティブな動画制作:ユーザー入力(ポーズ、スケッチなど)に基づいてパーソナライズされた動画を生成します。
プロジェクトリソース
プロジェクト公式サイト:https://ali-vilab.github.io/VACE-Page/
GitHubリポジトリ:https://github.com/ali-vilab/VACE
技術論文:https://arxiv.org/pdf/2503.07598









