
 脚本プランナー▸
 AIアプリ
 AIニュース
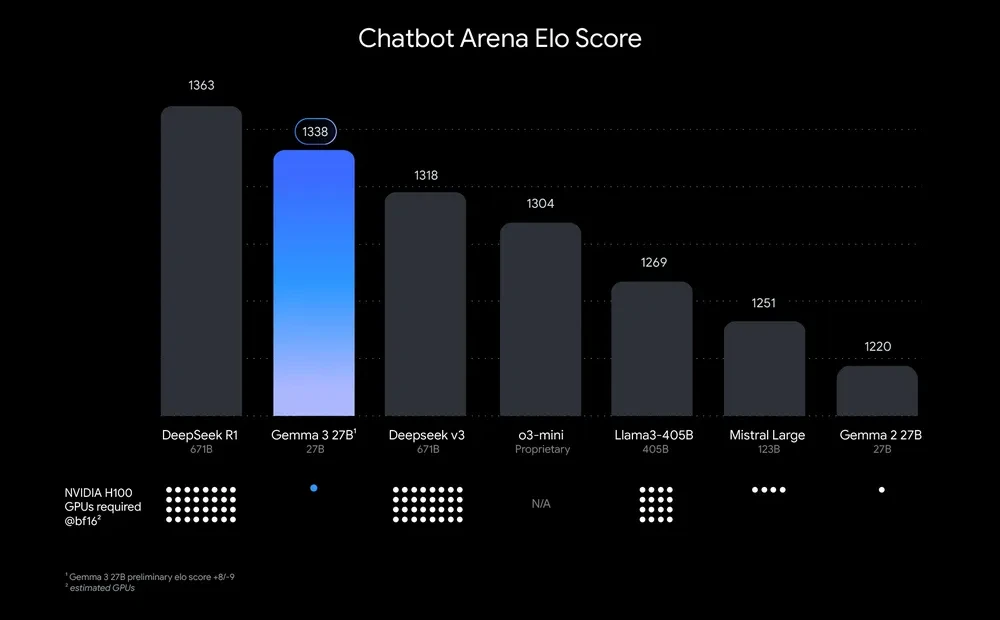
GoogleがGemma 3を発表:DeepSeek V3、o3-miniを上回り世界第2位のオープンソースモデルに
小编 ·

GoogleがGemma 3を発表:DeepSeek V3、o3-miniを上回り世界第2位のオープンソースモデルに
Gemma 3とは?
Gemma 3はGoogleが発表した最新のオープンソースモデルであり、DeepSeek V3およびo3miniを上回り、世界第2位の強力なオープンソースモデルとなっています。Gemma 3は強力なマルチモーダル機能を備え、テキスト、画像、そして短い動画を理解することができます。さらに、140以上の言語での事前学習をサポートし、35以上の言語を直接サポートします。128Kトークンのコンテキストウィンドウを備えており、大量の情報を処理でき、関数呼び出しやAIエージェント開発をサポートし、複雑なタスクの自動化を実現します。Gemma 3は、異なるハードウェアと性能ニーズに対応するため、4つの異なるサイズ(1B、4B、12B、27B)のモデルを提供しており、スマートフォンやコンピュータなど、さまざまなデバイス上で効率的に動作し、モバイルデバイスからワークステーションまで幅広い展開をサポートします。
Gemma 3の機能と特徴
マルチモーダル機能:テキスト、画像、短い動画の混合入力をサポートし、複雑なマルチモーダルタスクを処理できます。
強力な言語サポート:140以上の言語での事前学習をサポートし、35以上の言語を直接サポートします。
大きなコンテキストウィンドウ:128kトークンのコンテキストウィンドウをサポートし、高解像度画像30枚や1時間の動画など、大量の情報を処理できます。
高性能:単一のGPUまたはTPU上で、Llama、DeepSeek、OpenAIのo3-miniなど、他の同類モデルよりも優れた性能を発揮します。
最適化と量子化:公式の量子化バージョンが提供されており、モデルサイズと計算要件を削減しつつ、高精度を維持します。
安全性:ShieldGemma 2画像安全性分類器を備えており、危険なコンテンツを検出してフラグ付けできます。
Gemma 3の4種類のモデルサイズの特徴
1B:軽量で、スマートフォンやノートPCなど、リソースが限られたデバイスでの実行に適しています。
4B:マルチモーダルタスクに適しており、より強力な画像およびテキスト処理能力を備えています。
12B:性能がさらに強く、複雑な画像および動画分析に適しています。
27B:最大バージョンで、最も強力な性能を持ち、高性能コンピューティングシナリオに適しています。
Gemma 3の応用シナリオ
画像認識と分析:顔認識、物体検出、画像質問応答、画像比較をサポートします。
動画分析:短い動画コンテンツを処理でき、動画コンテンツ分析や生成に適しています。
スマートカスタマーサービス:マルチモーダル入力と連携し、よりスマートな顧客サービスを提供します。
産業品質検査:画像分析機能を利用して製品品質の問題を検出します。
コード生成とプログラミング支援:コード生成と自動コード修正をサポートします。
Gemma 3の使用方法
クイック実験:Google AI Studioを通じて、ブラウザで直接Gemma 3を使用できます。設定は不要です。
ダウンロードと微調整:Hugging Face、Ollama、またはKaggleからモデルをダウンロードし、Hugging Face Transformersまたはその他のツールを使用して微調整を行います。
展開オプション:Vertex AI、Cloud Run、Google GenAI API、ローカル環境、NVIDIA GPUなど、さまざまな展開方法をサポートします。
開発ツールのサポート:Hugging Face Transformers、Ollama、JAX、Keras、PyTorchなど、さまざまな開発ツールと互換性があります。
Gemma 3の技術
基盤アーキテクチャ:Geminiと同じ技術アーキテクチャに基づいています。
トレーニングと最適化:知識蒸留、強化学習(人間のフィードバックと機械フィードバックを含む)、モデルマージなどの技術を採用して性能を向上させています。
視覚処理:動的画像スライス技術とフレームサンプリングとオプティカルフロー分析の組み合わせを使用し、高解像度で正方形以外の画像をサポートします。
ハードウェア最適化:NVIDIA GPUおよびGoogle Cloud TPU向けに深く最適化され、効率的な動作を保証します。
Gemma 3はGemma 2からどのような改善がされましたか?
マルチモーダル機能:テキスト、画像、短い動画の混合入力サポートを新たに追加し、画像質問応答や動画分析などの複雑なタスクを処理できます。
性能向上:単一GPUでの性能がさらに強化され、推論速度が47%向上しました。
言語サポート:140以上の言語での事前学習をサポートし、35言語を直接サポートし、言語処理能力が強化されました。
コンテキストウィンドウの拡張:128kトークンをサポートし、より大規模な情報を処理できます。
視覚処理能力:高解像度画像と動画解析をサポートし、1時間の動画のキーフレーム抽出時間が20秒に短縮されました。
セキュリティ強化:ShieldGemma 2画像安全性分類器を備えており、危険なコンテンツを検出できます。
ハードウェア最適化:GPUおよびTPU向けに深く最適化され、さまざまな展開オプションをサポートします。
トレーニングと微調整:強化学習などの技術を採用し、より柔軟な微調整ツールを提供します。









