
 脚本プランナー▸
 AIアプリ
 AIニュース
OpenManus-RL:LLMエージェントの推論・意思決定能力を強化するオープンソースプロジェクト
小编 ·

OpenManus-RL:LLMエージェントの推論・意思決定能力を強化するオープンソースプロジェクト
OpenManus-RLとは?
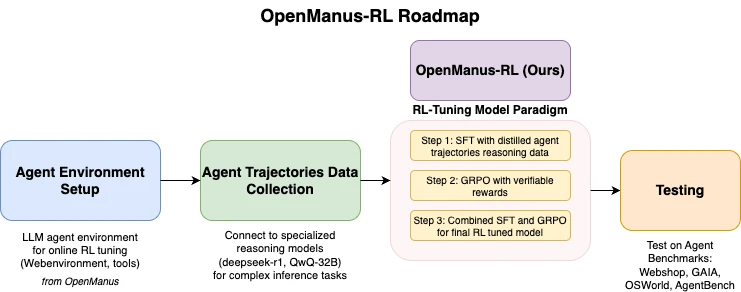
OpenManus-RLは、UIUC-UlabとMetaGPTコミュニティのOpenManusチームによって共同開発されたオープンソースプロジェクトであり、強化学習RL技術を通じて大規模言語モデルLLMエージェントの推論・意思決定能力を向上させることができます。本プロジェクトはDeepseek-R1、QwQ-32Bなどの先進的なモデルの経験に基づき、新たな調整手法を探求し、複雑なタスクにおけるエージェントの性能を向上させます。OpenManus-RLの中核機能には、エージェント環境の構築、軌道データの収集、強化学習調整のサポート、ベンチマークテストの統合が含まれます。また、Tree-of-Thoughtsやモンテカルロ木探索(Monte Carlo Tree Search)など、さまざまな強化学習戦略を統合し、エージェントの推論能力を向上させます。
OpenManus-RLの機能特徴
エージェント環境の構築:オンライン強化学習(RL)調整用のエージェント環境設定ツールを提供し、ユーザーが特定のタスクに合わせてエージェント環境をカスタマイズできるようにします。
軌道データの収集:Deepseek-R1、QwQ-32Bなどのモデルに接続し、複雑なタスクの行動データを収集して、その後の調整にデータサポートを提供します。
RL調整のサポート:カスタマイズ可能なエージェント行動の強化学習方法をサポートし、ユーザーは報酬関数を指定するなどの方法でエージェントの行動を最適化できます。
ベンチマークテストの統合:WebShop、GaiA、OSWorld、AgentBenchなどのテスト環境を内蔵し、ユーザーがエージェントの性能を定量的に評価できるようにします。
多様な戦略:Tree-of-Thoughts、Monte Carlo Tree Searchなどの強化学習戦略を統合し、長距離計画タスクにおけるエージェントの推論能力を向上させます。
コミュニティコラボレーション:ユーザーがコード、データセットなどを提出することを可能にし、重要な貢献者は論文の共同著者になることができ、コミュニティの共同開発を促進します。
リアルタイムの進捗共有:RL調整のプロセスと成果を動的に更新して表示し、ユーザーがプロジェクトの最新の進捗を把握できるようにします。
OpenManus-RLの応用シナリオ
ショッピング意思決定:カスタマイズされたエージェント環境を通じて、WebShopなどにおける購入成功率の向上など、ショッピング意思決定タスクにおけるエージェントの性能を最適化します。
複雑なタスク分析:GAIA、OSWorldなどのベンチマークテストにおける成功率、応答時間などの指標を通じて、複雑なタスクにおけるエージェントの performance を分析し、開発者がモデル performance を比較できるようにします。
マルチモーダルタスクの最適化:OSWorldなどのマルチモーダルタスク環境において、エージェントの行動を最適化し、マルチモーダルタスクにおけるその performance を向上させます。
長距離計画タスク:統合された多様な戦略を利用して、Tree-of-Thoughts戦略によるエージェントの行動の最適化など、長距離計画タスクにおけるエージェントの推論能力を向上させます。
OpenManus-RLインストール
1. Conda環境の作成:依存関係の競合を避けるため、Condaを使用して環境を作成することをお勧めします。コマンドは以下のとおりです:
conda create -n openmanus-rl python=3.10
conda activate openmanus-rl
2. プロジェクトのクローン:Gitがインストールされていることを確認し、プロジェクトをクローンしてプロジェクトディレクトリに移動します。コマンドは以下のとおりです:
git clone https://github.com/OpenManus/OpenManus-RL.git
cd OpenManus-RL
3. 依存関係のインストール:プロジェクトのルートディレクトリで以下のコマンドを実行して依存関係をインストールします。ダウンロードが遅い場合は、国内のミラーを使用できます:
pip install -r requirements.txt
または
pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple
可視化ツールは別途インストールが必要です:
pip install matplotlib numpy
4. モデルとデータセットの設定:
教師あり微調整(SFT):モデルとデータセットを指定します。コマンドは以下のとおりです:
python -m openmanus_rl.sft --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL
強化学習調整(GRPO):報酬関数を設定します。コマンドは以下のとおりです:
python -m openmanus_rl.grpo --model_name_or_path Qwen/Qwen2.5-1.5B-Instruct --dataset_name CharlieDreemur/OpenManus-RL-GRPO --reward_funcs accuracy format tag_count
データセットはHuggingfaceから取得できます。
5. プロジェクトの実行:
単一GPUでのSFT実行:
python -m openmanus_rl.sft --output_dir data/sft-output
複数GPUでのGRPO実行(zero3.yamlの設定が必要):
accelerate launch --config_file=configs/accelerate_configs/zero3.yaml openmanus_rl/grpo.py --output_dir data/grpo-output
OpenManus-RLの使用方法
1. エージェント環境の構築:
python -m openmanus_rl.sftを実行して基本環境を生成します。
設定ファイル(タスク目標や報酬関数など)を変更します。
python -m openmanus_rl.grpoを実行して調整を開始します。
2. データ収集とテスト:
モデルを設定します(例:Deepseek-R1):python -m openmanus_rl.grpo --model_name_or_path Deepseek-R1
テストを実行します:--benchmark GAIA、結果はdata/ディレクトリに保存されます。
3. RL調整の操作:
GRPOモードを実行します:python -m openmanus_rl.grpo --reward_funcs accuracy
訓練ログを確認します。モデルはdata/grpo-outputに保存されます。
GitHubリポジトリアドレス:https://github.com/OpenManus/OpenManus-RL









