
 脚本プランナー▸
 AIアプリ
 AIニュース
Vid2Avatar-Pro:モノラル映像からリアルな3D人体アバターを生成
小编 ·

Vid2Avatar-Pro:モノラル映像からリアルな3D人体アバターを生成
Vid2Avatar-Proとは?
Vid2Avatar-Proは、通常の単眼動画からリアルでアニメーション可能な3D人体アバターを作成できる技術です。Vid2Avatarのアップグレード版であり、汎用事前モデル(Universal Prior Model、UPM)と最適化された3D表現手法を導入することで、アバターのリアルさと汎化性能を向上させています。
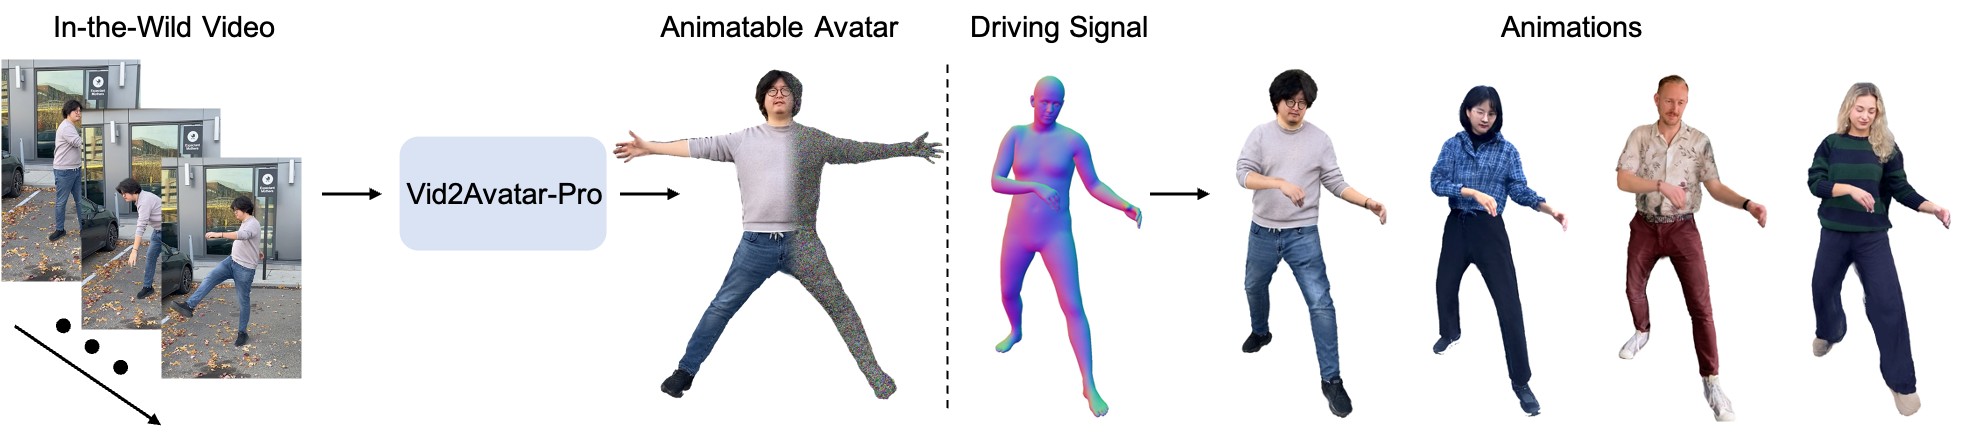
Vid2Avatar-Proの主な特徴
高いリアル性とアニメーション性:Vid2Avatar-Proは、通常の単眼動画からリアルな3Dアバターを生成し、複雑な動作アニメーションをサポートします。
マルチビューレンダリング:生成されたアバターは任意の視点にレンダリング可能で、従来の手法で課題だった視点の制限を解決します。
多様な動作サポート:アバターはバドミントンやドラム演奏、片足ジャンプなどの多様な複雑な動作を実行できます。
汎用事前モデル(UPM):大規模なマルチビューデータで事前学習された汎用事前モデルにより、新しいポーズや視点に対する汎化能力が大幅に向上します。
Vid2Avatar-Proの応用シーン
映画・映像制作:通常の動画から俳優の3Dモデルを復元し、特殊効果制作に活用します。
バーチャルリアリティ(VR)および拡張現実(AR):リアルな仮想キャラクターを作成し、没入感を高めます。
ファッション・Eコマース:動画からユーザーの3Dモデルを復元し、バーチャル試着を実現します。
スポーツ分析:試合動画からアスリートモデルを復元し、動作の詳細を分析します。
医療・リハビリ:リハビリ過程での患者の動作を記録・分析します。
Vid2Avatar-Proの技術原理
汎用事前モデル(UPM)
事前学習段階:大規模なマルチビューで動的な着衣人物パフォーマンスデータを用いてUPMを訓練し、人間の外観とポーズの汎用的な特徴を学習します。
ファインチューニング段階:与えられた単眼のインザワイルド動画に対し、逆レンダリング技術により事前学習済みのUPMをファインチューニングし、特定人物の詳細を復元します。
3Dガウシアン表現
正規化されたフロンドバックマップに基づく3Dガウシアン表現を用いてアバターを構築し、これらのマップは異なるアイデンティティ間で共有されます。
正方向線形ブレンドスキニング(LBS)とラスタライゼーション技術により、トレーニング用ポーズ/形状パラメータを合成します。
自己教師ありシーン分解
外部のセグメンテーションモジュールに依存せず、3D空間で人体と背景を直接分離します。
人物と背景をそれぞれ独立したニューラル場でパラメータ化することで、シーン分解とサーフェス再構築の課題を解決します。
最適化戦略
粗から細へのサンプリング戦略と新しい目的関数を導入し、動的な人体と静的背景を鮮明に分離します。
背景モデル、正規化された人体の形状とテクスチャ、および各フレームの人体ポーズパラメータを最適化します。
Vid2Avatar-Proの使用方法
1. データ準備:
ROMPを使用して初期のSMPL形状とポーズを取得します。
OpenPoseを使用してキーポイントを抽出します。
2. モデル訓練:
背景モデル、人体の形状・テクスチャ、ポーズパラメータを共同で最適化します。
3. 生成とレンダリング:
学習済みモデルを使用して最終的な3Dアバターを生成します。
逆レンダリング技術によりマルチビューレンダリングを実現します。
4. アニメーション生成:
アバターを新しい動作シーケンスにバインドし、多様なアニメーションを実現します。
論文リンク:https://moygcc.github.io/vid2avatar-pro/static/CVPR2025_Vid2Avatar_Pro.pdf
プロジェクトページ:https://moygcc.github.io/vid2avatar-pro/









