
 脚本プランナー▸
 AIアプリ
 AIニュース
SpeakerKit:音声内の異なる話者を迅速かつ正確に識別
小编 ·

SpeakerKit:音声内の異なる話者を迅速かつ正確に識別
SpeakerKitとは?
SpeakerKit は Argmax 社が開発した デバイス上の話者識別(Diarization)ツールで、音声内の異なる話者を迅速かつ効率的に識別できます。オーディオ文字起こしツールである WhisperKit と組み合わせて使用することで、話者ラベル付きの文字起こしテキストを生成できます。音声内の話者を迅速かつ正確に識別する必要があるアプリケーションシナリオに適しています。
SpeakerKitの主な特徴
速度:
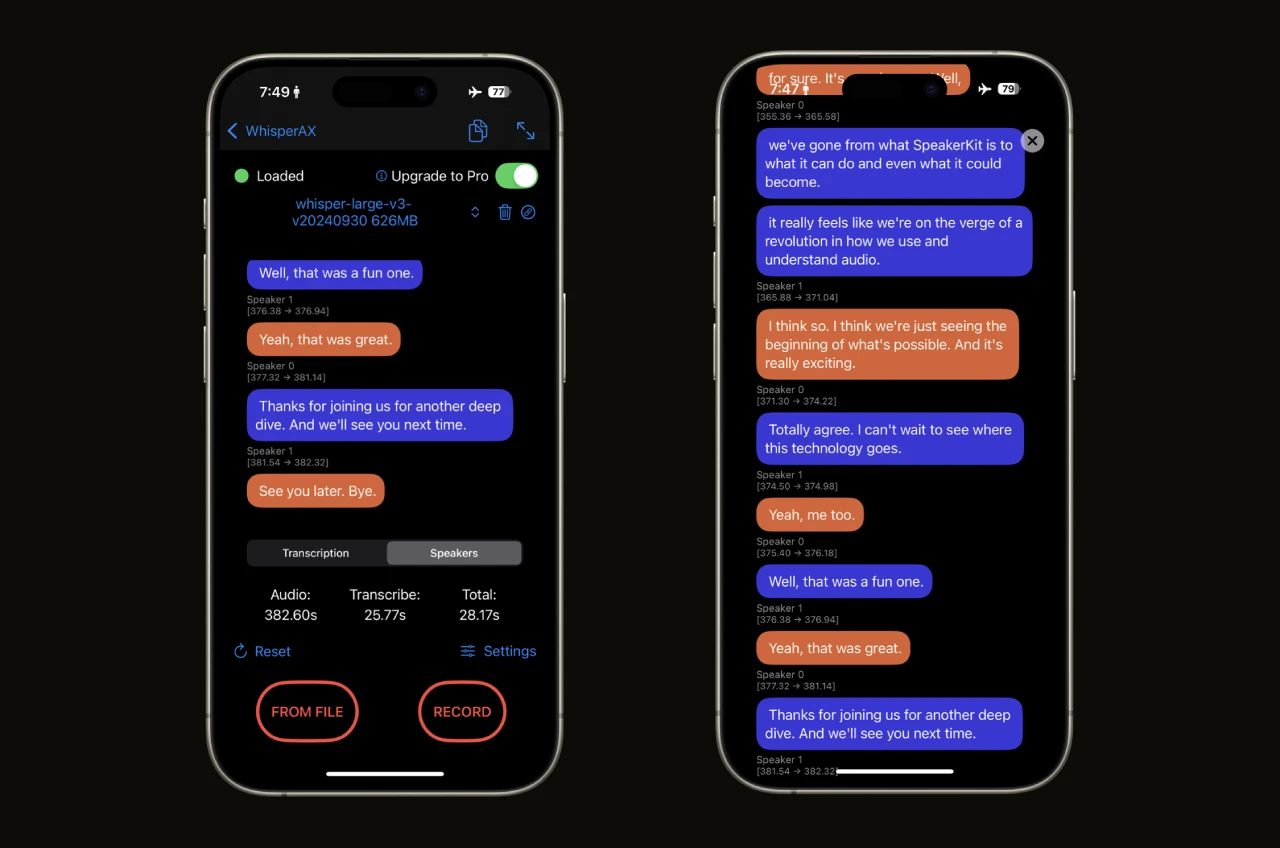
iPhone で 4 分のオーディオを処理する場合、SpeakerKit は話者識名の完了に 約 1 秒 しかかからず、速度は他の同類システムを大幅に上回ります。
WhisperKit と組み合わせて使用する場合、文字起こしと識名の合計時間はわずか 25 秒です。
品質:
SpeakerKit のエラー率は業界最先端のシステム(Pyannote など)と同等で、速度は数倍向上しています。
サイズ:
合計サイズは約 10MB で、アプリケーションへの統合や迅速なダウンロードが容易です。
互換性:
iOS 16 および macOS 13 以降のデバイスをサポートします。
Android サポートは開発中です。
モジュラー設計:
SpeakerKit は WhisperKit と組み合わせて話者ラベル付きの文字起こしテキストを生成できるほか、他の文字起こしエンジンとも統合でき、サーバーサイド API よりも高い柔軟性を提供します。
ベンチマーク
Argmax は SDBench という Python ツールキットを開発し、13 の広く使用されているデータセットで話者識別システムのパフォーマンスを標準化してテストしました。SDBench のコードはオープンソース化され、関連論文は 2025 年 4 月に発表される予定です。
今後の計画
文字起こし品質の向上:現在、SpeakerKit の単独話者識別品質は業界最先端レベルに達しています(DER により測定)。次のステップとして、チームは WhisperKit との併用を最適化し、話者ラベル付きの文字起こし品質の向上に取り組みます(WDER により測定)。
話者識別機能:SpeakerKit は新しい機能をリリースし、話者の声紋を抽出して新しいコンテキストで識別できるようにします。
詳細記事:https://www.argmaxinc.com/blog/speakerkit
HuggingFace:https://huggingface.co/argmaxinc/speakerkit-pro









