
 脚本プランナー▸
 AIアプリ
 AIニュース
HunyuanVideo-I2V:テンセント混元がオープンソース化した画像→動画生成フレームワーク
小编 ·

HunyuanVideo-I2V:テンセント混元がオープンソース化した画像→動画生成フレームワーク
HunyuanVideo-I2Vとは?
HunyuanVideo-I2Vは、テンセントのHunyuanチームが2025年3月6日にオープンソース化した最新の画像から動画生成フレームワークです。このフレームワークは以前にオープンソース化されたHunyuanVideoをベースに、画像から動画を生成する能力をさらに拡張したもので、動画制作者は1枚の画像から高品質な短編動画を生成でき、カスタマイズされたエフェクトの学習もサポートしています。
HunyuanVideo-I2Vの主な機能
画像から動画生成:HunyuanVideo-I2Vは静的画像を動画の最初のフレームとして使用し、ユーザーが入力した字幕や説明に基づいてマッチする動画コンテンツを生成できます。
マルチモーダル大規模言語モデル(MLLM):このモデルは事前学習済みのマルチモーダル大規模言語モデルをテキストエンコーダーとして使用し、入力画像のセマンティック内容の理解能力を大幅に強化しています。
3D変分オートエンコーダー(3D VAE):CausalConv3D技術を用いて学習された3D VAEにより、画素空間内の動画と画像をコンパクトな潜在空間に圧縮し、後続モデルにおけるトークン数を削減します。
デュアルストリームからシングルストリームへのハイブリッドモデル設計:デュアルストリームフェーズでは、動画トークンとテキストトークンが複数のTransformerブロックで独立して処理されます。シングルストリームフェーズでは、動画トークンとテキストトークンを結合し、マルチモーダル情報融合を行います。
プログレッシブ学習戦略:低解像度・短時間動画から高解像度・長時間動画へと段階的に移行し、モデルの収束速度を向上させます。
プロンプト書き換えモデル:ユーザーのプロンプトの言語スタイルや長さのばらつきという課題を解決し、ユーザーが入力したプロンプトをモデルがより理解しやすい形式に変換します。
カスタマイズ可能なLoRA学習:少量のデータを通じて特定の効果を持つ動画生成モデル(例:「髪の成長」や「人物の動作」などの特殊効果)の学習をサポートします。
効率的な推論:単一GPU推論と複数GPUシーケンシャル並列推論を提供し、より高速な推論速度をサポートします。
HunyuanVideo-I2Vの技術アーキテクチャ
HunyuanVideo-I2Vは、全体的なアーキテクチャにおいてHunyuanVideoの設計思路を引き継ぎつつ、画像から動画生成タスクに特化した最適化を行っています。その核心は、画像潜在空間連結技術を利用して参照画像のキー情報を動画生成プロセスに注入するとともに、MLLMを通じてテキストと画像情報のクロスモーダルな深層融合を実現することにあります。
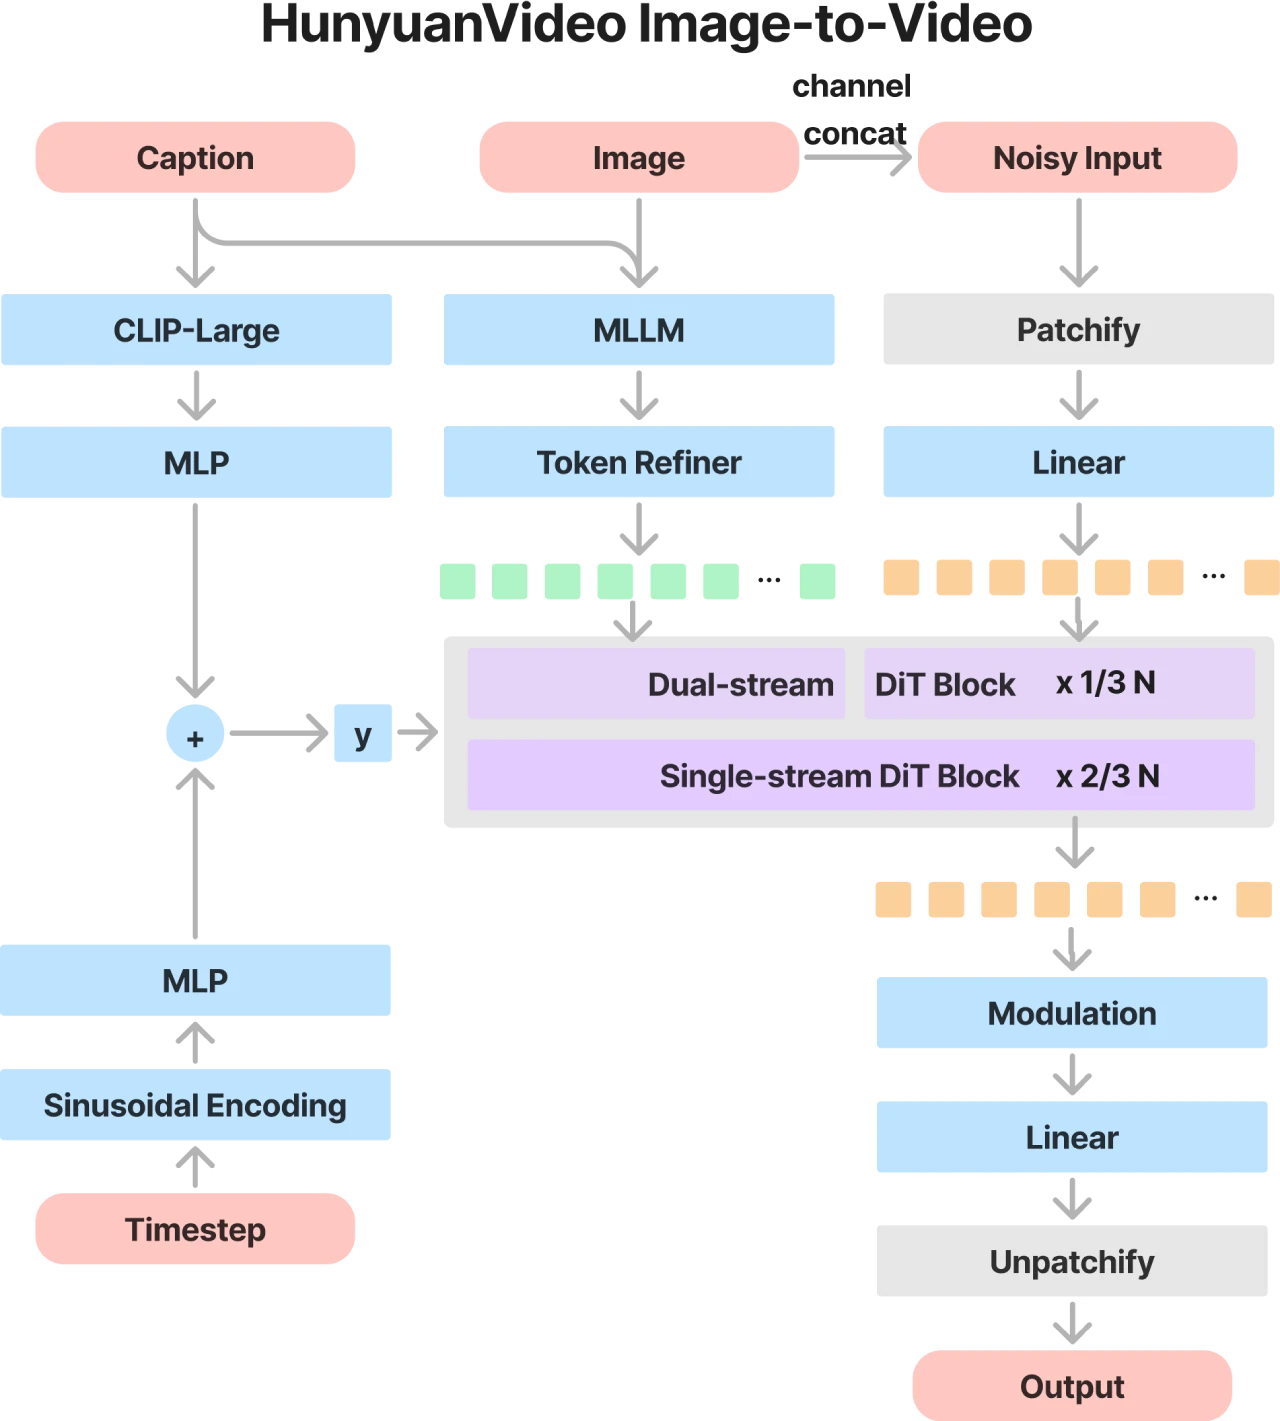
HunyuanVideo-I2Vの使用方法
1. インストールと依存関係
PyTorchその他の依存関係をインストールします。具体的なインストールガイドはGitHubページでご確認ください。
NVIDIA GPUの使用を推奨し、少なくとも80GBのビデオメモリが必要です。
2. 事前学習済みモデルのダウンロード
事前学習済みのモデル重みはGitHubページまたはHugging Faceページからダウンロードできます。
3. 推論コード
提供されている推論コード(sample_video.pyなど)を使用して動画を生成します。
4. LoRA学習
LoRA学習コードが提供されており、ユーザーは少量のデータで特定の効果を持つ動画生成モデルを学習できます。
HunyuanVideo-I2Vの応用シナリオ
動画コンテンツ制作:動画制作者に効率的かつ高品質な動画生成ツールを提供します。
映像制作:映画・テレビ級の動画コンテンツを生成します。
パーソナライズされた動画:ユーザーがアップロードした画像と説明に基づいてパーソナライズされた動画を生成します。
公式サイト:https://video.hunyuan.tencent.com/
GitHub:https://github.com/Tencent/HunyuanVideo-I2V
Hugging Face:https://huggingface.co/tencent/HunyuanVideo-I2V









