
 脚本プランナー▸
 AIアプリ
 AIニュース
ViDoRAG:ビジュアル文書理解のための検索拡張生成(RAG)システム
小编 ·

ViDoRAG:ビジュアル文書理解のための検索拡張生成(RAG)システム
ViDoRAGとは?
ViDoRAGは、アリババのTongyi Labが中国科学技術大学および上海交通大学と共同で発表した、視覚文書理解のための検索拡張生成(RAG)システムです。マルチモーダル混合検索とマルチエージェント反復推論メカニズムを活用することで、視覚文書処理の正確性と効率の両方を大幅に向上させます。分かりやすく言えば、画像を含む文書の検索をサポートし、例えば「この製品の色は何か」や「この文章は何について書かれているか」といった質問を、大量の画像を含む文書の中から見つけ出すことができるということです。
ViDoRAGのフレームワーク
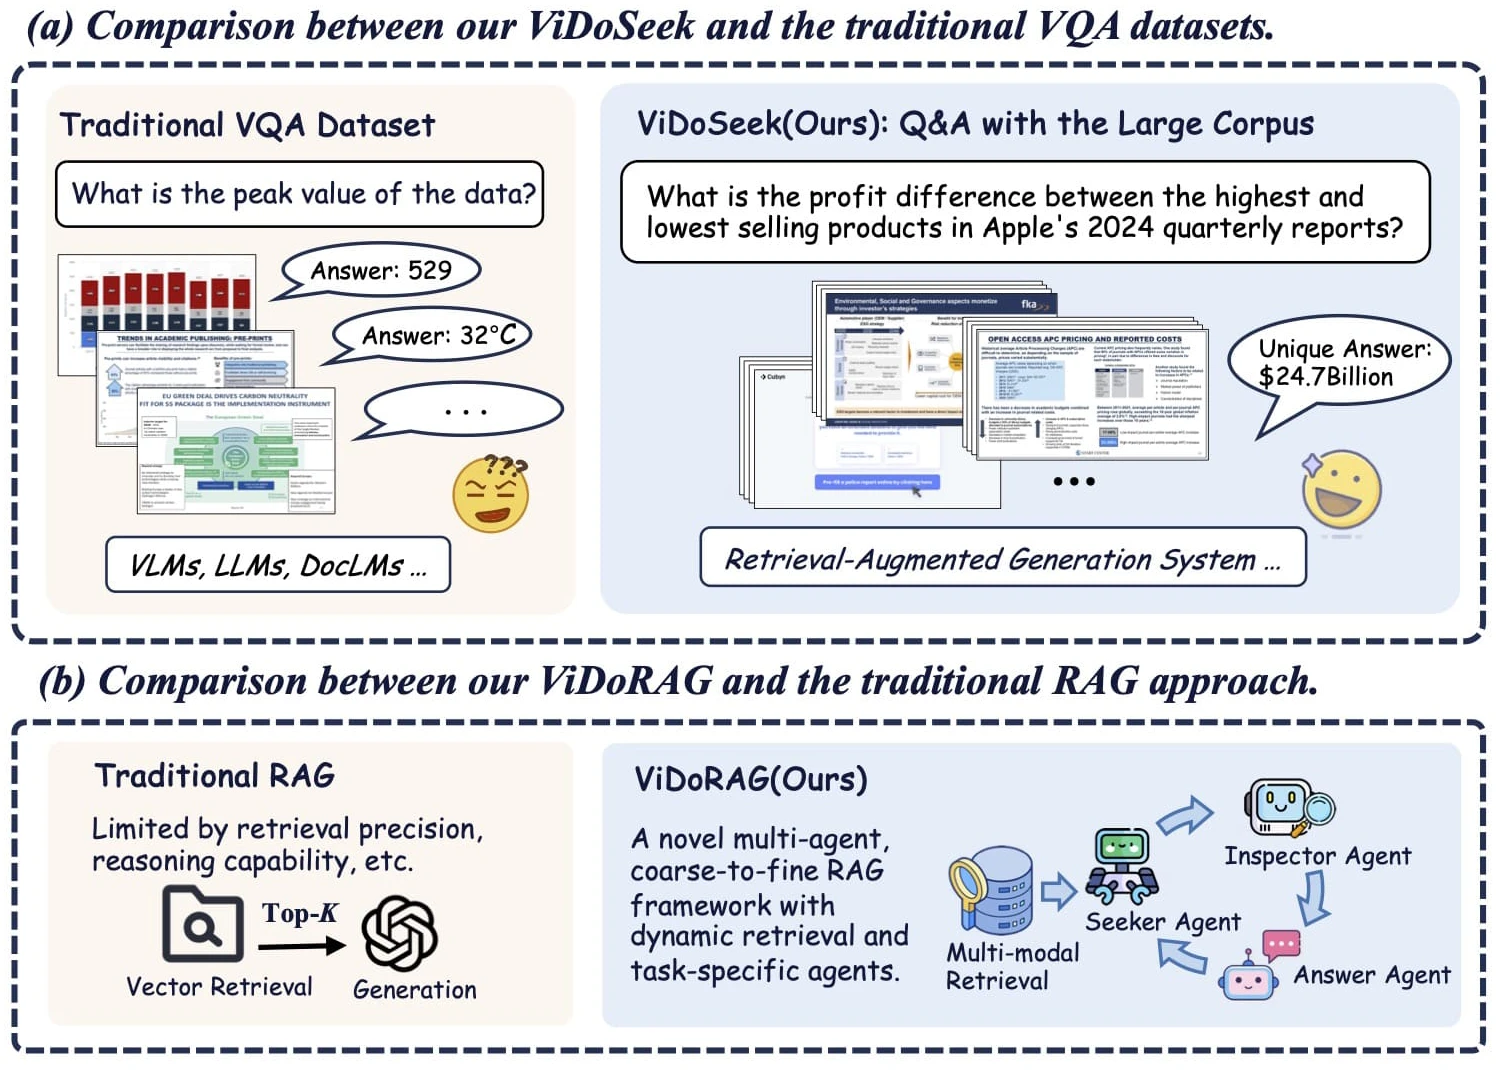
ViDoRAGのフレームワークは、マルチエージェントの協働と動的反復推論を重視しており、主に以下のような重要な要素で構成されています。
マルチモーダル混合検索:視覚特徴とテキスト特徴を組み合わせ、混合ガウスモデル(GMM)を用いて検索戦略を動的に調整することで、より正確に重要な情報を発見します。
マルチエージェント協働:
Seeker Agent:関連する画像や文書フラグメントを迅速に選別し、全体の手がかりを提供します。
Inspector Agent:選別された結果を詳細に審査し、初期回答を生成します。
Answer Agent:初期回答を統合し、その正確性と一貫性を確認した上で、最終的な回答を生成します。
動的検索戦略:GMMを活用して検索結果の数を動的に調整し、計算量を削減して検索効率を高めます。
機能と特徴
1. マルチモーダル混合検索:
視覚とテキストのデュアルチャネル検索:ViDoRAGは視覚(画像)情報とテキスト情報を同時に処理して検索を行うことができ、文書の内容をより包括的に理解します。
混合ガウスモデル(GMM)による融合:GMMを用いて視覚検索結果とテキスト検索結果の重みを動的に調整し、クエリの特性に応じて最適な検索戦略を選択し、ノイズと計算量を削減します。
2. マルチエージェント協働推論:
Seeker Agent:関連する文書や画像フラグメントを迅速に選別し、検索範囲を絞り込みます。
Inspector Agent:選別されたフラグメントを詳細に審査し、重要な情報を抽出して初期回答を生成します。
Answer Agent:初期回答を統合・検証し、最終的な回答を生成します。
動的反復推論:複数のエージェントが継続的に協働・反復することで、回答の品質を徐々に向上させます。
3. 動的検索戦略:
適応的な検索結果数:ViDoRAGはGMMを用いて検索結果の数を動的に調整し、固定数検索に起因する問題を回避します。
効率的な検索フロー:クエリと文書集合の類似度分布に応じて検索戦略を自動的に最適化し、検索効率を向上させます。
4. 複雑な文書理解能力:
視覚的に豊富な文書のサポート:テキスト、図、表、複雑なレイアウトを含む文書を処理できます。
マルチホップ推論能力:シングルホップおよびマルチホップの推論タスクを処理でき、文書を横断した理解が必要な複雑なクエリにも対応します。
5. 高精度と高性能:
高精度:ViDoSeekベンチマークデータセットにおいて79.4%の精度を達成し、他のベースライン手法を大きく上回ります。
堅牢性:マルチエージェント協働と動的検索戦略により、ViDoRAGはノイズデータや複雑なシナリオにおいても安定した性能を発揮します。
応用シナリオ
視覚文書処理:学術論文、レポート、マニュアルなど、視覚的に豊富な文書を処理するシナリオに適しています。
質問応答システム:質問応答システムの中核モジュールとして、迅速かつ正確に質問に回答できます。
スマートオフィス:ユーザーが文書から重要な情報を迅速に抽出し、業務効率を向上させるのに役立ちます。
GitHubリポジトリ:https://github.com/Alibaba-NLP/ViDoRAG









