
 脚本プランナー▸
 AIアプリ
 AIニュース
UniTok:ByteDanceがオープンソース化した生成タスクと理解タスクを兼ね備えたビジュアルトークナイザ
小编 ·

UniTok:ByteDanceがオープンソース化した生成タスクと理解タスクを兼ね備えたビジュアルトークナイザ
UniTokとは?
UniTokは、バイトダンスがオープンソース化した、生成タスクと理解タスクの両方に同時に使用できる視覚トークナイザーで、視覚情報を効率的にトークンに変換し、さまざまな自己回帰生成モデルやマルチモーダル理解モデルに適しています。革新的な視覚トークン化技術により、極めて少ないトークン数(例:256トークン)で高品質な視覚コンテンツ生成を実現し、例えば画像や動画の再構築が可能です。
UniTokのコア機能
高効率な視覚エンコーディング:UniTokは複雑な視覚情報(画像や動画など)を離散トークンに分解し、モデルが処理しやすくします。
マルチモーダル対応:画像だけでなく動画コンテンツも処理でき、連続的および離散的なトークン化をサポートします。
低リソース要件:UniTokは少ないトークン数でも高品質な再構築を維持でき、例えば256トークンでの再構築誤差はわずか0.39です。
柔軟な圧縮率:ユーザーはニーズに応じてトークン数を調整し、生成品質と計算効率のバランスを取ることができます。
UniTokの応用分野
視覚生成タスク:画像や動画の再構築、言語モデル駆動の視覚合成など。
マルチモーダル理解:テキストと視覚情報を組み合わせ、より効率的なマルチモーダルモデル学習を実現します。
拡散モデル:DiTやLatteなどの拡散モデルと組み合わせて、高品質な視覚コンテンツを生成します。
UniTokの技術実装
UniTokはVQVAE(変分量子化オートエンコーダ)およびVAE(変分オートエンコーダ)技術に基づき、2段階の学習により高効率な視覚エンコーディングを実現します。その学習プロセスには以下が含まれます:
画像単一解像度学習:固定解像度で画像学習を行います。
画像-動画共同マルチ解像度学習:複数の解像度で画像と動画の共同学習を行います。
VAEファインチューニング:KL損失によりVQVAEモデルをファインチューニングし、VAEモデルを得ます。
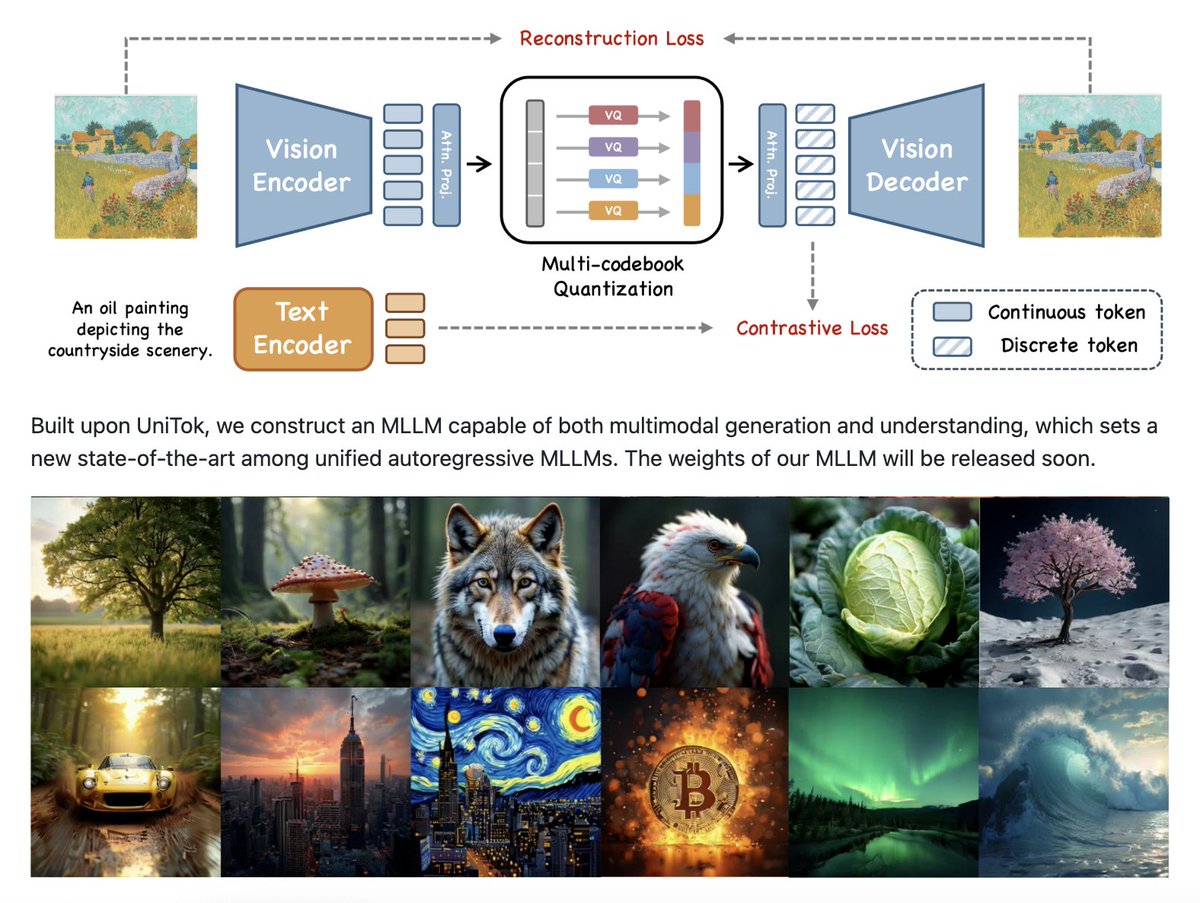
UniTokの優位性
単一モデルと重み:UniTokは単一のモデルと重みで画像と動画のトークン化を処理し、モデルの管理と展開を簡素化します。
高い適応性:高解像度および長尺動画入力をサポートし、さまざまな応用シナリオに適応します。
高い互換性:言語モデルや拡散モデルと互換性があり、多様な視覚生成を実現します。
UniTokはマルチコードブック量子化技術により、従来のトークナイザーが生成タスクと理解タスクで抱えていたボトルネックを解決し、マルチモーダル大規模言語モデル(MLLM)に対してより効率的なソリューションを提供します。
プロジェクトアドレス:https://foundationvision.github.io/UniTok/
GitHubリポジトリ:https://github.com/FoundationVision/UniTok









