
 脚本プランナー▸
 AIアプリ
 AIニュース
Migician:複雑なシーンでの複数画像オブジェクトグラウンディングに対応する、清華大学などのチームが開発したマルチモーダルモデル
小编 ·

Migician:複雑なシーンでの複数画像オブジェクトグラウンディングに対応する、清華大学などのチームが開発したマルチモーダルモデル
Migicianとは?
Migicianは、清華大学、北京交通大学、華中科技大学の共同開発による、フリー形式(free-form)かつ精密な位置特定が可能なマルチモーダル大規模言語モデルであり、複数画像シナリオに対応します。テキスト記述、画像、またはその両方の組み合わせを通じて、複数画像内の対象領域を迅速に特定することを可能にし、複数画像シナリオにおける位置特定能力を向上させます。
Migicianの主な機能
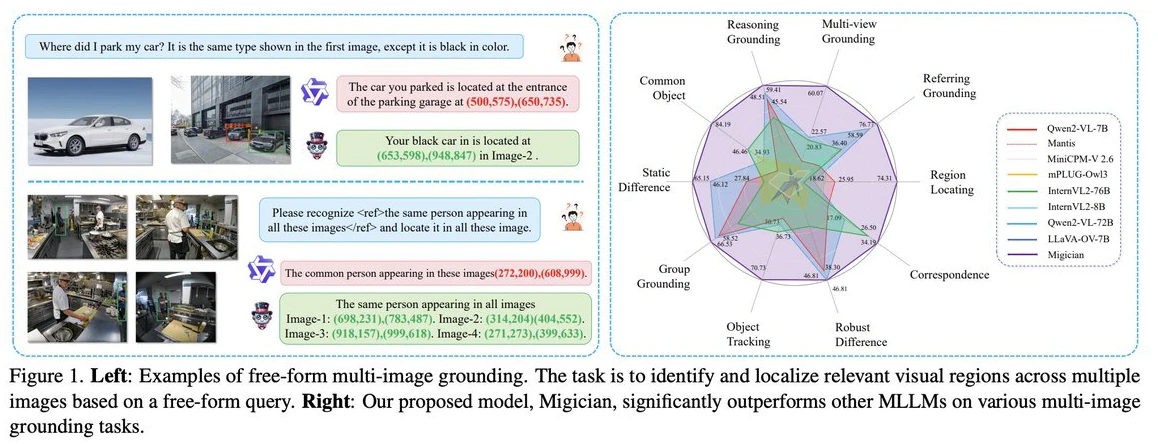
画像横断位置特定:Migicianは、「画像による画像検索」や「テキスト+画像」の組み合わせクエリなど、さまざまな画像横断位置特定方式をサポートします。たとえば、警備監視の場面では、「黒い上着、ブルージーンズ、白い野球帽をかぶった男性」というテキスト記述を入力するだけで、モデルが多数の監視画像の中から記述に合致する人物を迅速に特定します。
マルチモーダル融合:先進的なニューラルネットワークアーキテクチャにより、Migicianは視覚情報と言語情報を効果的に統合し、画像横断の意味的関連性を深く掘り下げます。たとえば、「一連の都市景観画像から赤い車が含まれる画像を特定する」タスクを処理する際、モデルは画像から色や形状などの視覚特徴を抽出すると同時に、テキスト内の「赤い車」の意味情報を解析し、それらを融合することで、より正確にターゲットを特定します。
CoT(Chain-of-Thought)推論最適化:MigicianはCoT推論最適化を導入し、複雑な問題を複数の単純なサブ問題に分解し、最終的な答えへと段階的に導きます。たとえば、特定の部屋内の物品を特定する際、モデルはまずテキスト記述に基づいてその部屋の所在可能性エリアを判断し、その後そのエリア内の画像で物品を精密に特定します。
エンドツーエンドフレームワーク:Migicianはエンドツーエンドのフレームワークを採用し、複数画像の入力を直接処理することで、従来の段階的推論手法における誤差の蓄積や効率の低下の問題を回避しています。
モデル性能
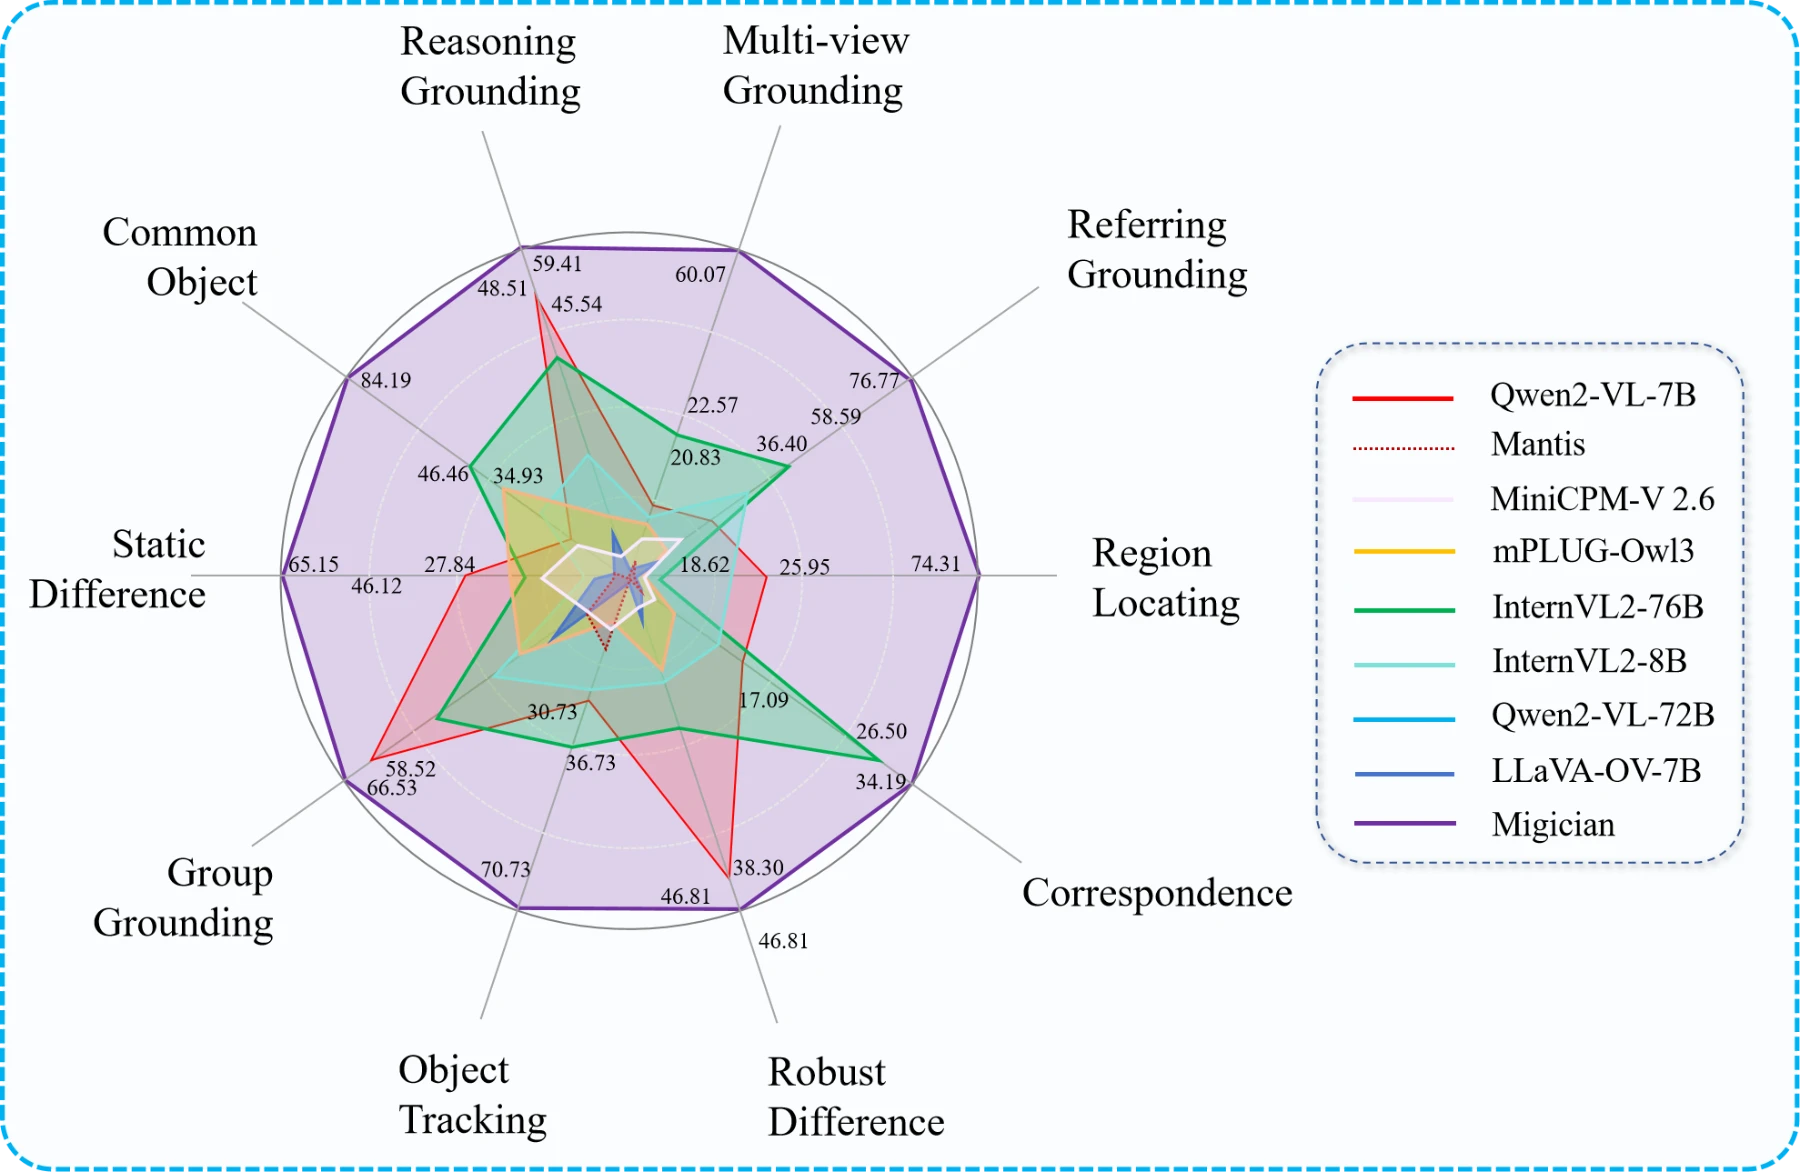
性能パフォーマンス:Migicianは、複数画像位置特定タスクにおいて優れた性能を発揮し、既存のMLLMを大幅に上回り、複数のタスクではより大規模な70Bモデルをも凌駕します。具体的には、MIG-BenchにおけるMigicianの性能は、既存の最良のMLLMよりも21.61%高くなっています。
評価指標:MIG-Benchは[email protected]、[email protected]、[email protected]、平均IOUなどの評価指標を提供しており、ユーザーはMIG_bench_eval.pyスクリプトを実行することでワンクリックで評価できます。
Migicianの応用シナリオ
警備監視:複数の監視カメラの映像をリアルタイムに分析し、不審な人物、車両、または異常事象を迅速に特定します。
自動運転:車両の複数のセンサーから取得した画像情報を融合し、道路、障害物、標識などに関するテキスト記述と組み合わせることで、車両が周囲の環境をより正確に認識することを支援します。
医療画像:複数の医用画像から病変領域を迅速に特定し、病気の診断を補助します。
ロボットエンボディド・インテリジェンス:複雑な環境下でロボットが目標物体を迅速に特定し、把持や運搬などのタスクを完了するのを支援します。
Migicianのプロジェクトリソース
GitHubリポジトリ:https://github.com/thunlp/Migician
論文リンク:https://arxiv.org/pdf/2501.05767
Migicianは、複数画像位置特定タスク専用の強力なツールです。大規模データセットMGrounding-630kと総合テストベンチマークMIG-Benchを活用することで、複数画像シナリオにおける位置特定能力が大幅に向上しています。









