
 脚本プランナー▸
 AIアプリ
 AIニュース
VLM-R1:高い安定性と汎化能力を備えたR1スタイルの視覚言語モデル
小编 ·

VLM-R1:高い安定性と汎化能力を備えたR1スタイルの視覚言語モデル
VLM-R1とは?
VLM-R1(Visual Language Model - R1)は、Om ai Labチームによって開発された、完全に新しいオープンソースの視覚言語モデルです。その核心は、DeepSeek R1の方法を視覚言語領域に успешно 移行した点にあり、より高い安定性と汎化能力を実現しています。
VLM-R1はQwen2.5-VLをベースに構築されており、強化学習によって視覚理解能力を向上させています。視覚タスク、特にドメインをまたいだデータ理解において、従来のSFTモデルよりも優れたパフォーマンスを示し、強力な視覚コンテンツ理解能力を備えており、マルチモーダルAIの発展における重要なブレークスルーの一つです。
VLM-R1の技術背景:
VLM-R1のインスピレーションは、DeepSeekチームが昨年オープンソース化したR1方法に由来しています。この方法はGRPO(Group Relative Policy Optimization)強化学習技術を採用し、純粋なテキスト大規模モデルにおいて顕著な成果を上げました。VLM-R1チームはこの方法を視覚言語モデルに適用し、マルチモーダル領域の新しい局面を成功裏に切り開きました。
VLM-R1の主な特徴:
ドメインをまたいだ堅牢性:複雑で変化に富むアプリケーション環境においても、VLM-R1は高いレベルのパフォーマンスを維持することができます。
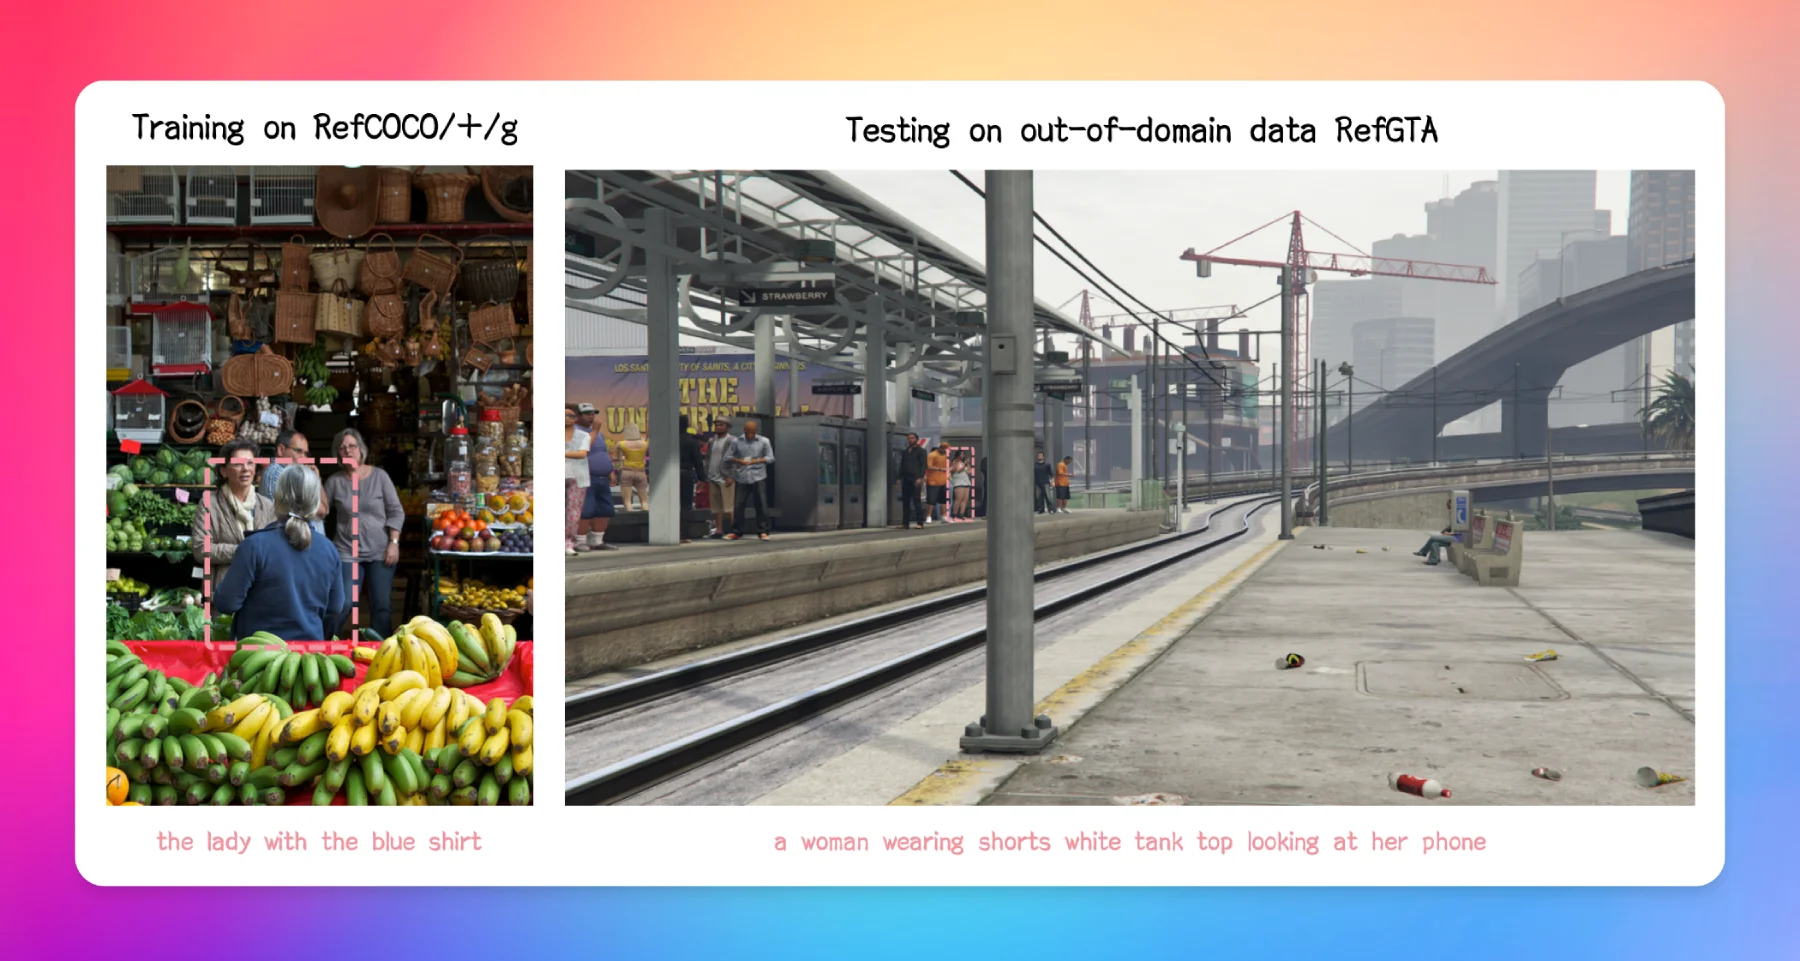
優れた汎化能力:従来の教師あり微調整(SFT)とは異なり、VLM-R1は未確認のタスクやデータ分布外の状況においても、時間の経過とともにその性能が継続的に向上し、強力な適応性と柔軟性を示します。
高い使いやすさ:完全なトレーニングと評価プロセスにより、ユーザーはわずかな手順で迅速に導入し実験を開始することができ、高度なAI技術を活用したい研究者やエンジニアにとって非常に便利です。
効率的なリソース利用率:動的最適化技術により、単一のGPUで大規模パラメータ(数十億レベルにも達する)モデルのトレーニングが可能となり、ハードウェアコストの门槛を下げると同時に効率を向上させます。
VLM-R1の技術実装:
VLM-R1はQwen2.5-VL的基础上で、R1と従来のSFT方法を比較しました。結果として、R1モデルは安定性、汎化能力、理解の深さなどの面で従来のSFTモデルよりも優れていることが示されました。さらに、VLM-R1は実際のケースを通じて、視覚認識、知識推論、テキスト表現におけるその専門能力を示しました。
VLM-R1の応用シナリオ:
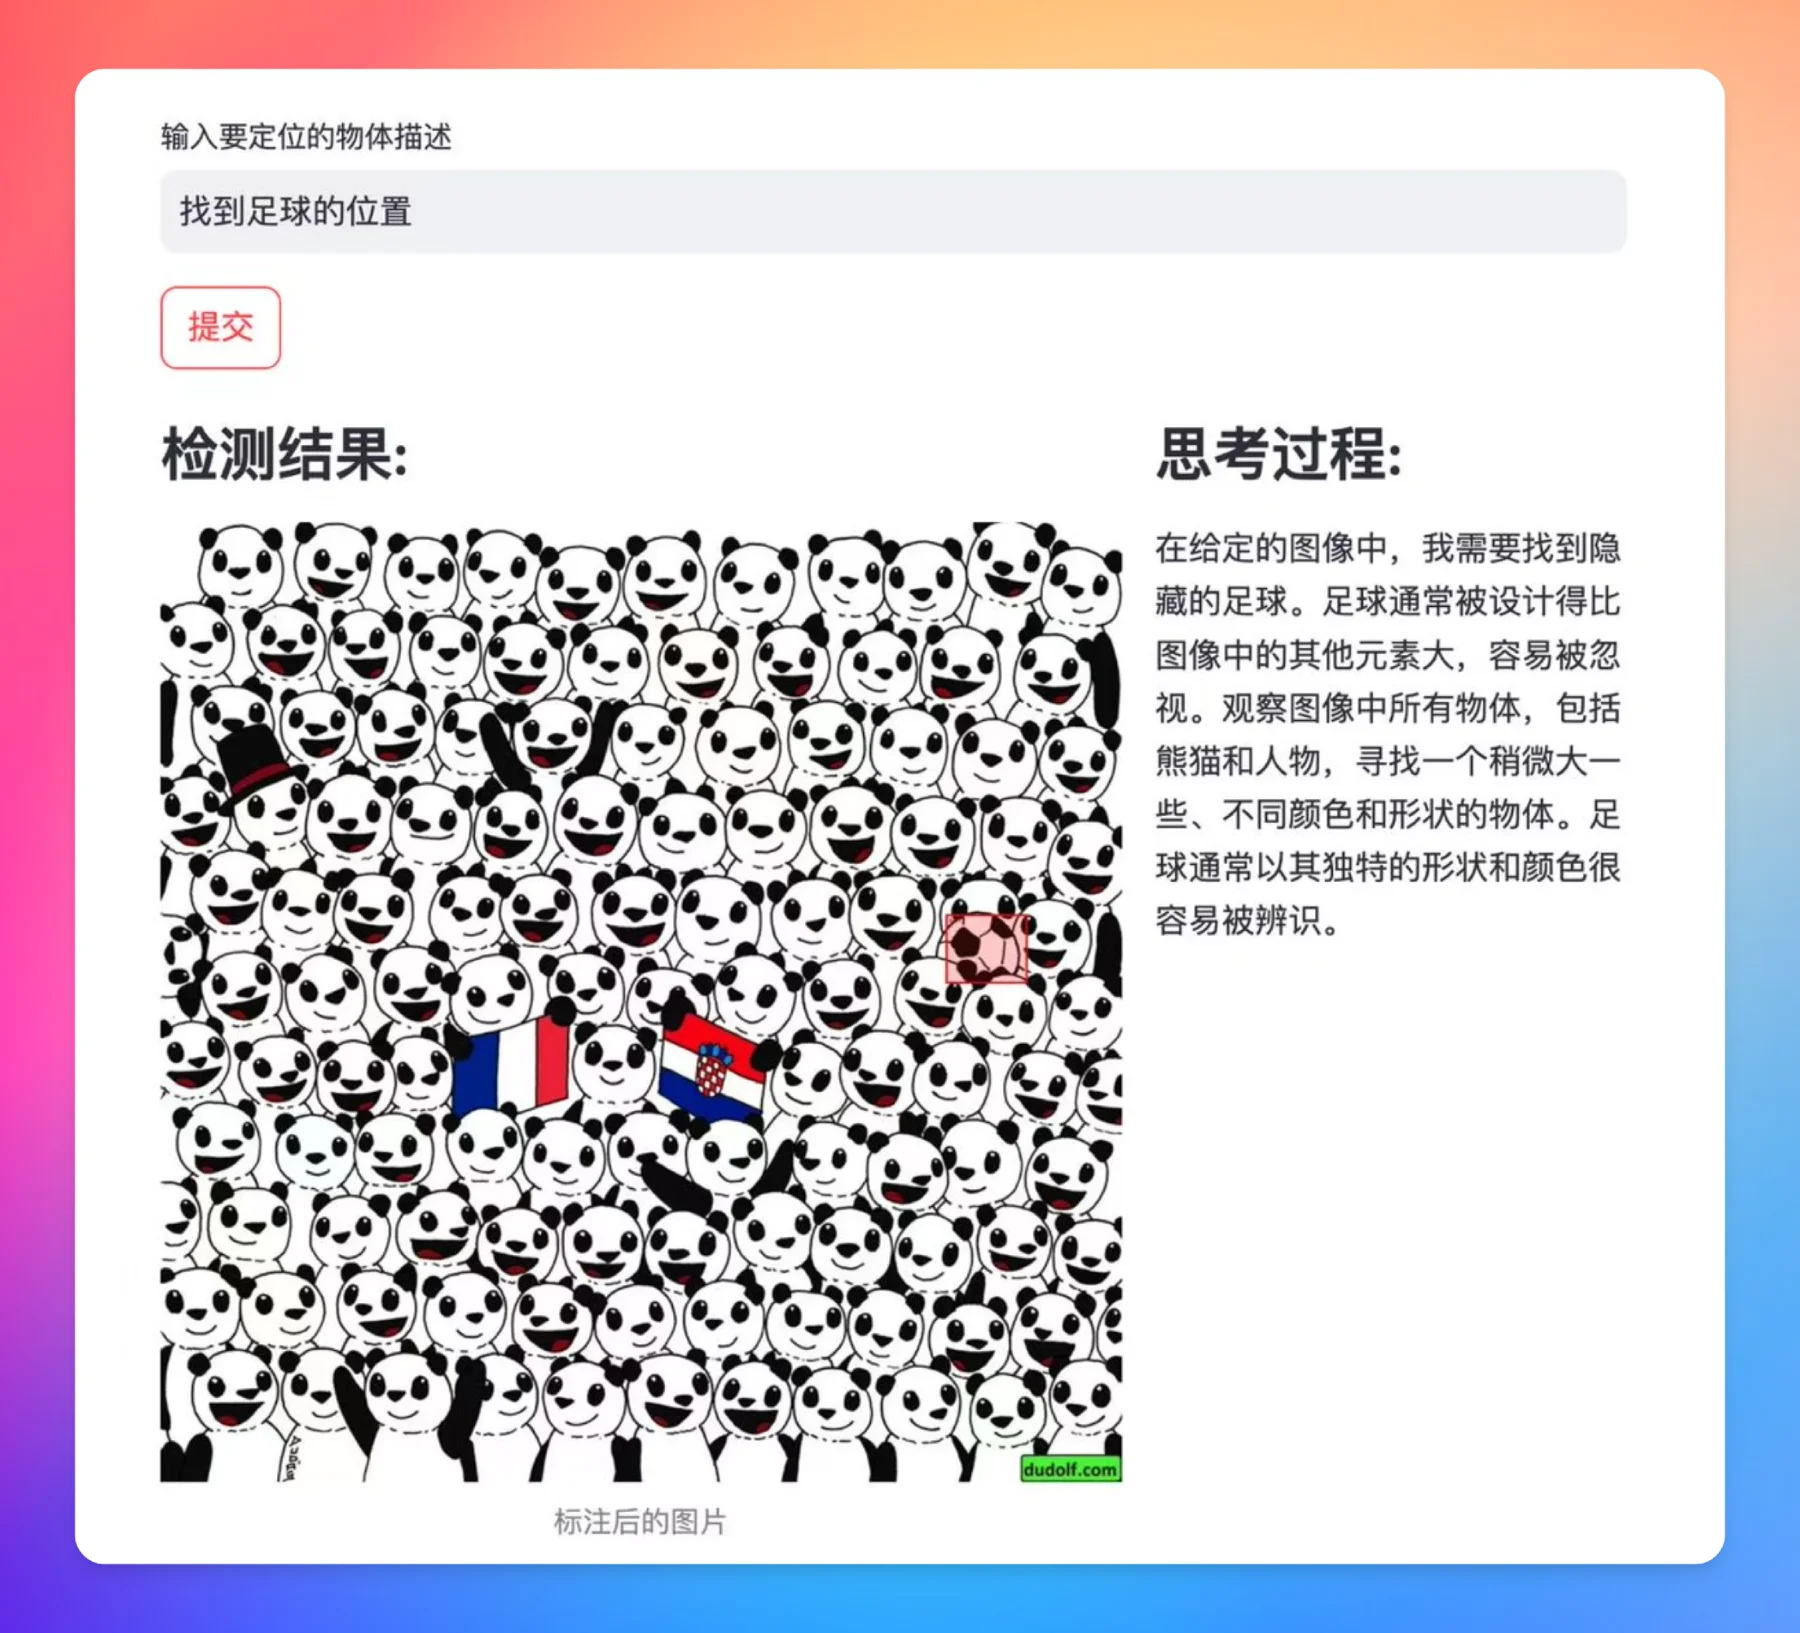
VLM-R1は複数の実用的なアプリケーションで優れたパフォーマンスを発揮しています。例えば、インテリジェントアシスタント、自動運転システム、バーチャルリアリティなどの分野において、その強力な処理能力と柔軟性により、マルチモーダルインタラクションにおいて幅広い応用の可能性を秘めています。具体的なデモケースとして、多様な食材を含む写真が与えられた場合、VLM-R1はタンパク質含有量の高い食品である卵焼きを正確に識別し、さらにその理由を説明しました。また、画像内でマークされたオブジェクトの位置を正確に特定することもでき、卓越したテキスト生成、論理的推論、視覚知覚の総合能力を発揮しています。
VLM-R1の関連リンク:
GitHubリポジトリ:https://github.com/om-ai-lab/VLM-R1
デモ:https://huggingface.co/spaces/omlab/VLM-R1-Referral-Expression









