
 脚本プランナー▸
 AIアプリ
 AIニュース
LLM究極訓練ガイド:大規模GPUクラスタで大規模言語モデルを学習(中文版)
小编 ·

LLM究極訓練ガイド:大規模GPUクラスタで大規模言語モデルを学習(中文版)
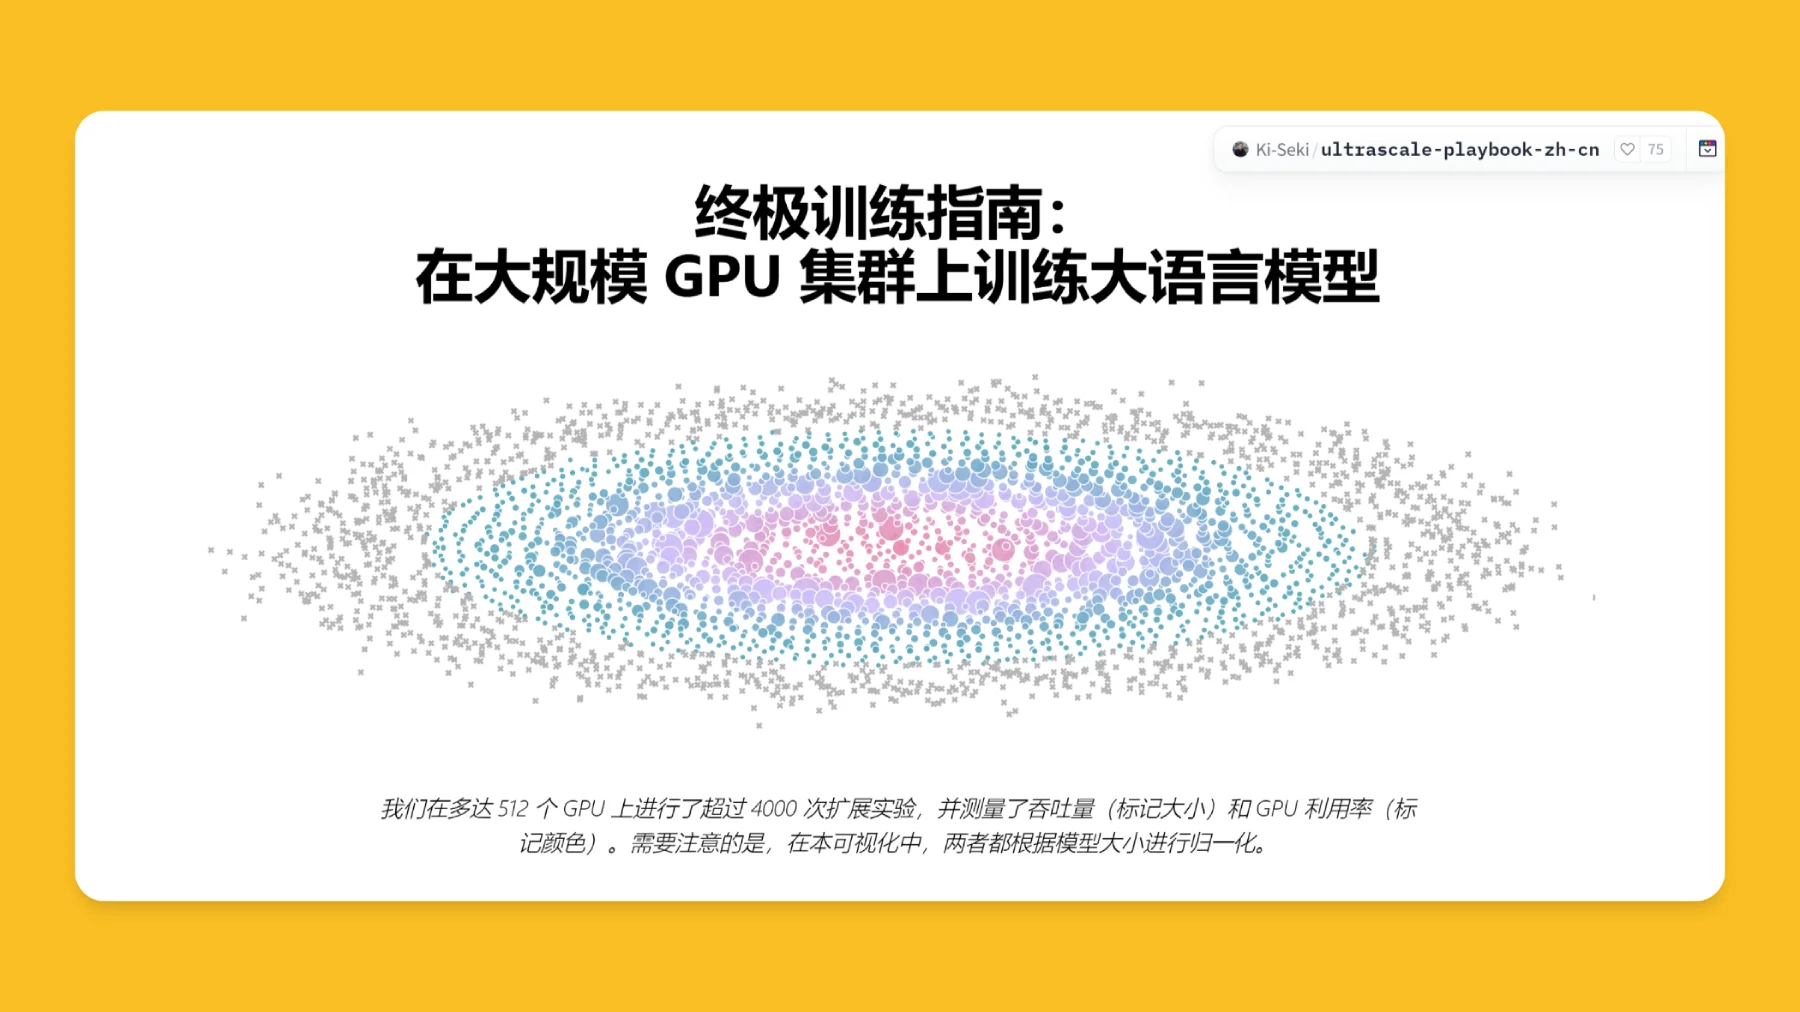
Hugging Faceは「Ultra-Scale Playbook」というガイドを公開しました。中国語名称は「LLM究極訓練ガイド:大規模GPUクラスター上でのai大規模言語モデルの訓練」で、基礎から始まり、ユーザーが大規模GPUクラスター上で大規模言語モデル(LLM)の訓練をスケールアップするための指針を示しています。このガイドは、1個から1000個以上のGPUクラスターでの訓練に対して包括的な指導を提供し、最大512個のGPUにおけるスケール実験結果を示し、スループットやGPU使用率といったデータについて詳細に分析しています。
原文:The Ultra-Scale Playbook: Training LLMs on GPU Clusters
校正者:@Ki_Seki_here
LLM究極訓練ガイド中国語版のURL:https://huggingface.co/spaces/Ki-Seki/ultrascale-playbook-zh-cn
現在も校正中です...
研究の背景
言語モデルの規模が拡大し続けるにつれ、訓練時に必要な計算リソースが増加し、戦略もますます複雑化しています。そのため、このドキュメントは主に、最大512個のGPUクラスター上での大規模言語モデル(LLM)訓練の進め方に焦点を当てています。
主要内容
膨大な実験記録
ドキュメントには4000件のスケール実験が詳細に記録されています。これらの実験では、スループット(トークンサイズ)とGPU使用率(トークンカラー)が中核的な指標となっています。これらのデータは、訓練プロセスの最適化に信頼性の高い根拠を提供します。
主な実験内容
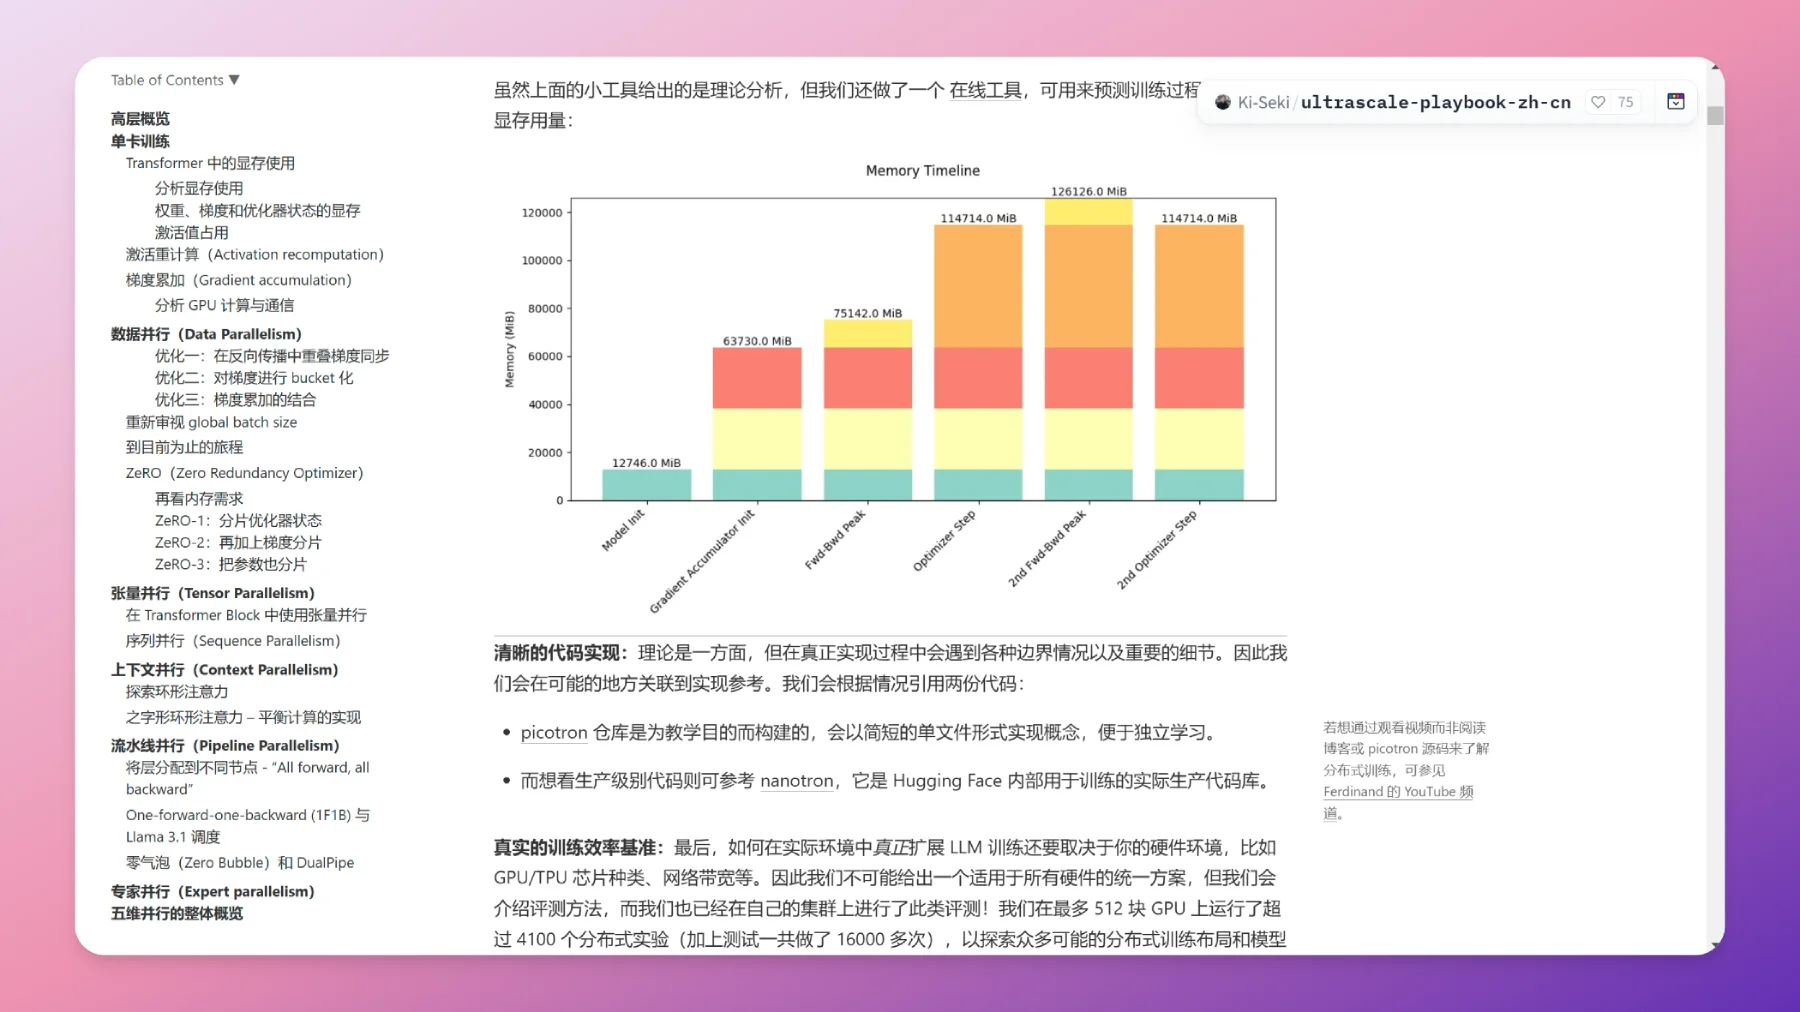
複数GPU訓練アーキテクチャ:採用されているアーキテクチャは、モデルとデータを効果的に分割でき、複数のGPUが関連タスクを並行処理できるようにします。これは効率的な訓練のためのアーキテクチャ基盤となります。
スループットとGPU使用率:実際の実験によるデータ分析を通じて、モデルサイズによって性能が異なります。このような分析は、開発者がリソースを最大限に活用する方法を理解し、自分に適した訓練方法を見つけるのに役立ちます。
実用的なガイドと戦略:ハイパーパラメータの調整方法、適切な訓練バッチサイズの選択など、実用的な訓練戦略がまとめられています。これらは最適な性能を達成するための重要な要素です。
可視化分析:ドキュメントには多数の可視化結果が含まれています。これらの結果により、ユーザーはスケール実験の結果とその背景にある影響要因を直感的に把握でき、複雑な実験結果の解釈が容易になります。
対象読者
このガイドは、大規模データセットや複雑なモデルを取り扱う際に、大規模言語モデルの訓練効率を向上させたい研究者やエンジニアに特に適しています。
実験に関する考察
ドキュメントの特徴と目的
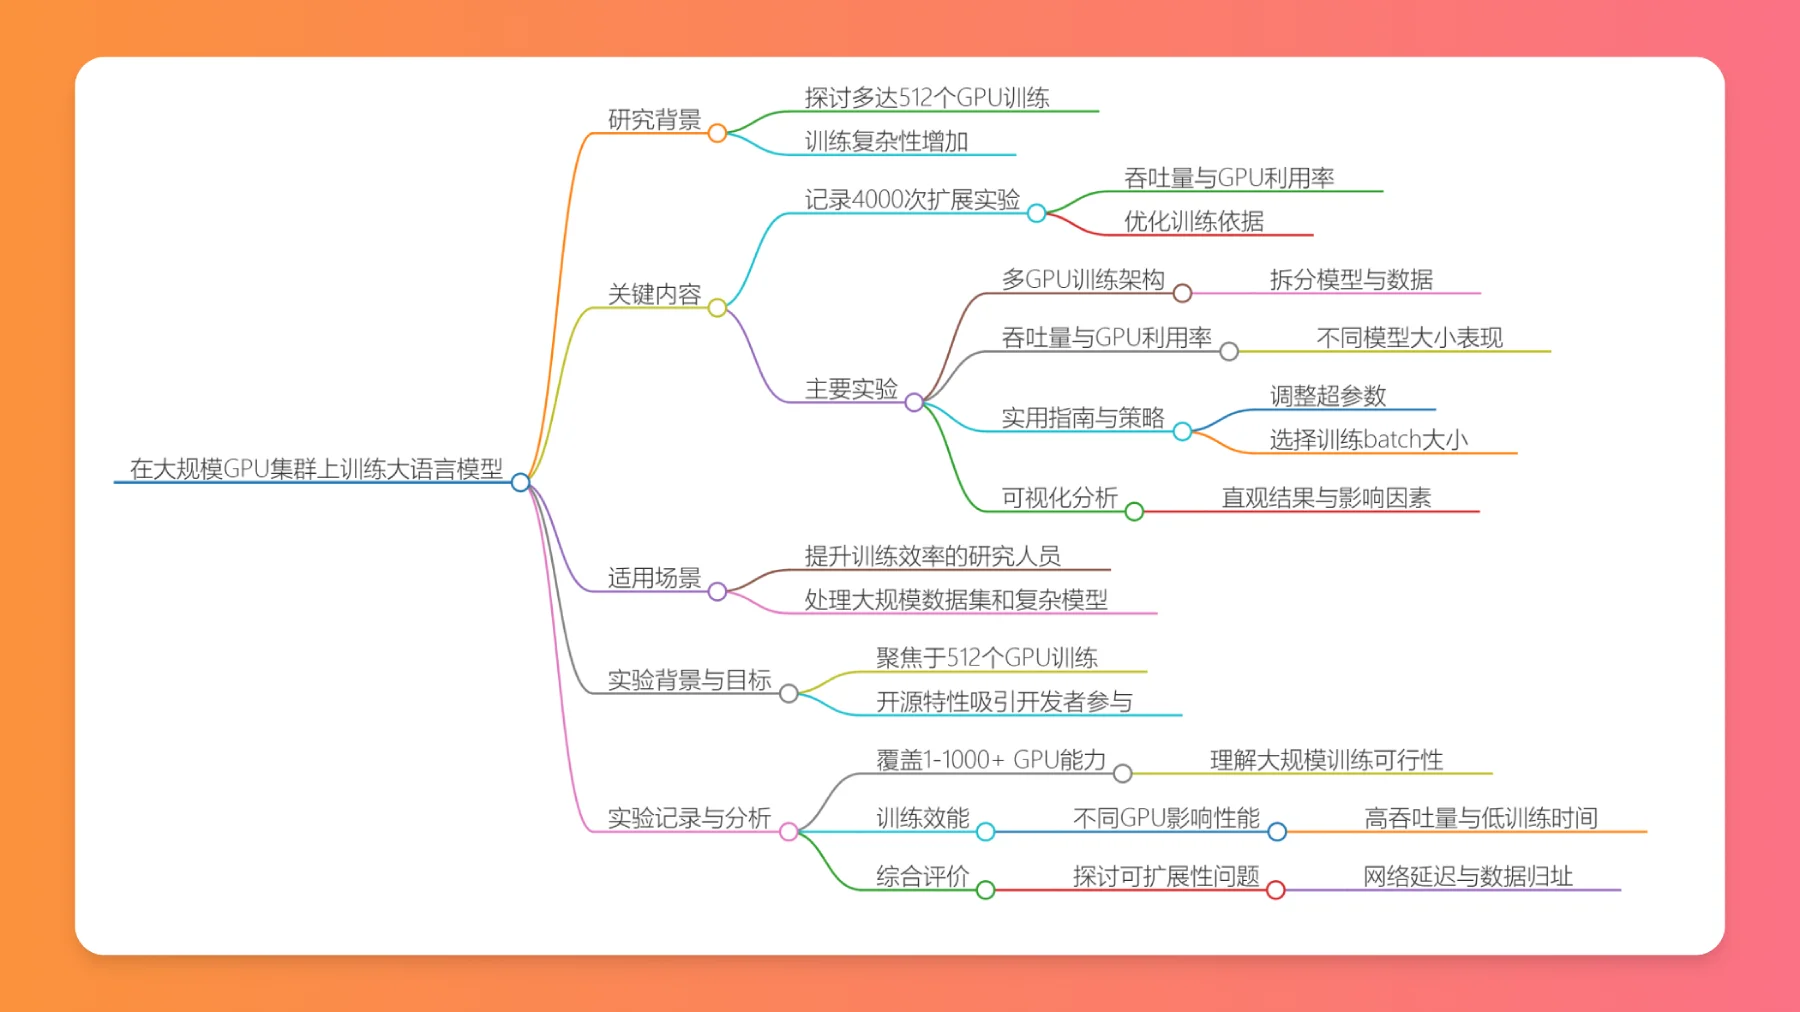
このドキュメントは単に512個のGPU上での訓練方法を説明するだけでなく、そのオープンソース性を強調しています。これにより、より多くの開発者が参加し、これらの訓練方法を活用することが可能になります。
実験記録の範囲
実験記録の範囲は、1個のGPUから1000個以上のGPUまでのスケール能力を網羅しています。これにより、大規模クラスター上でのLLM訓練の実現可能性と効率を理解するための包括的なフレームワークが形成されています。
訓練効率の分析
異なるGPU数が訓練性能に与える影響を観察する際、著者らは一部のモデルがスケール過程においてより高いスループットとより短い訓練時間を実現できることを発見しました。この発見は、開発者がGPU数と構成を選択する際に、より的を絞った提案を提供します。
総合的な考慮事項
性能指標への注目に加えて、この実験では実際のアプリケーションにおけるスケーラビリティの問題も深く検討しています。また、実環境下で遭遇する可能性のある、ネットワーク遅延やデータ配置などの複雑な要素についても研究しており、これらは大規模訓練を実施する際に無視できない要素です。









