
 脚本プランナー▸
 AIアプリ
 AIニュース
OSUM:西北工業大学が开源した複数の音声処理タスクに対応する音声モデル
小编 ·

OSUM:西北工業大学が开源した複数の音声処理タスクに対応する音声モデル
OSUM(Open Speech Understanding Model)は、西北工業大学計算機科学・技術学院のオーディオ、音声、言語処理グループ(ASLP@NPU)によって提案・オープンソース化された音声モデルであり、様々な音声処理タスクをサポートするために使用されます。
OSUMの主な特徴:
マルチタスクサポート:
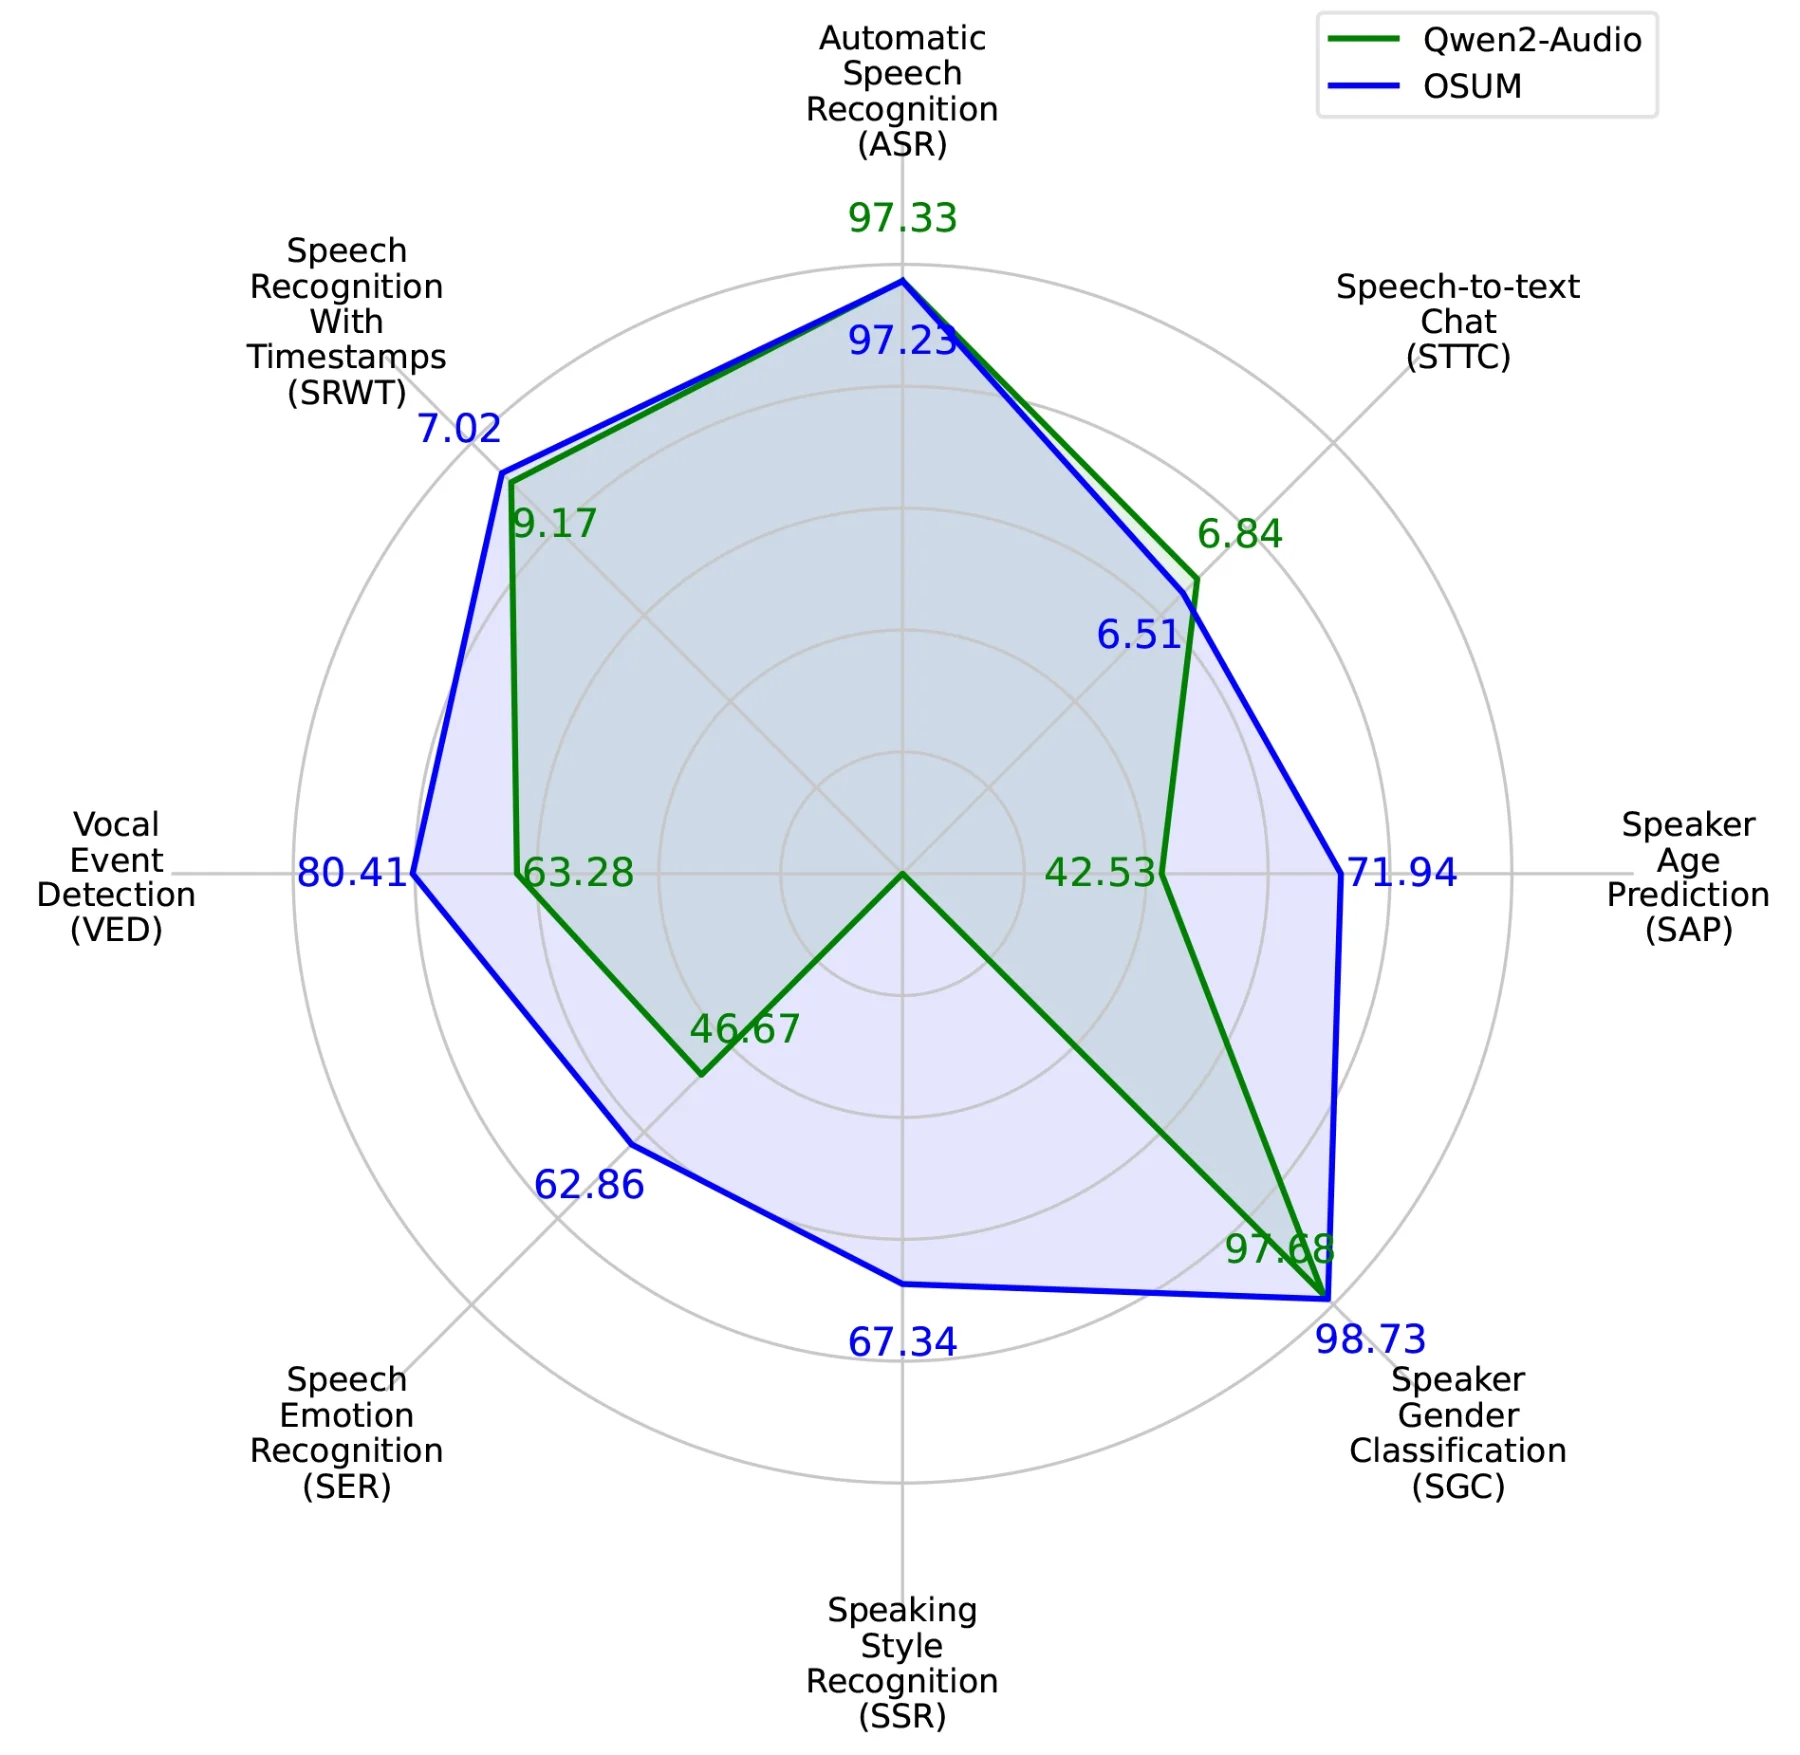
音声認識(ASR):音声をテキストに変換します。
タイムスタンプ付き音声認識(SRWT):音声内容を認識し、時間情報を付与します。
音声イベント検出(VED):音声内の特定のイベントや動作を識別します。
音声感情認識(SER):音声内の感情状態を分析します。
話者スタイル認識(SSR):話者の話し方やトーンを識別します。
話者性別分類(SGC):音声に基づいて話者の性別を判断します。
話者年齢予測(SAP):話者の年齢を推定します。
音声テキストチャット(STTC):音声会話を読み取り可能なテキストに変換します。
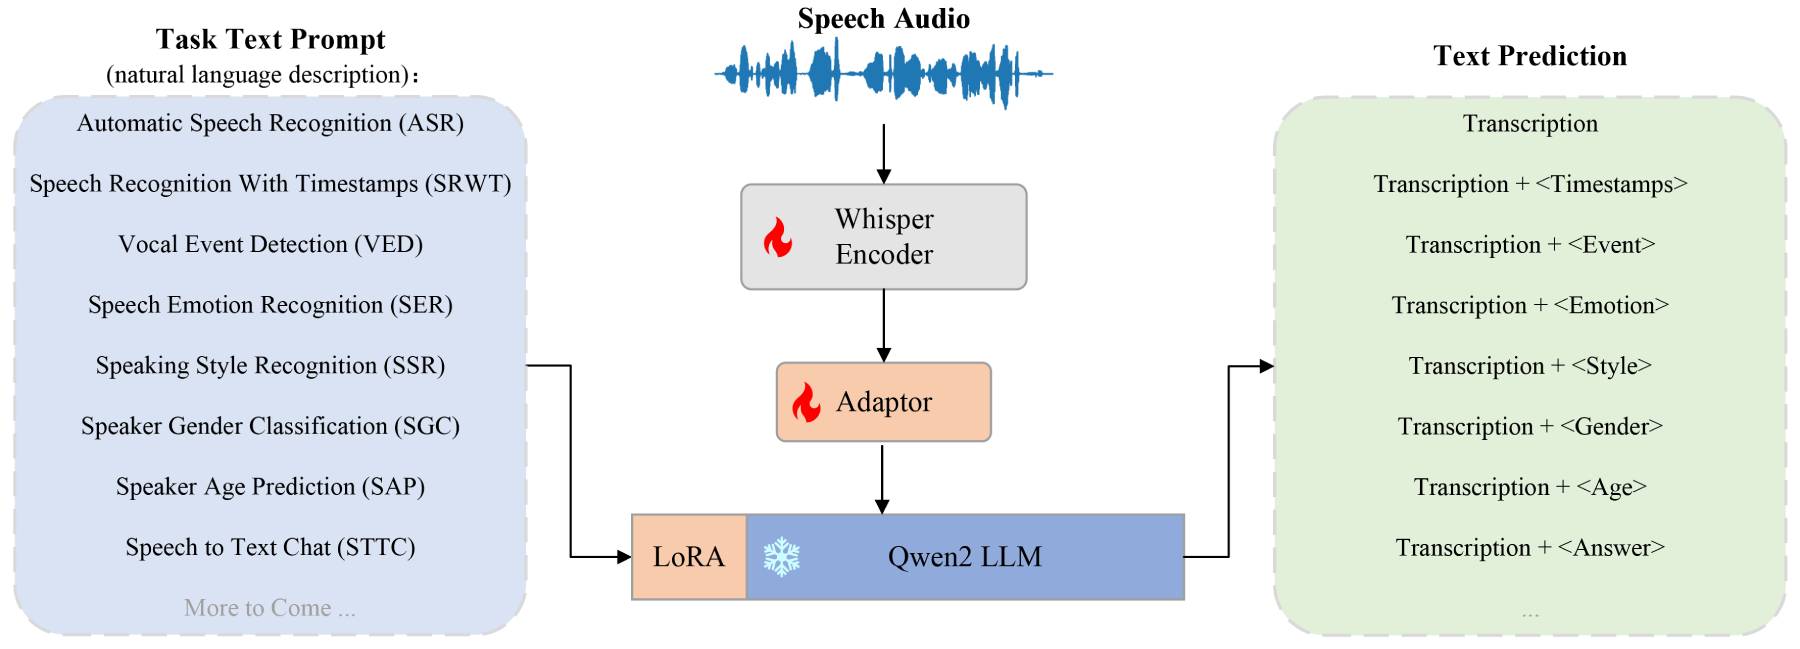
モデルアーキテクチャ:OSUMはWhisperエンコーダーとQwen2大規模言語モデル(LLM)を組み合わせ、LORA技術を用いてLLMを微調整することで、効率的なマルチタスク学習を実現しています。
学習戦略:ASR+X学習戦略を採用しており、自動音声認識(ASR)と補助的なタスク(X)を同時に最適化することで、効率的かつ安定したマルチタスク学習を実現し、リソース消費を削減しています。
深層理解機能:OSUMモデルは音声情報をテキストに変換する能力を備えており、同時に音声内の感情認識もサポートしているため、ユーザーにより知的なインタラクション体験を提供します。
タイムスタンプサポート:音声認識において、OSUMはタイムスタンプ付きの出力に対応しており、後続の処理や分析を容易にします。
マルチプラットフォーム互換性:異なるコンピューティングプラットフォームでの実行をサポートしており、Huawei Ascend 910BやNVIDIAプラットフォームを含むため、応用の柔軟性が高まっています。
OSUMの活用例:
スマートアシスタント:スマートホームやバーチャルアシスタントにおいて、ユーザーの音声コマンドを理解し応答するために使用されます。
多言語サービス:YouTube Dubbingプラグインのように、リアルタイムの翻訳や吹き替えに利用することで、言語の壁を越えることができます。
感情分析:カスタマーサービスやメンタルヘルスアプリケーションでユーザーの感情を分析し、パーソナライズされたサービスを提供します。
教育分野:学生の口頭課題を自動的に評価し、フィードバックを提供します。
アクセシビリティ技術:聴覚障害者が音声情報を理解するのを支援します。
市場調査:消費者のフィードバックに含まれる感情や意見を分析します。
音声書き起こし:会議記録や口述の文字変換などの場面で、OSUMを利用して効率的な音声書き起こしを行います。
OSUMの使用方法:
インストールとインポート:ユーザーはHugging FaceページまたはGitHubプロジェクトページからOSUMのコードとモデルの重みをダウンロードし、提供されているインストールガイドに従ってインストールすることができます。OSUMモデルをPython環境にインポートするサンプルコードは以下の通りです:
from osum import OSUM
model = OSUM.from_pretrained("ASLP-lab/OSUM")
タスクの実行:ユーザーはOSUMモデルを使用して、音声認識をはじめとする様々なタスクを行うことができます。以下は音声認識タスクのサンプルコードです:
result = model.transcribe("audio.wav")
print(f"識別結果:{result}")
使用方法に関して、ユーザーは事前学習済みのモデルチェックポイントを利用してファインチューニングを行うことで、特定のタスクにおけるモデルのパフォーマンスをさらに向上させることも可能です。
GitHub:https://github.com/ASLP-lab/OSUM
プロジェクト:https://aslp-lab.github.io/OSUM.github.io/









