
 脚本プランナー▸
 AIアプリ
 AIニュース
SWE-Lancer:OpenAI推出的开源ソフトウェアエンジニアリング能力評価ベンチマーク
小编 ·

SWE-Lancer:OpenAI推出的开源ソフトウェアエンジニアリング能力評価ベンチマーク
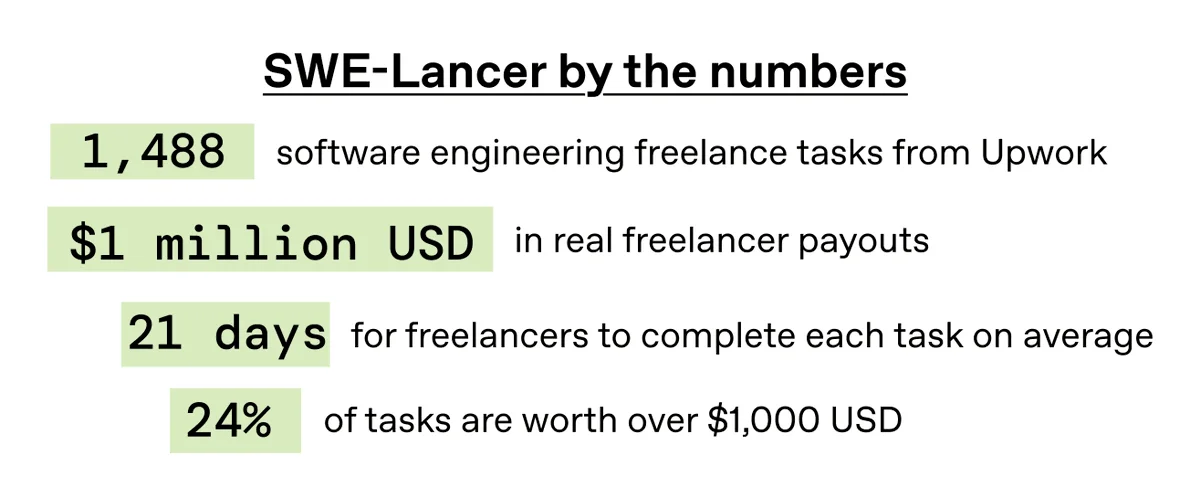
SWE-LancerはOpenaiが発表したベンチマークで、主にオープンソースのソフトウェアエンジニアリング業務に対応するモデルの性能を評価するために用いられます。このベンチマークは、Upworkから収集された1400件以上のタスクを含んでおり、その総価値は約100万ドルです。SWE-Lancerはコードパッチと意思決定能力の評価に焦点を当てており、モデルに複数の選択肢から最良の提案を選ばせることで、エンジニアリングチームの役割業務を可能な限りリアルに再現することを目指しています。
主要な評価軸:
評価タスクの多様性について
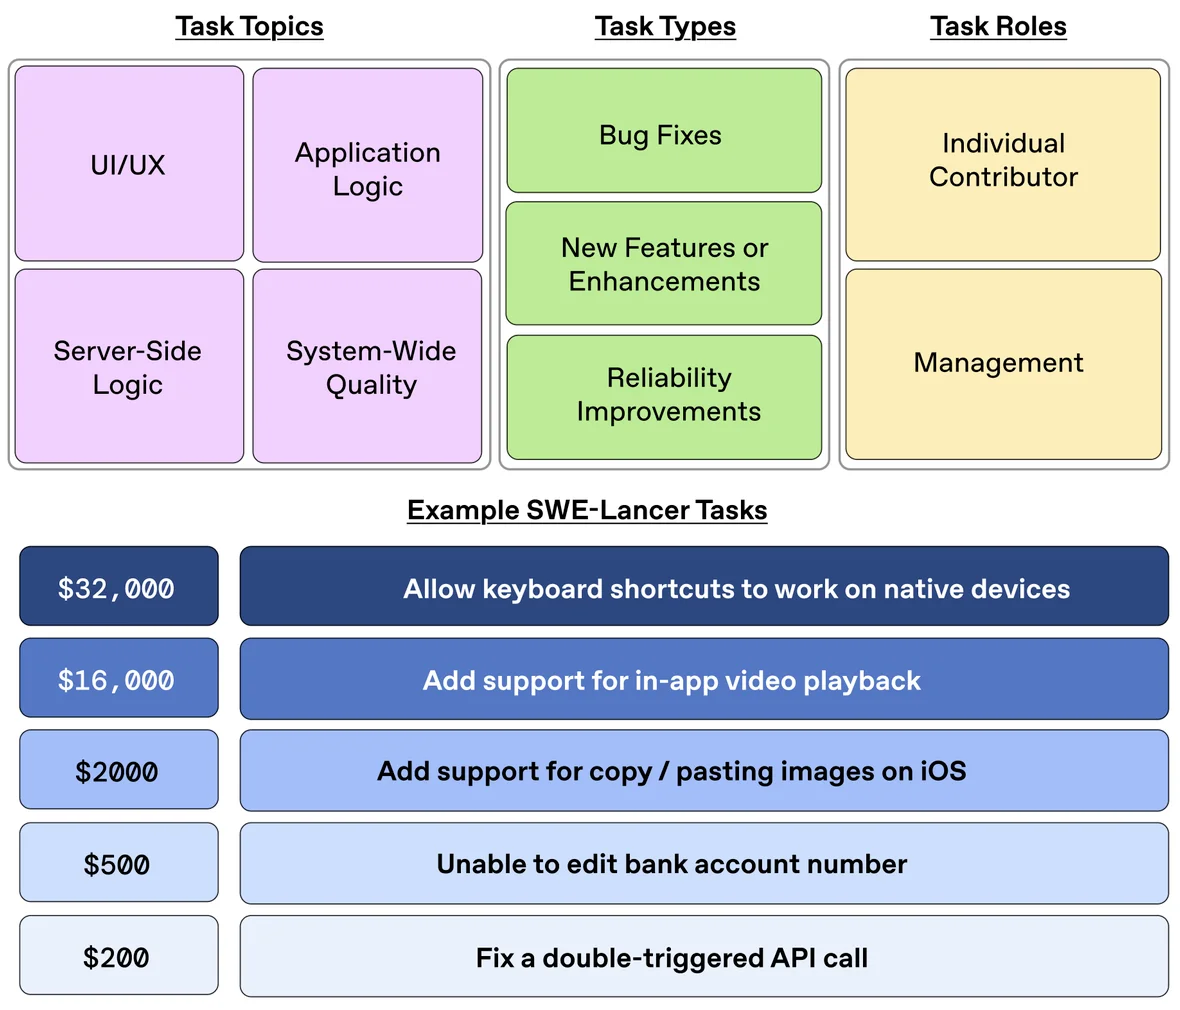
SWE-Lancerはさまざまな種類のソフトウェア開発タスクを網羅しており、モデルの能力を分析するうえで非常に有効なツールとなっています。モデルには提示された複数の選択肢から最適なソリューションを選ばせる必要があり、この方式によってエンジニアリングチームの実務ワークフローをより忠実に反映したベンチマークとなっています。
経済的価値の評価について
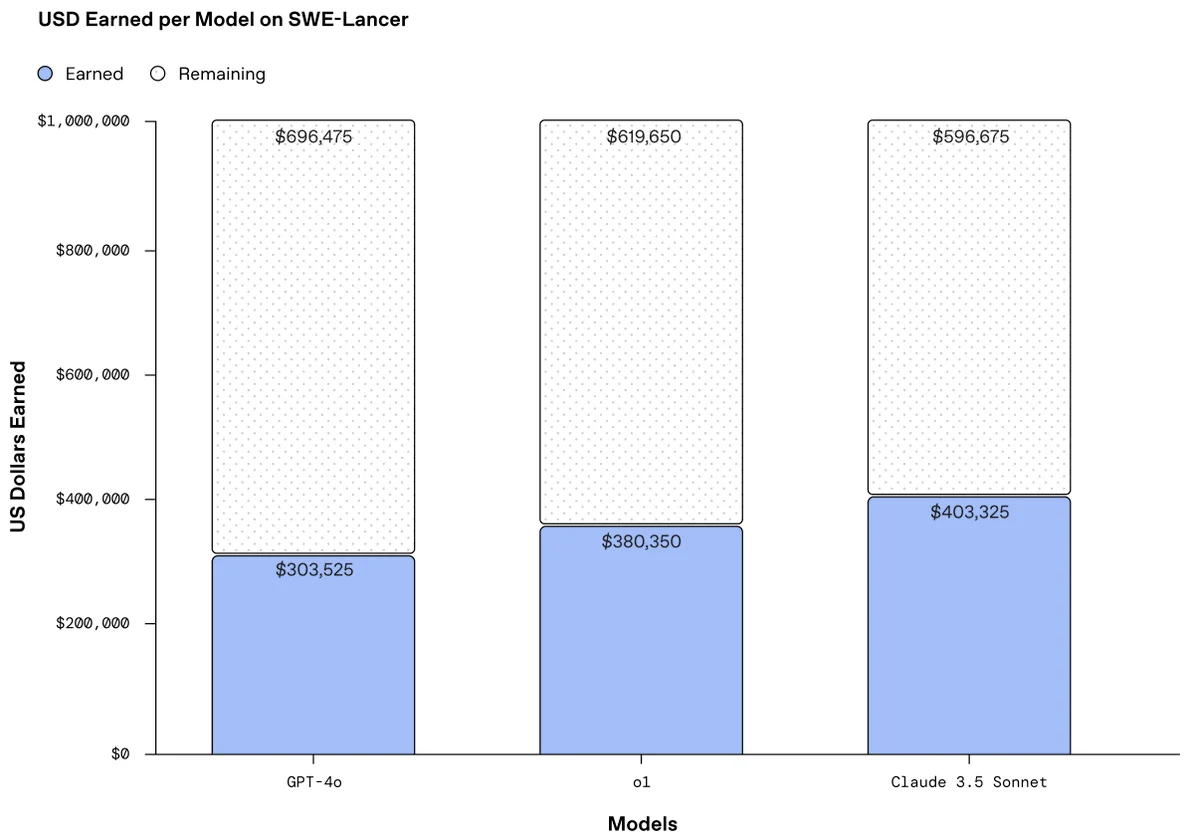
このベンチマークは技術力を評価するだけでなく、タスクの経済的価値も考慮します。この評価手法は、現実世界でのアプリケーションにおけるモデルの有効性を測るための新たな視点を開くものであり、開発者がAIモデルによってもたらされ得る経済的便益をより深く理解するのに役立ちます。
SWE-Lancerの機能と特徴:
現実世界のタスク:SWE-Lancerには一連の実際のソフトウェア開発タスクが含まれており、その範囲は小さなバグ修正から大規模な機能実装にまで及びます。これにより、実際の開発シナリオにおけるモデルの有効な評価が保証されます。
エンドツーエンドテスト:従来のユニットテストと異なり、SWE-Lancerはエンドツーエンドテスト方式を採用しており、モデルが問題全体を処理する能力を必要とします。これはソフトウェアエンジニアの実務における意思決定の流れにより近いものとなっています。
複数選択肢からの評価:モデルは複数の可能なソリューションの中から最良の提案を選ぶ必要があり、これはエンジニアリングチームが問題に直面したときの意思決定プロセスを模擬しています。
経済的価値のマッピング:タスクの価値は合計で100万ドルにのぼり、これは一方でタスクの複雑さと重要性を示し、他方ではモデルのパフォーマンスがもたらし得る潜在的な経済的影響を示しています。
SWE-Lancerの用途:
モデル性能評価:研究者と開発者のためにテストプラットフォームを提供し、大規模言語モデルのソフトウェアエンジニアリングタスクにおけるパフォーマンスをテスト・比較するために使用できます。
ソフトウェア開発支援:長期的には、SWE-Lancerはソフトウェア開発における人工知能の応用を最適化するのに役立つ可能性があります。例えば自動コードレビューやバグ修正の提案などが挙げられます。
教育とトレーニング:教育ツールとして活用でき、学生や開発者がソフトウェアエンジニアリングのベストプラクティスとそれが直面する課題を理解するのを支援します。
業界標準:ソフトウェアエンジニアリング分野におけるAIの実用性を評価するための業界標準になる可能性があります。
SWE-Lancerの使用方法:
タスクの選択:SWE-Lancerが提供するタスクリストから、評価対象のタスクを1つまたは複数選びます。
モデルによる処理:選択したタスクをAIモデルに入力すると、モデルは自身の学習状況と能力に基づいてタスクを実行します。
結果の評価:モデルが生成した結果を評価し、事前に設定された品質基準を満たしているかどうかを確認するとともに、タスクの経済的価値に基づいて分析を行います。
論文:https://arxiv.org/abs/2502.12115
詳細:https://openai.com/index/swe-lancer/









