
 脚本プランナー▸
 AIアプリ
 AIニュース
NSA:DeepSeekが発表した超長文コンテキストの学習・推論を高速化する技術
小编 ·

NSA:DeepSeekが発表した超長文コンテキストの学習・推論を高速化する技術
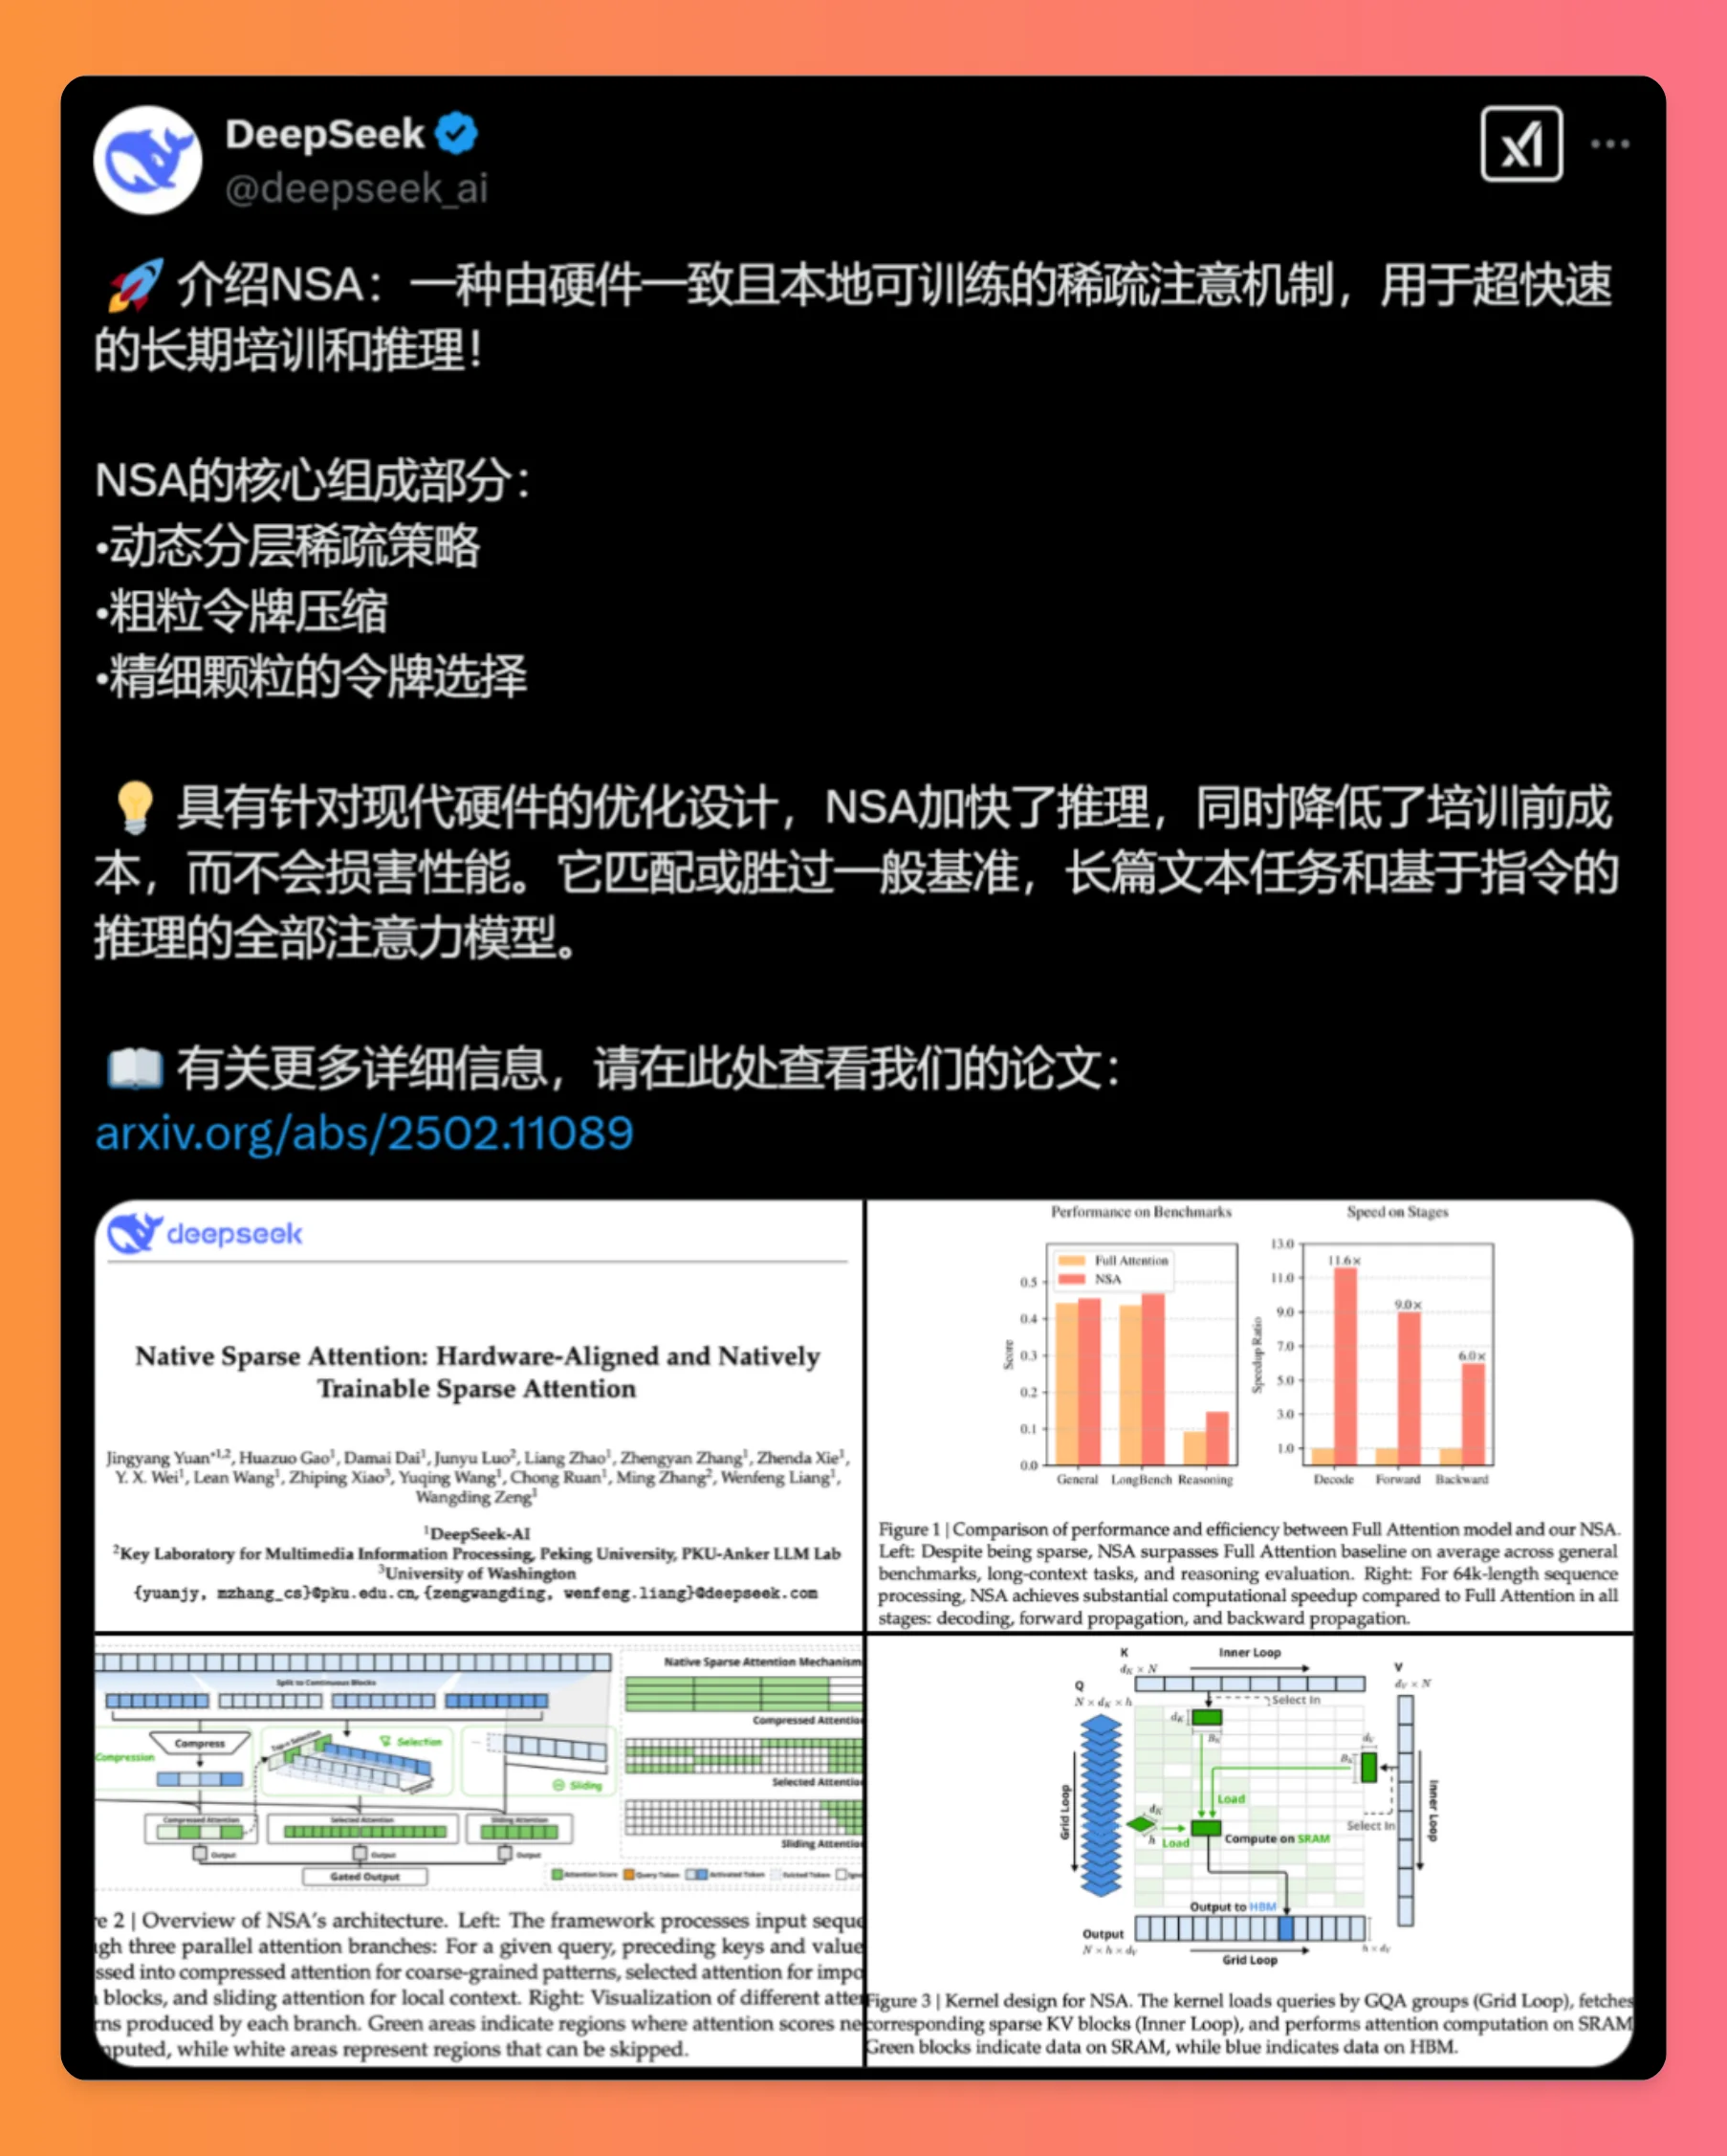
DeepSeekチームは2025年2月18日に、NSA(Native Sparse Attention)と呼ばれる革新的な注意機構を発表しました。NSAは長文処理における計算効率と性能の課題解決に取り組んでおり、ハードウェア整合型の設計とネイティブ学習サポートにより、推論速度を大幅に向上させ、事前学習のコストを削減します。
NSAの主な特徴:
ハードウェアフレンドリー:さまざまなハードウェアアーキテクチャとの互換性を考慮して設計されており、学習効率の向上を目指しています。
ネイティブ学習能力:データ上で直接学習をサポートし、モデルの適応性と柔軟性を強化します。
高効率な推論と学習:長コンテキスト処理を加速し、複雑なモデルの応用を支援し、テキストや動画などのより長いシーケンスデータに効果的に対応します。
動的階層スパース戦略:細粒度のトークン選択と粗粒度のトークン圧縮技術を活用し、情報を保持しながら計算の複雑さを軽減します。
コスト削減:最適化された設計により、ディープラーニングモデルの学習時に必要な時間と計算コストなどのリソース消費を大幅に削減し、研究者や開発者にとって価値があります。
NSAのコア構成:
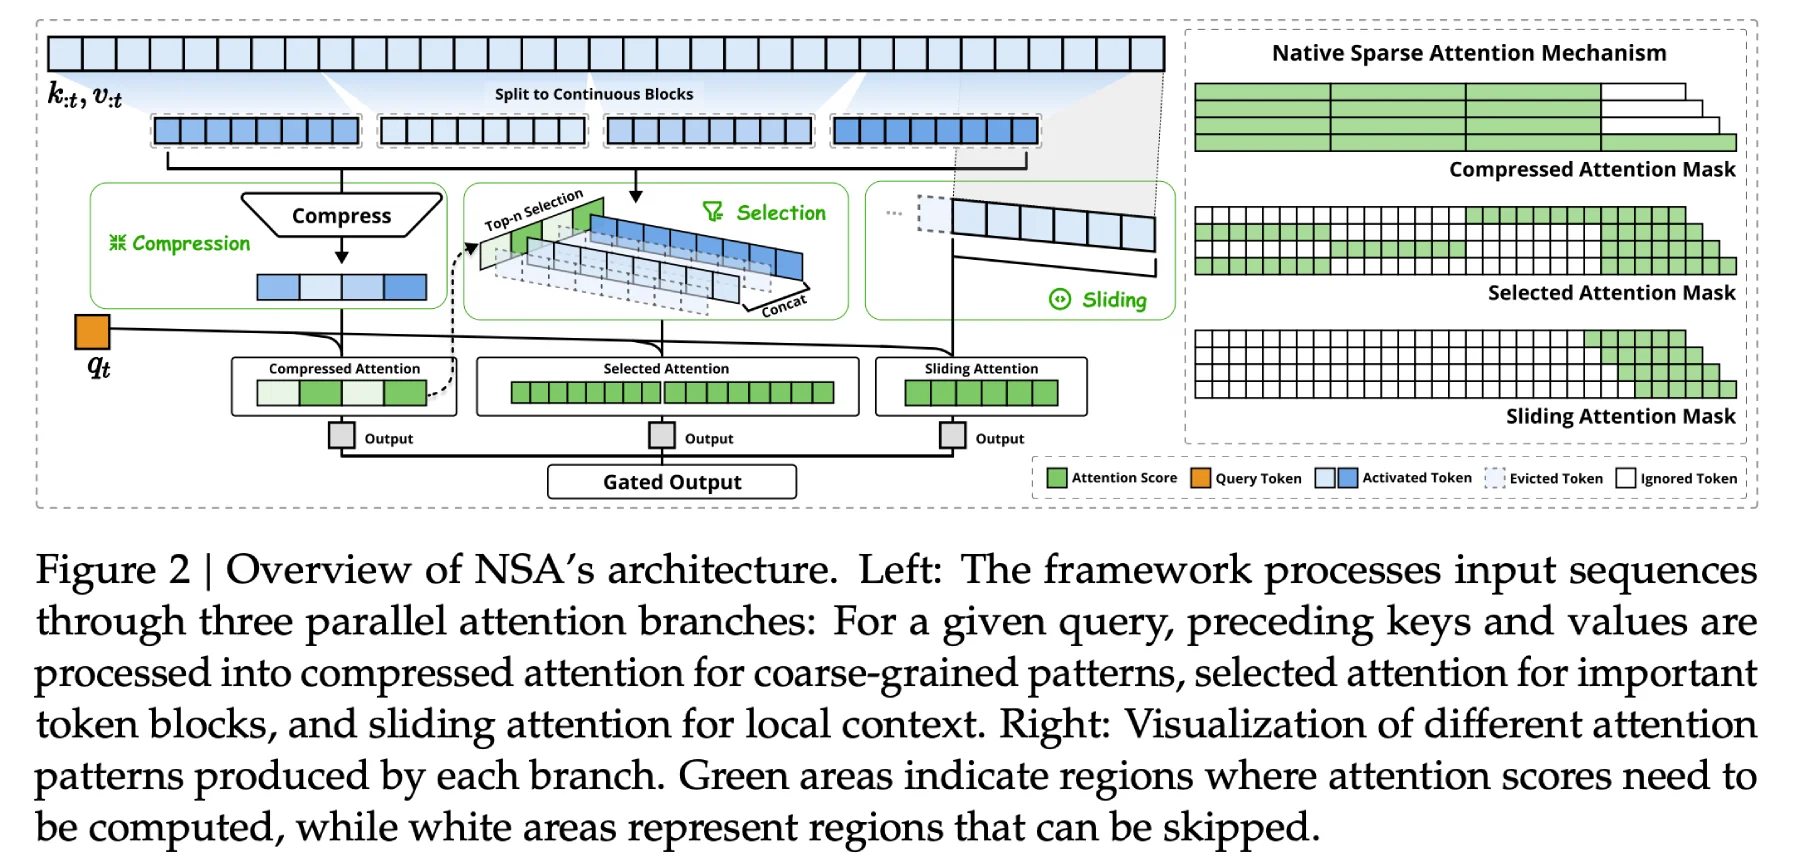
動的階層スパース戦略:粗粒度のトークン圧縮と細粒度のトークン選択を融合し、効率を高めながら、モデルがグローバルコンテキストとローカル詳細の両方を認識することを保証します。
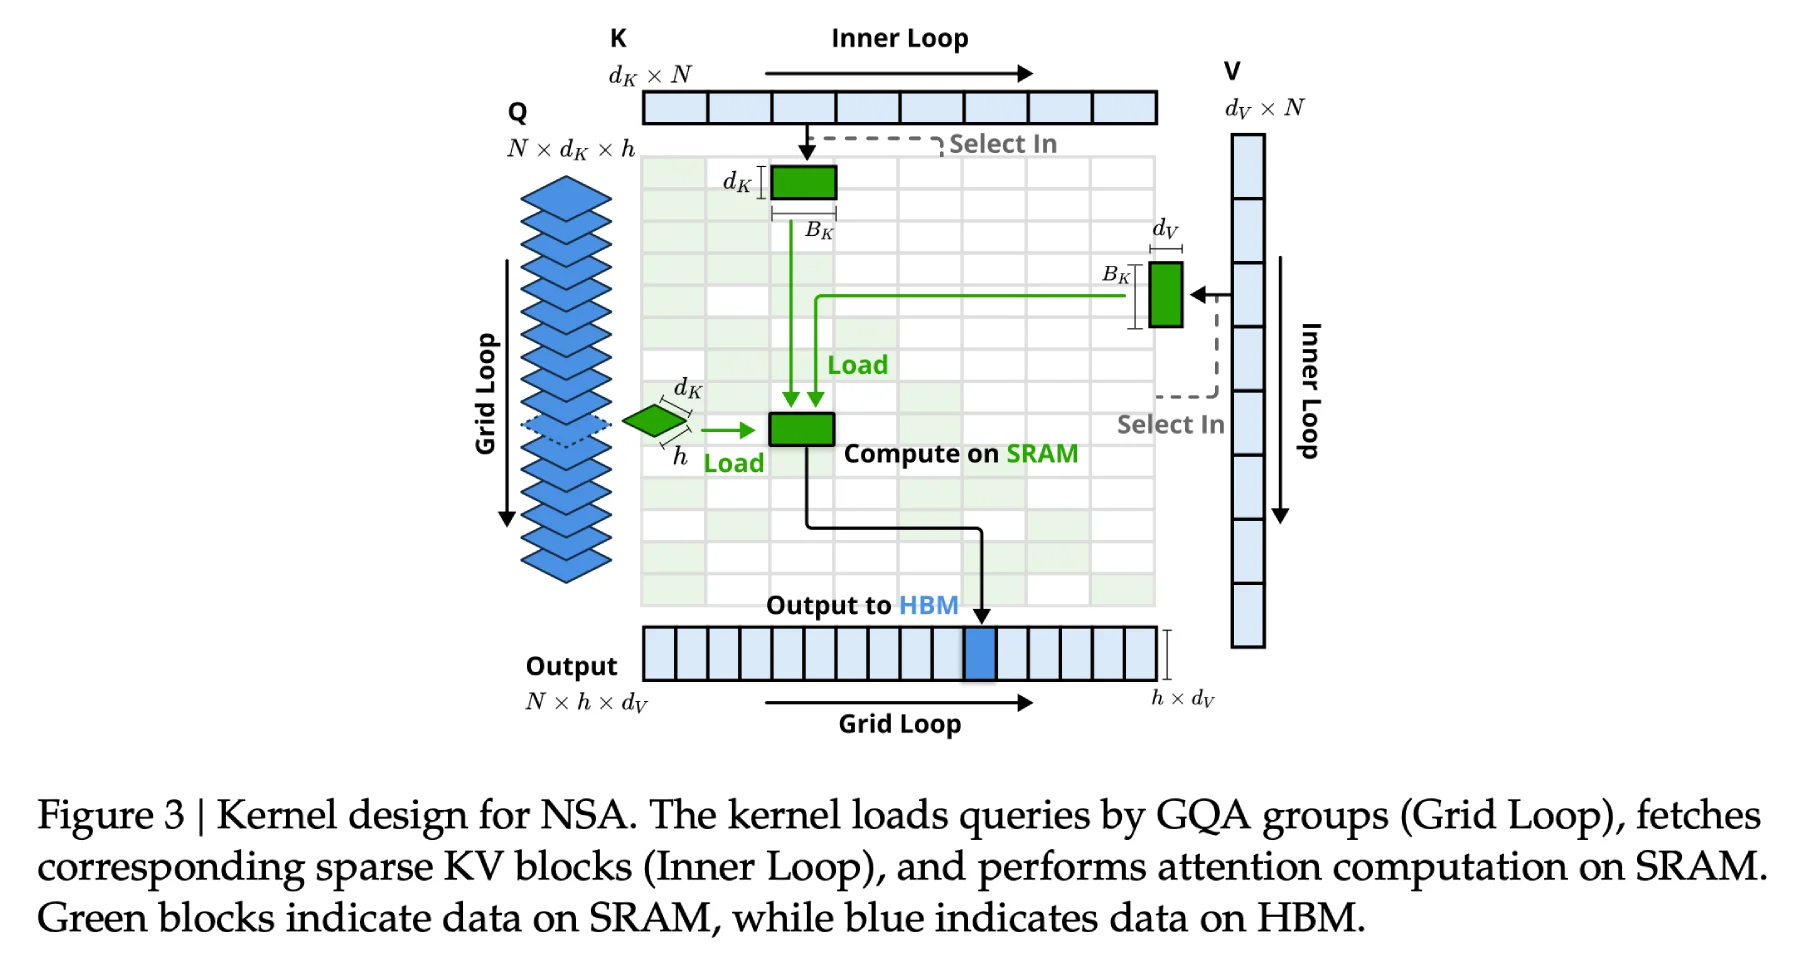
ハードウェア整合設計:メモリアクセスを最適化し、GPUテンソルコアに適応し、データをブロック単位で読み込み、冗長な転送を削減し、並列効率を向上させます。
エンドツーエンドで学習可能:事前学習から推論までのスパース計算の全フローをサポートし、誤差逆伝播の安定性を維持し、従来のスパース手法で見られる「学習落ち」の問題を回避します。
NSAの技術詳細:
動的階層スパース戦略:キーとなる情報と無視可能な情報を柔軟に判断し、情報処理を最適化します。これにより、長コンテキスト処理時にモデルが重要なグローバルセマンティクスを捉えながら、計算負荷を軽減します。
粗粒度トークン圧縮:類似したトークンや重要でないトークンを統合することで、データ処理量を削減し、計算を高速化しつつ、テキストの粗粒度のセマンティクスの理解を維持します。
細粒度トークン選択:圧縮されたデータ内から重要なトークンをさらに選別し、モデルが細部に注目することを保証し、ローカルの正確性を維持し、重要な情報の損失を防ぎます。
スライディングウィンドウ:スライディングウィンドウ機構を利用して局所的なコンテキスト情報をキャプチャし、近接関係の見落としを回避します。
NSAの性能結果:
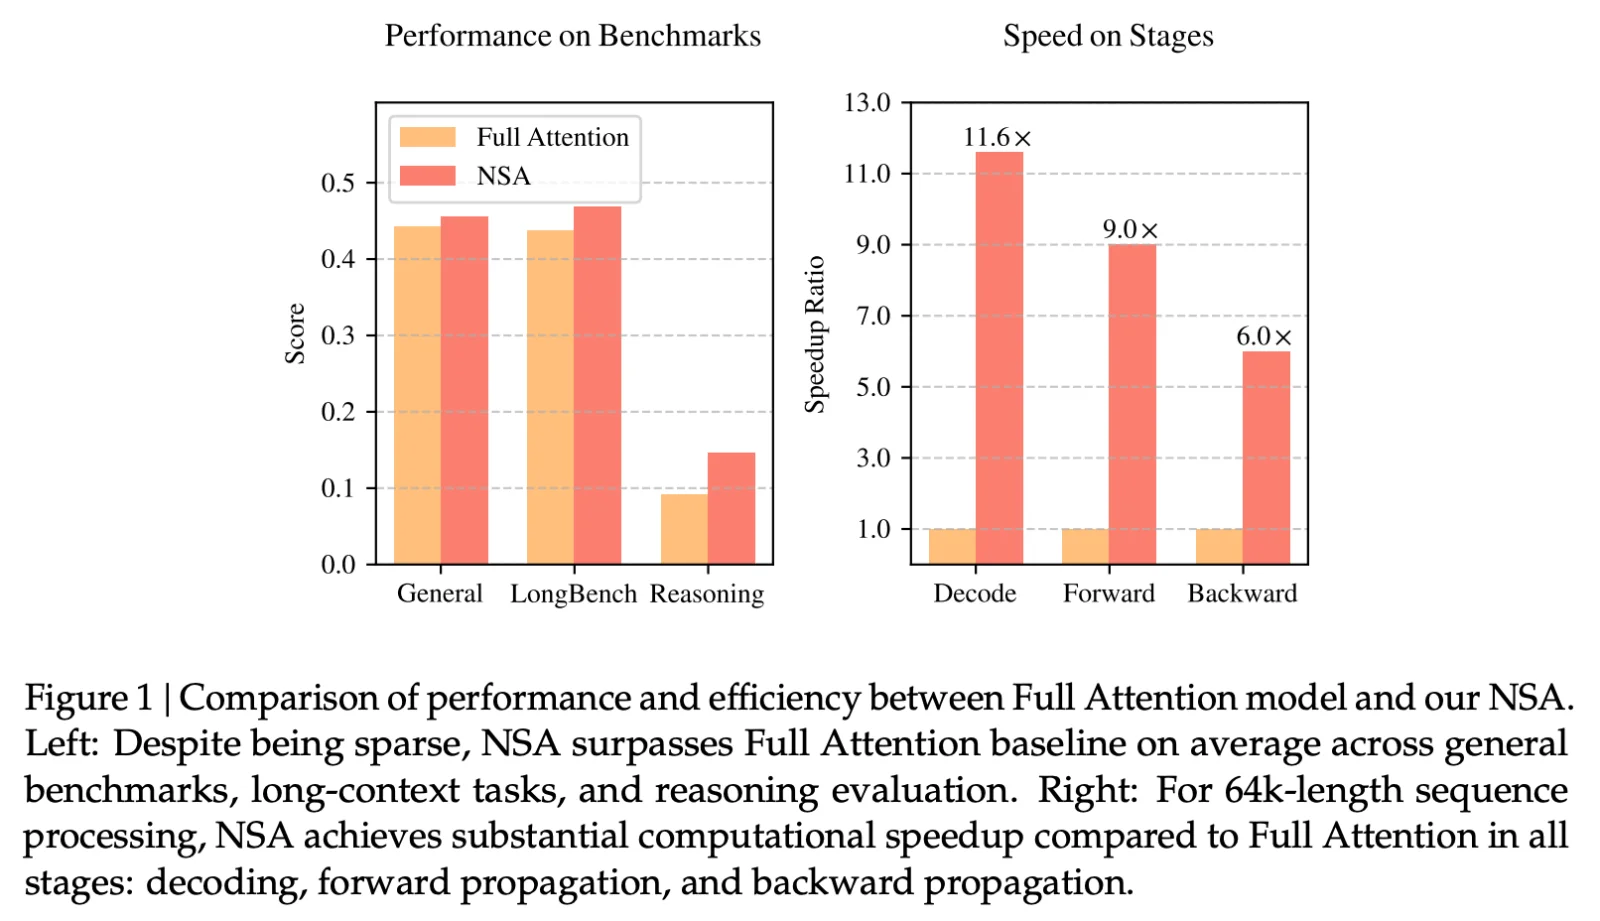
速度向上:64k長のシーケンス処理において、NSAはデコーディング、フォワード伝播、バックワード伝播の各段階で顕著な速度向上を実現し、最大で11.6倍に達します。
優れた性能:複数のベンチマークテストにおいて、NSAはフルアテンションモデルと同等あるいはそれ以上の性能を示し、特に長コンテキストタスクや指示推論において優れています。
NSAの応用分野:
スマートアシスタント:より複雑な多輪対話やパーソナライズされたサービスの実現。
科学計算:物理シミュレーションや工学モデリングにおける長シーケンスデータ処理など。
コード生成とデバッグ:長大なコードベースの理解と高品質なソリューションの生成。
NSAの論文:https://arxiv.org/abs/2502.11089
DeepSeekは汎用人工知能に焦点を置く中国企業であり、AGIのコア技術の探求と製品化に取り組んでいます。DeepSeekは128kコンテキストの長文理解に対応するDeepSeek-V2や、MT-Bench中国語評価で優れた性能を発揮するDeepSeek-R1-Lite-Previewなど、高性能なオープンソースAI大規模モデルを複数発表しています。









