
 脚本プランナー▸
 AIアプリ
 AIニュース
DeepSeek V3とDeepSeek R1の違いは?どちらがあなたに合っている?
小编 ·
DeepSeek V3とDeepSeek R1の違いは?どちらがあなたに合っている?
DeepSeekチームは2つのAIモデルを発表しました。1つはDeepSeek V3、もう1つはDeepSeek R1で、この2つにはかなりの違いがあります。
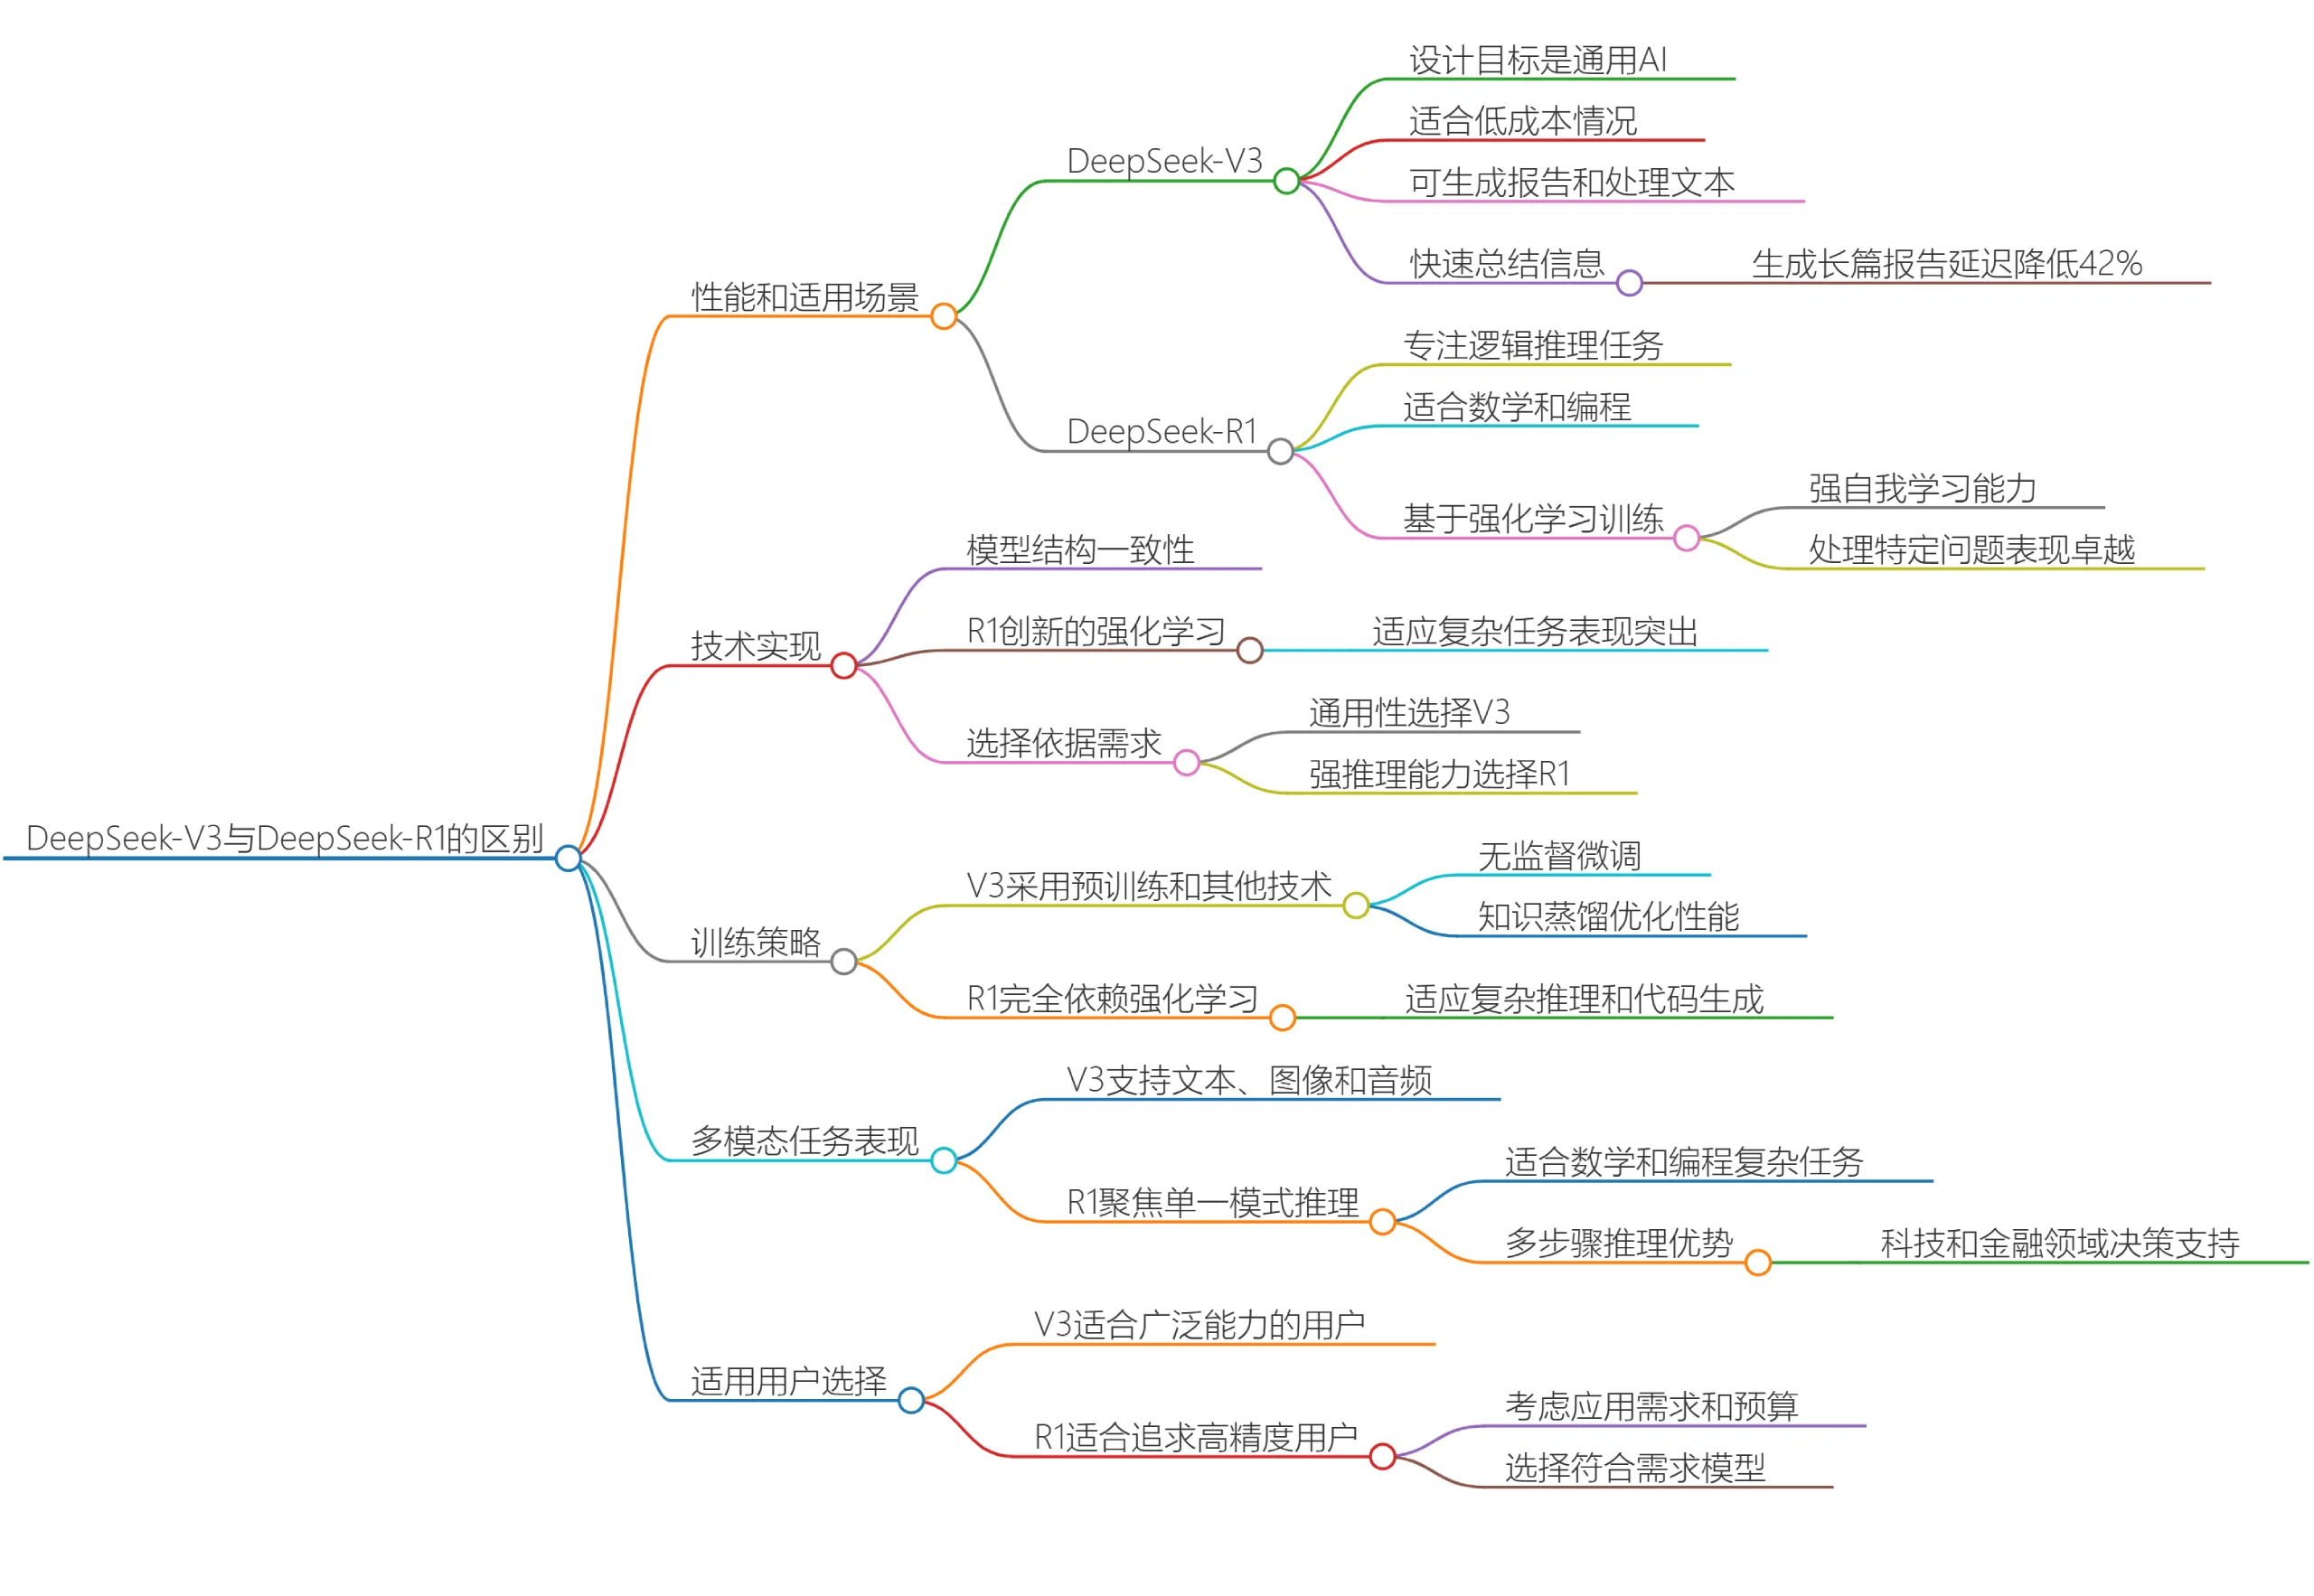
DeepSeek V3は汎用型モデルで、低コストかつ高い汎用能力が求められるシーンに適しています。例えば、長いレポートから重要なポイントを素早く要約することができます。一方、DeepSeek R1は複雑な論理的推論、数学的計算、コーディングなどのタスクにおいて非常に優れたパフォーマンスを発揮します。これを実現しているのは強化学習によるトレーニング手法です。この2つのモデルは構造とパラメータの面ではやや似ていますが、異なるトレーニング技術によって、それぞれの最適化目標を達成しています。
モデルの位置づけとコア能力
DeepSeek V3は汎用型の大規模言語モデルであり、自然言語処理、知識に関する質問応答、コンテンツ作成などを主な対象としています。高性能と低コストのバランスを追求しており、智能客服(AIカスタマーサポート)、個別化されたレコメンド、文案作成、知識Q&Aなどの用途に向いています。V3はさらにアルゴリズム最適化やマルチトークン予測技術によって、大規模なコンテキスト処理に対応しており、コストパフォーマンスに優れたソリューションを提供することを目指しています。
DeepSeek R1は複雑な推論タスク専用に設計されており、数学的計算、コード生成、論理分析などを得意としています。強化学習、特に数学やプログラミングの分野でその性能を発揮し、研究、エンジニアリング開発、高度な専門分野での応用に向いています。
トレーニング手法と技術的イノベーション
DeepSeek V3は事前学習+教師あり微調整という従来型の方法に、混合エキスパート(MoE)アーキテクチャを組み合わせており、これによりトレーニングコストを削減しています。さらに知識蒸留によってR1から推論能力を抽出し、出力のスタイルや長さの最適化を図っています。
DeepSeek R1は教師あり微調整を使わず、完全に強化学習、特にGRPOアルゴリズムに依存しています。コールドスタートデータと多段階の強化学習トレーニングを通じて、推論プロセスの完全性と正確性を重視しており、ラベル付きデータが少なくとも推論能力を高めることが可能です。
パフォーマンス
数学やコード関連のタスクでは、R1は非常に優れた結果を出しており、AIME 2024やMATH500のテストでV3を上回る成績を収め、Codeforcesでの評価もより高いことから、論理的・数学的推論における優位性がうかがえます。
逆に、MMLUやGPQAなどの知識系のベンチマークでは、V3はR1にやや劣るものの、長文生成やコンテンツ作成の面ではV3の方が優れています。
応用シーン
専門分野での応用
-
DeepSeek V3はその汎用性能により、AIカスタマーサポート、個別レコメンド、長文理解・生成の理想的な選択肢となっています。例えば、ECプラットフォームで顧客からの問い合わせに自動で回答するケースなどが挙げられます。
-
Deepseek-R1は卓越した推論能力により、複雑な数学的計算、コード生成、意思決定支援などのシーンで広く活用されています。例えば、金融やエンジニアリングなどの専門分野でR1が高く評価されています。
日常的なインタラクションのシーン
-
日常的なチャットやQ&Aなどのシーンでは、DeepSeek-V3がより自然で的確な応答を提供でき、さまざまなユーザーの表現習慣やニーズに対応できます。
-
DeepSeek R1も日常的なインタラクションは可能ですが、応答の柔軟性や正確性ではDeepSeek V3にやや劣る場合があります。
デプロイと最適化
Rise CAMPはこの両モデルに対して最適化サポートを提供しており、ワンクリックデプロイや各種GPU/NPUとの互換性を実現します。V3には混合エキスパートのスケジューリング、R1には高性能推論の高速化が用意されており、いずれも効率的な動作を保証します。
DeepSeek V3とDeepSeek R1の違い一覧表
| 比較項目 | DeepSeek-R1 | DeepSeek-V3 |
|---|---|---|
| アーキテクチャ |
|
|
| トレーニングアルゴリズム |
|
|
| トレーニングデータ |
|
|
| 機能の重点 |
|
|
どちらがあなたに適しているか?
DeepSeek V3とDeepSeek R1はそれぞれ異なる利用ニーズに合わせて最適化されており、多機能なa>来处理日常任务,如内容创作或客户服务,DeepSeek V3是理想选择。而面对数学难题、代码编写或深度逻辑分析时,DeepSeek R1则是更专业的ツール,至于哪个更适合你,你根据具体的应用场景选最适合的就行啦。









