
 脚本プランナー▸
 AIアプリ
 AIニュース
VideoWorld:言語モデル非依存、視覚のみで複雑なタスクを実現
小编 ·

VideoWorld:言語モデル非依存、視覚のみで複雑なタスクを実現
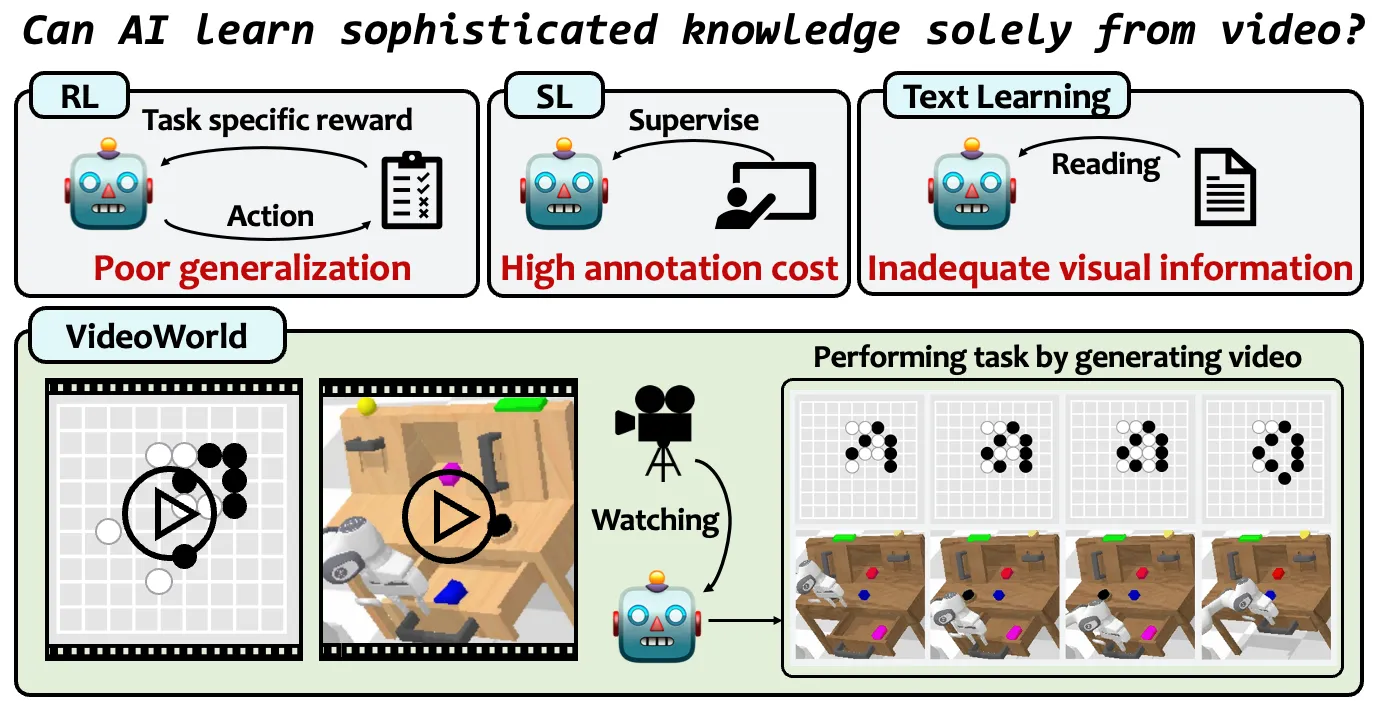
2025年2月10日、動画生成モデル「VideoWorld」が、Doubao大規模モデルチームと北京交通大学、中国科学技術大学によって共同開発され、正式にオープンソース化されました。VideoWorldモデルの核心的な革新は、言語モデルに完全に依存せず、視覚情報のみを通じて複雑なタスクの学習と生成を実現できる点にあります。
一、核心的な機能特徴
1. 純粋な視覚知識学習
ラベルのない動画データを通じて、複雑なルールや戦略(囲碁の着手ロジック、ロボット操作のタイミングなど)を自律的に習得し、言語指示や強化学習の報酬メカニズムを必要としません。
複数ステップの推論と長期的な計画能力を備えており、例えば囲碁の対局において相手の今後5〜9手先までの行動を予測することができます。
2. 高効率な視覚表現の圧縮
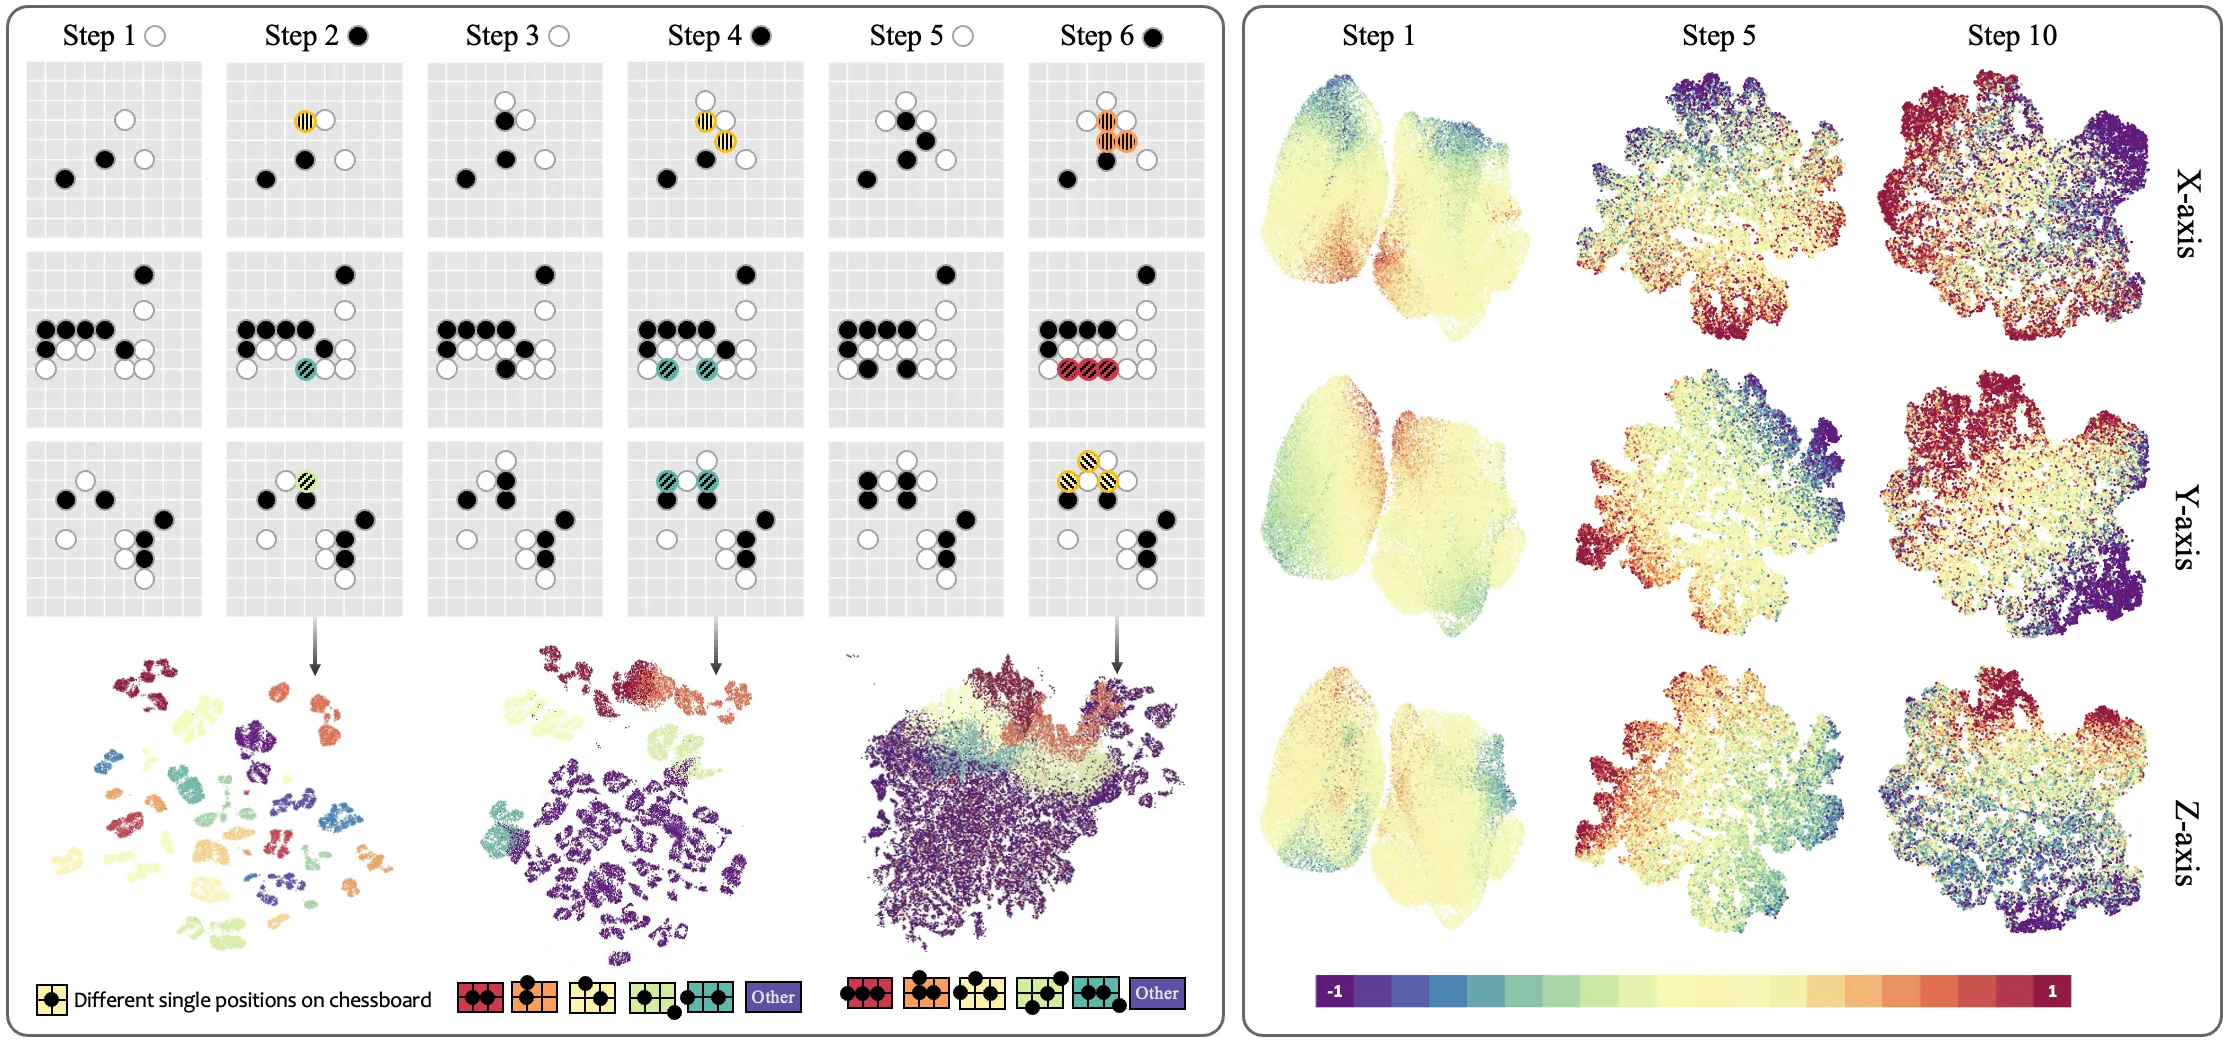
潜在動的モデル(LDM)を導入し、動画フレーム間の変化をコンパクトな潜在シーケンスにエンコードすることで、冗長な情報の干渉を低減します。
長期的および短期的な動的依存関係の joint modeling を実現し、短期的には精密な変位(ロボットアームの微調整など)に、長期的にはタスクレベルのパターン(囲碁の戦術の組み合わせなど)に対応します。
3. シナリオを横断する汎化能力
CALVINとRLBenchのロボットテストセットにおいてOracleモデルに近い性能を発揮し、異なる環境パラメータ(光照、物体の位置など)に適応できます。
囲碁の対局ではプロ五段のレベル(Video-GoBenchベンチマーク)に達し、従来の強化学習エージェントを上回ります。
二、VideoWorldの技術アーキテクチャ:
基本アーキテクチャ
VQ-VAEに基づき動画フレームをトークンシーケンスに離散化し、自己回帰Transformerを用いてフレームレベルの予測を実現します。
訓練データにはタスク実行過程の動画のみが含まれます(囲碁の対局の進行やロボットアームの操作記録など)。
潜在動的モデル(LDM)
符号化メカニズム:将来のHフレーム分の視覚変化を連続的な潜在コードに圧縮し、量子化した上で予測目標とします。
デュアルストリーム予測:動画フレームの生成と潜在コードの予測を共同で最適化し、重要な意思決定ノードのモデリングを強化します。
解釈可能な分析:UMAPによる可視化により、潜在空間のクラスタリングがタスクの動態と強く関連していることを示します。
効率最適化設計
モデルパラメータ数は3億程度に抑えられ、従来の動画モデルと比較して計算コストを80%削減しています。
訓練データの規模:Video-GoBenchには十万レベルの囲碁対局動画フレームが含まれています。
三、VideoWorldの応用シナリオ
コンテンツ制作:ショート動画制作、映画のシーン构思、ゲーム内の視覚コンテンツ生成などに対し強力なサポートを提供します。
教育:動的な動画を生成することで、学生が複雑な知識をより生动的に理解できるよう支援します。
広告:ユーザーの好みに応じて、パーソナライズされた広告動画を生成し、マーケティング効果を向上させます。
四、VideoWorldのダウンロードとインストール:
1. リポジトリのクローン:
git clone https://github.com/bytedance/VideoWorld.git
cd VideoWorld
2. 依存関係のインストール:
pip install -r requirements.txt
3. サンプルの実行:サンプルコードは通常 examples または scripts ディレクトリにあります。必要に応じて設定ファイルを調整し、対応するスクリプトを実行してください。
五、VideoWorldのプロジェクトページ:
プロジェクトホームページ:https://maverickren.github.io/VideoWorld.github.io
GitHubアドレス:https://github.com/bytedance/VideoWorld
論文リンク:https://arxiv.org/abs/2501.09781









