
 脚本プランナー▸
 AIアプリ
 AIニュース
MILS:Metaが発表した、訓練なしでLLMにマルチモーダル能力を獲得させる手法
小编 ·

MILS:Metaが発表した、訓練なしでLLMにマルチモーダル能力を獲得させる手法
MILS(Meta Interpretive Learning System)は、Metaが発表した、追加学習なしでLLMにマルチモーダル能力を獲得させるオープンソースのaiモデルです。従来の学習方法とは異なり、MILSは特定のタスク向けの追加学習を必要とせずに、大規模言語モデル(LLMs)に視覚や聴覚タスクを処理する能力を付与することを目的としており、動画や画像を認識したり、音を聞いたりすることができ、ゼロショット学習が可能です。
MILSはディープラーニングと解釈学習の利点を組み合わせており、特に理解や推論が必要な複雑なシナリオを含む、多くのタスクで優れたパフォーマンスを発揮します。
MILSは主に2つのモジュールで構成されています。一つは候補ソリューションを生成するジェネレーター、もう一つはジェネレーターが生成した候補ソリューションの品質を評価するスコアラーで、反復プロセスにより追加学習なしでマルチモーダルタスクの解決を実現します。
MILSの特徴は、複数の言語とマルチモーダル入力をサポートし、テキスト、画像、音声データを処理できることであり、画像/動画/音声キャプション、画像生成強化、スタイル転送など、さまざまなマルチモーダルタスクに使用できます。
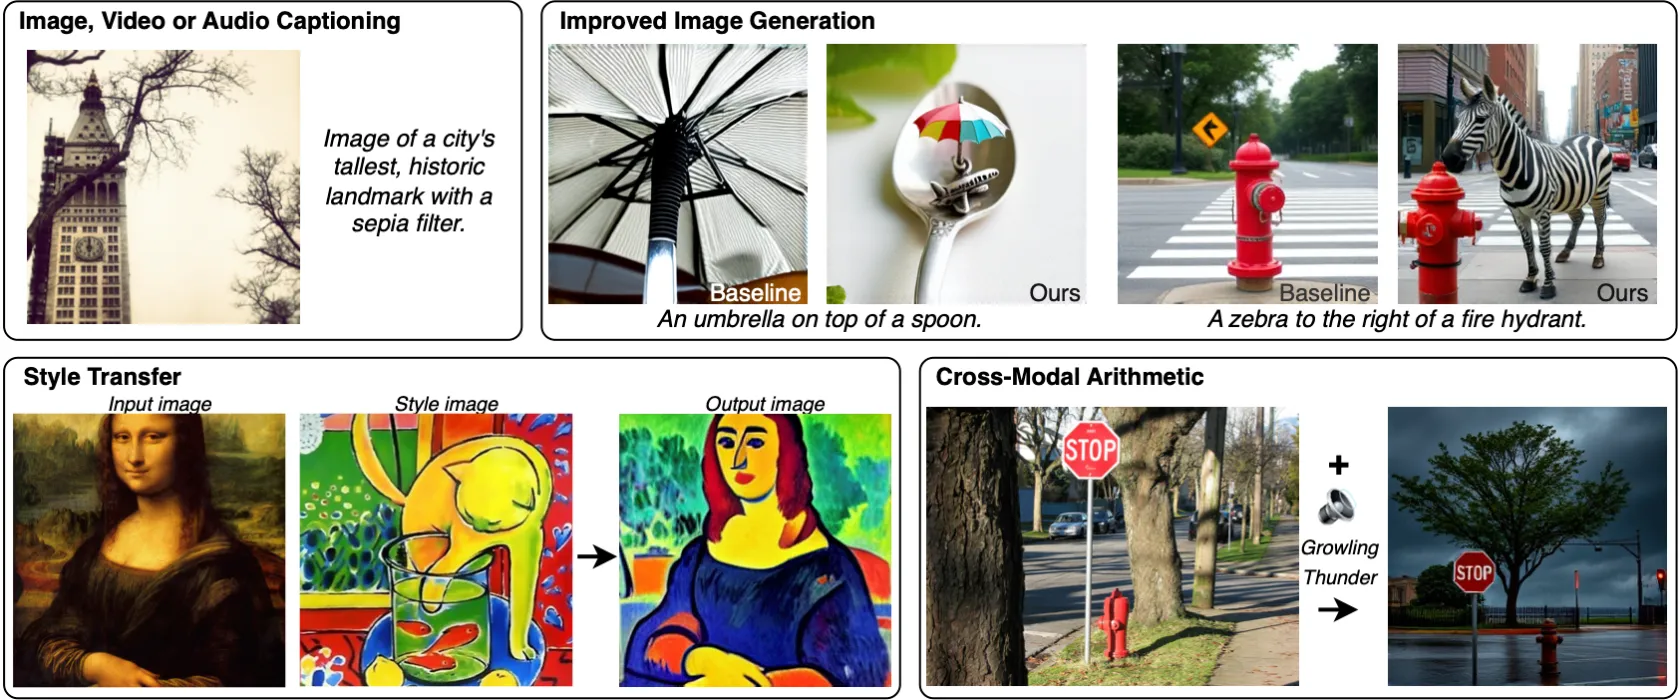
MILSの主な特徴と動作原理
ゼロショット生成:MILSの中核はゼロショット学習能力にあり、特定のモダリティタスク向けに直接学習を行わなくても、マルチモーダル問題を解決できることを意味します。反復的なフィードバックメカニズムを通じて生成された出力を段階的に改善し、高品質なマルチモーダルな説明や生成を実現します。
反復フィードバックループ:生成プロセスにおいて、MILSはまず言語モデルにテキストプロンプトに基づいて初期のマルチモーダル出力(画像キャプションなど)を生成させます。次に、この出力が入力として使用され、モデルが再び生成や最適化を試みます。継続的な自己フィードバックと修正を通じて、最終的に満足のいくソリューションに到達します。
事前学習済みモデルの活用:MILSは大規模言語モデルの事前学習済み知識に依存しており、これらのモデルは大規模なテキストデータを学習しているため、複雑なセマンティクスやコンテキストを理解することができます。このようにして、MILSはこれらのモデルの本質的な能力を活用して、テキスト以外のデータ(画像や音など)の理解や生成にまたがることができます。
論文:https://arxiv.org/pdf/2501.18096
Github:https://github.com/facebookresearch/MILS









