
 脚本プランナー▸
 AIアプリ
 AIニュース
Open R1:DeepSeek-R1の完全オープンソース再現プロジェクト
小编 ·

Open R1:DeepSeek-R1の完全オープンソース再現プロジェクト
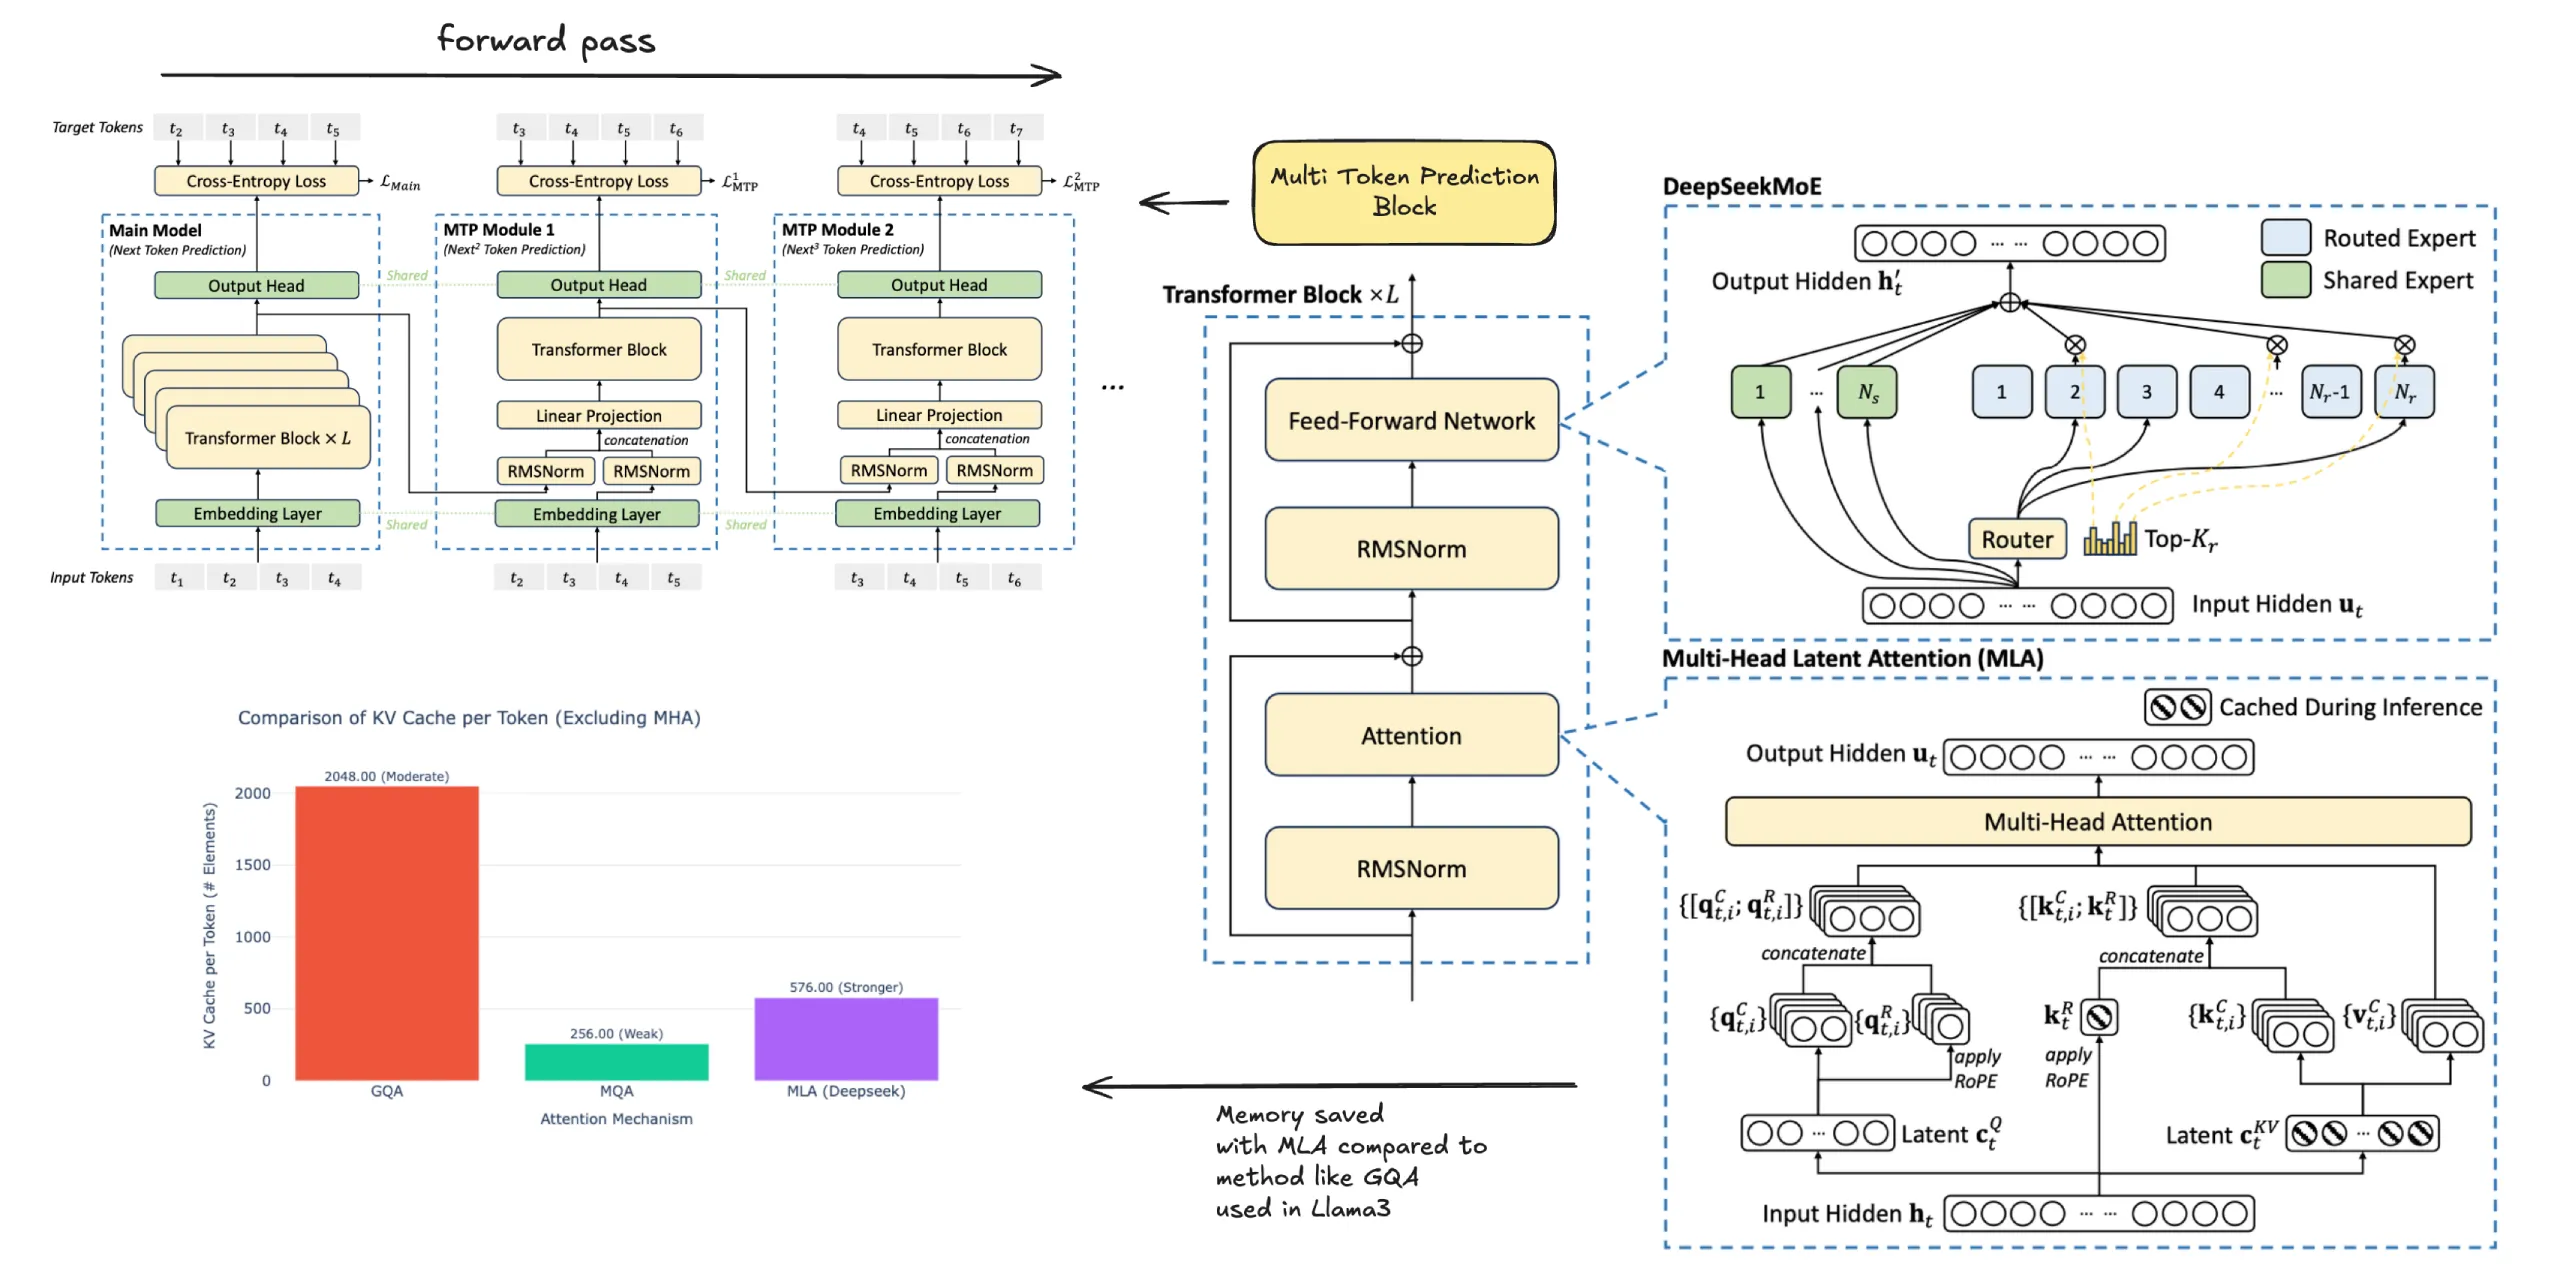
Open R1 は、Hugging Face が立ち上げた DeepSeek-R1 の完全オープンソース再現プロジェクトであり、 DeepSeek R1 モデルの訓練プロセスを完全に再現することを目的としています。本プロジェクトの目標は、DeepSeek-R1 パイプラインで不足している部分を構築し、研究および産業界に完全な推論最適化訓練パイプラインを提供することです。
プロジェクトの目的
DeepSeek-R1 の訓練プロセスの再現:オープンソースの方法で、知識蒸留から強化学習、多段階訓練に至るまで、DeepSeek-R1 の訓練プロセスを段階的に詳細に再現する方法を紹介します。
完全な実装の提供:プロジェクトには完全な推論最適化訓練パイプラインが含まれており、ユーザーがモデルを簡単に利用および変更できるようにします。
プロジェクトの構成
訓練データとスクリプト:実験と検証を行うためのオープンソースのデータセットと訓練スクリプトを提供します。
ドキュメントとサンプル:詳細なドキュメントとサンプルコードを提供し、ユーザーがモデルの利用を迅速に開始し、理解できるように支援します。
Open R1 プロジェクトは、特に以下の側面に注目しています:
データ収集と訓練コード:DeepSeek-R1 のモデルウェイトは公開されていますが、訓練に使用されたデータセットとコードは公開されていません。Open R1 は、DeepSeek-R1 のデータと訓練パイプラインを体系的に再構築し、その主張する効果を検証し、オープンな推論モデルの限界を押し広げることを計画しています。
多段階訓練:プロジェクトの計画には、ベースモデルから教師あり微調整(SFT)、さらに強化学習(RL)までの多段階訓練プロセスが含まれており、合成データセットを通じて既存または新規モデルを推論モデルに変換する方法を提示することを目的としています。
クロスドメイン応用:数学データセット以外にも、Open R1 はコードや医療などの科学分野など、他の分野の可能性を探求したいと考えており、これらの分野では推論モデルが大きな影響を与える可能性があります。
Open R1 プロジェクトの操作方法は?
ステップ1:DeepSeek-R1 を使用して高品質なコーパスを蒸留し、R1-Distill モデルを複製して、効果が DeepSeek の主張通りであるかどうかを確認します。
ステップ2:DeepSeek が R1-Zero の構築に使用した純粋な強化学習(RL)パイプラインを複製します。
ステップ3:多段階訓練を通じて、ベースモデルから RL バージョンへと移行します。
Open R1 プロジェクト:https://huggingface.co/blog/open-r1
Open R1 コード:https://github.com/huggingface/open-r1









