
 脚本プランナー▸
 AIアプリ
 AIニュース
Mistral AI、Mistral Small 3を発表——わずか24Bパラメータで70Bクラスの性能を実現
小编 ·

Mistral AI、Mistral Small 3を発表——わずか24Bパラメータで70Bクラスの性能を実現
Mistral aiは2025年1月30日にMistral Small 3を発表しました。これはレイテンシを最適化した24Bパラメータモデルで、効率的なパフォーマンスを提供することを目的としています。このモデルはApache 2.0ライセンスの下で公開されており、ユーザーは自由に使用・改変することができます。
Mistral Small 3の主な特徴:
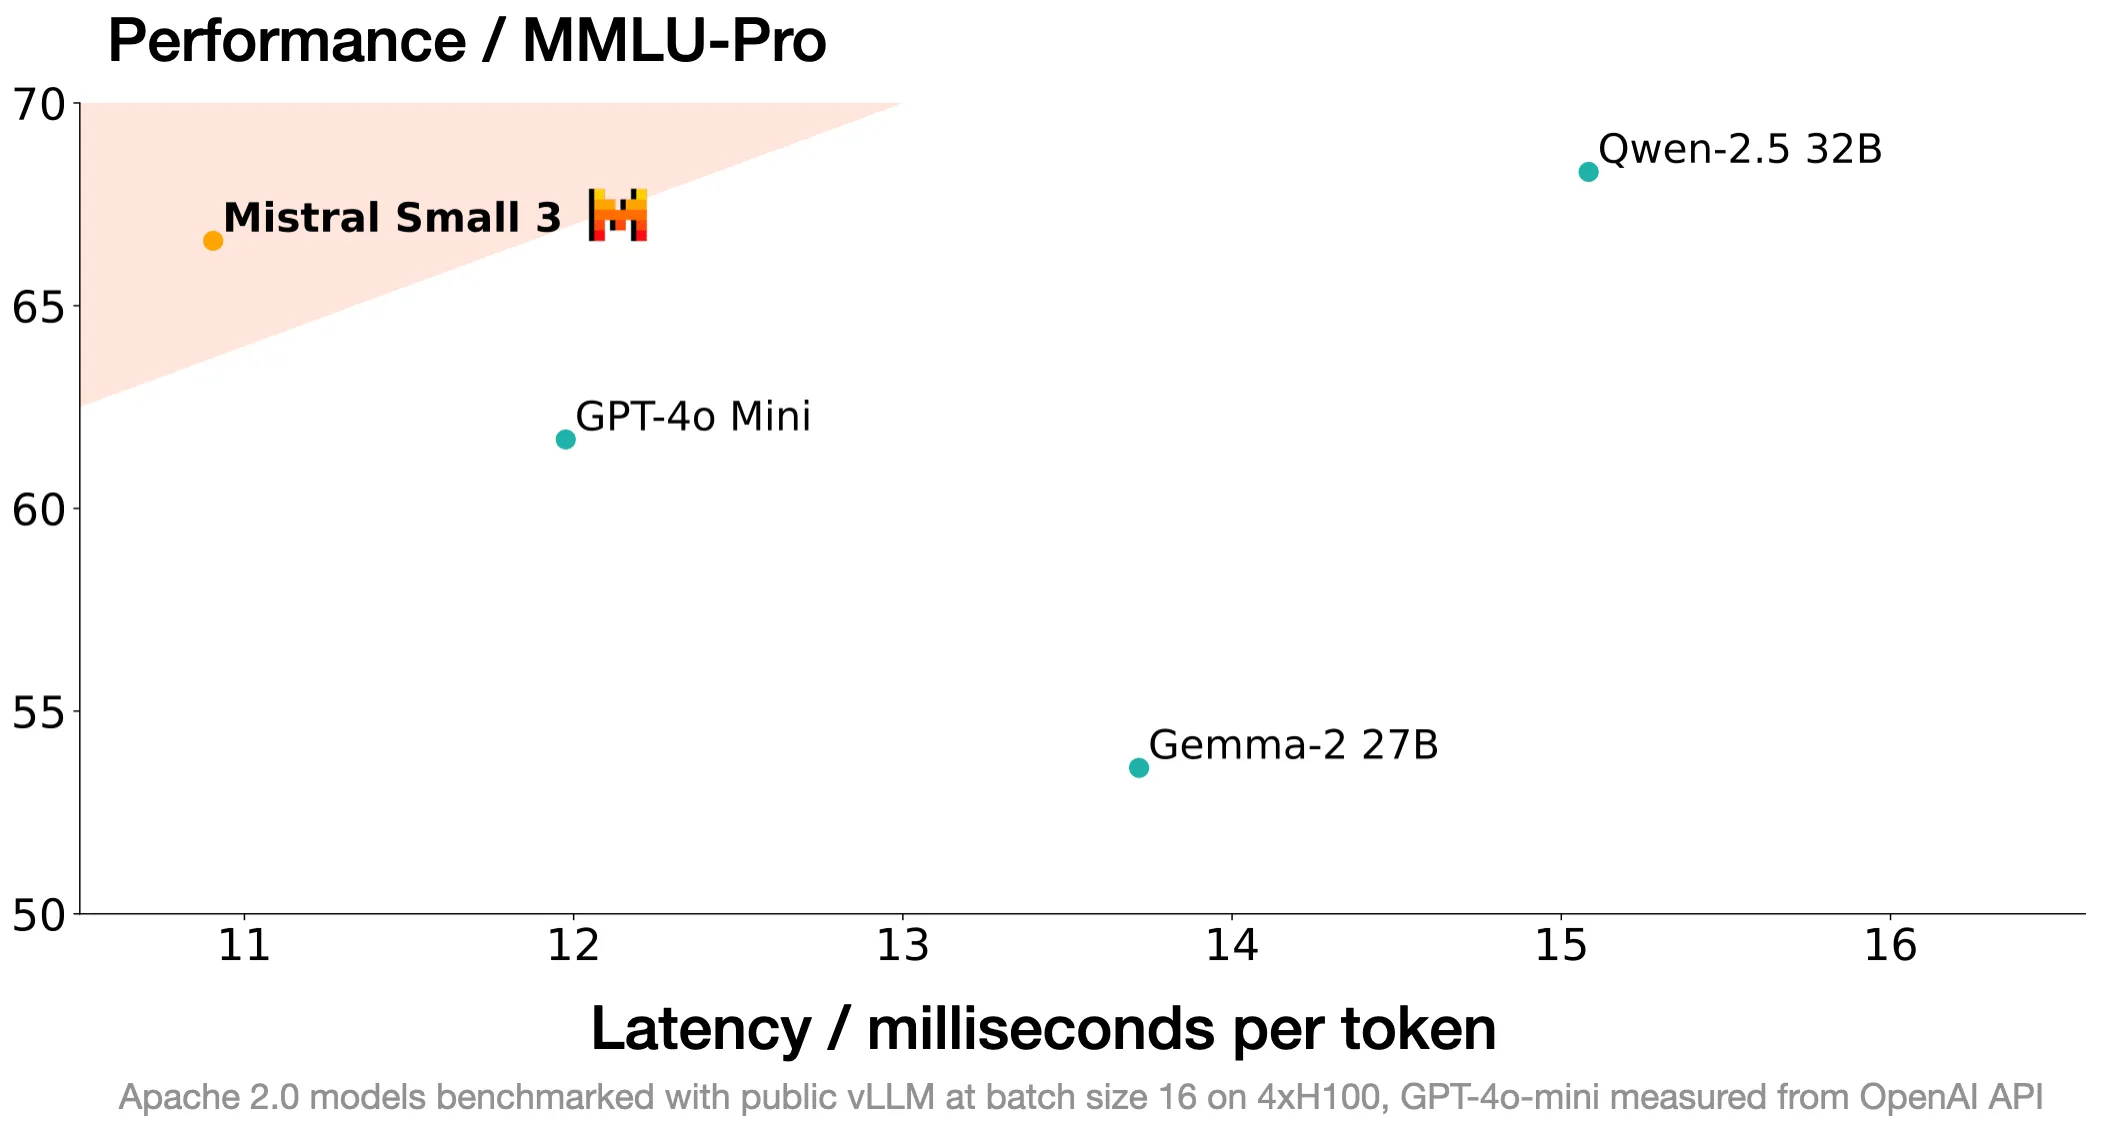
高い性能とスケール:24Bパラメータのみであるにもかかわらず、Mistral Small 3の性能は、より大規模なモデル(Llama 3.3の70Bパラメータモデルなど)に匹敵します。これにより、同じハードウェア上でより高速な推論を実現できます。
レイテンシ最適化:Mistral Small 3は低レイテンシのワークロードに最適化されており、高速な応答が必要なアプリケーションシナリオに非常に適しています。
ドメインエキスパート微調整:法律、医療、技術サポートなど、特定の分野向けのタスクトレーニングに適しており、専門知識の正確性を向上させます。
ローカル推論:RTX 4090や32GB RAM搭載のMacBookでのローカル実行をサポートしており、機密データや proprietary なデータを扱う個人や企業に適しています。
Mistral Small 3の設計は、特にほとんどの生成AIタスクのニーズを満たすことに重点を置いており、強力な言語能力と指示追従性能が必要なタスクに特化しています。このモデルはMMLUベンチマークテストで81%以上の精度を達成しており、同じハードウェア上で毎秒150トークンの速度で動作し、効率面での優位性を示しています。
さらに、Mistral Small 3は機密情報や proprietary な情報を扱うシナリオでのローカルデプロイメントにも適しています。ユーザーは単一のRTX 4090または32GB RAM搭載のMacbook上でこのモデルを実行でき、その可用性と柔軟性がさらに向上しています。
Mistral Small 3はHugging Face、Ollama、Kaggleなど複数のプラットフォームとも連携しており、開発者がこのモデルにより簡単にアクセスして利用できるようになっています。
Mistral Small 3のアプリケーション
Mistral Small 3は、自然言語処理、対話システム、その他の効率的な推論を必要とするタスクなど、さまざまなアプリケーションに適しています。その設計目標は、現代のAIアプリケーションのニーズを満たす柔軟で強力なツールを開発者に提供することです。
対話アシスタント:高速かつ正確な応答が必要なバーチャルアシスタントに適しています。
関数呼び出し:自動化やエージェントワークフロー内の関数を迅速に実行できます。
ドメインエキスパート:特定の分野で高精度な expert モデルを作成するために微調整可能です。
ローカル推論:機密情報や proprietary な情報を扱うローカル推論に適しています。
金融サービス:不正検出に使用されます。
医療業界:患者のトリアージやカスタマーサポートに使用されます。
ロボット/自動車/製造業:デバイス上でコマンド制御を実行します。
公式紹介:https://mistral.ai/news/mistral-small-3/









