
 脚本プランナー▸
 AIアプリ
 AIニュース
大規模モデルの蒸留(ディスティレーション)とは何か?DeepSeekが直面する「モデル蒸留」疑惑の真相は?
小编 ·

大規模モデルの蒸留(ディスティレーション)とは何か?DeepSeekが直面する「モデル蒸留」疑惑の真相は?
DeepSeekは新興の人工知能企業であり、最近Openaiの技術を用いてモデル蒸留を行ったとして非難されたことで大きな注目を集めています。OpenAIは、DeepSeekが蒸留技術を通じて自社のモデルの知識を抽出し、競合製品を開発した可能性があると主張しています。
大規模モデルの蒸留(Distillation)とは何か?
大規模モデルの蒸留とは、大規模で複雑なモデル(教師モデルと呼ばれます)の知識を、より小型で効率的なモデル(生徒モデルと呼ばれます)に移転することを目的としたモデル圧縮技術です。このプロセスでは、生徒モデルを訓練して教師モデルの出力を模倣できるようにし、性能を維持しつつ計算資源の消費を削減します。
この概念はHintonらによって2015年に提案され、モデルの圧縮、推論の高速化、デプロイコストの削減に利用されると同時に、元のモデルの性能を可能な限り維持します。蒸留技術は深層学習で広く利用されており、特に自然言語処理やコンピュータビジョンなどの分野で活用されています。
以下では、YouTubeの「Jeff科技視点」Jeff Liのマインドマップで理解を深めてみましょう。Jeff Li先生は《第379回:大規模モデルの蒸留(Distillation)およびDeepSeekが受けた非難》の動画で非常に詳細に解説しています。
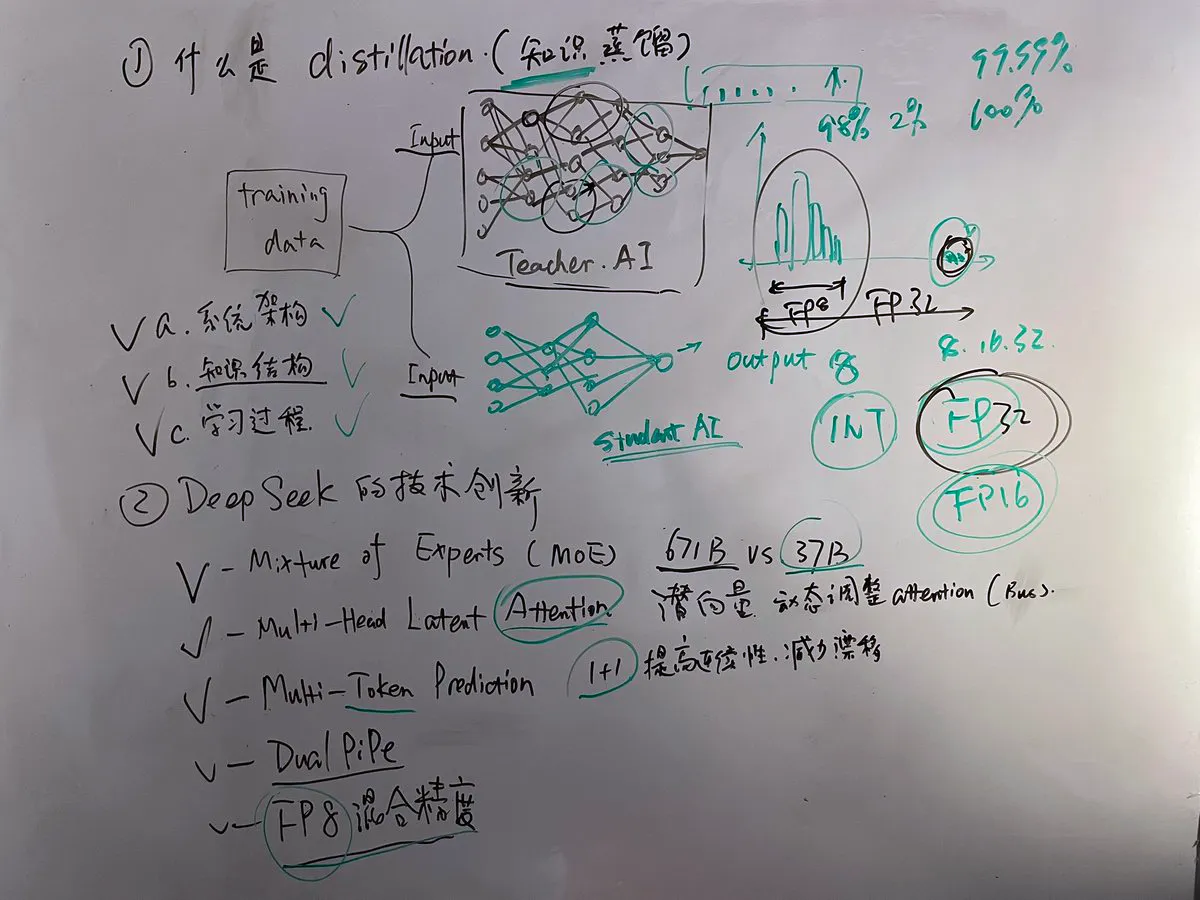
大規模モデルの蒸留の実施方法:
ソフトラベル(Soft Labels):教師モデルが生成した確率分布を使用して、ハードラベルの代わりに訓練を行います。
隠れ活性化(Hidden Activations):教師モデルの中間層の一部を補助信号として生徒モデルに提供します。
Attention重み(Attention Weights):シーケンスモデルが関わる場合、注意機構に関する情報も移行できます。
DeepSeekが受けた「モデル蒸留」非難
背景:
DeepSeekは新興企業であり、自社で大規模言語モデル製品を提供しています。
DeepSeekの低コストなモデル開発、オープンソース、無料戦略は、OpenAIやAnthropicなどの企業の市場における地位を脅かす可能性があり、競合他社はDeepSeekが自社の技術とデータを不正に使用していると批判しています。
重要なポイント:
OpenAIの立場
DeepSeekが無許可のデータを取得して自社のモデルの訓練に使用したと非難しています。
OpenAI自身の問題:OpenAI自体も、インターネット上から違法にデータを収集してモデルを訓練していたと指摘されており、特に著作権で保護された文章作品がその対象となっています。さらに、OpenAIは同様の行為によって《ニューヨーク・タイムズ》などの出版者から法的訴訟を起こされたことがあります。
Anthropicの見解
深刻さの反論:Anthropicは、DeepSeekは自社製品に対する真の脅威となるレベルには達していないと考えており、その技術水準は数か月前のバージョンに相当すると述べています。
マイクロソフトの姿勢
マイクロソフトはAzure AIおよびGitHubプラットフォーム上でDeepSeekモデルを提供しており、何らかの形での支持姿勢を示しており、これが利益相反に関する議論を引き起こしています。
モデル蒸留に関する具体的な論争
合法性および規範性:モデル蒸留は一般的な技術実践ですが、実際の運用には厳格な規則による制約があります。特に商業目的や技術共有規約に関する規制について、各企業は異なる解釈と執行力度を持っています。
「無許可の方法」でのデータ取得をどのように定義するか?
特定のAPIが出力したデータを、新たな競合モデルの訓練に使用することは許可されるのか?
証拠および裏付け資料:現時点では、双方がそれぞれの主張を裏付ける詳細な証拠を完全に公開していないため、事件の複雑さと不確実性が増しています。
業界の反応と世論
コミュニティ内外でこの問題に対する見解は分かれており、市場競争の一側面であると考える人もいれば、その背後にある倫理や法規制が十分に尊重されているかどうかに注目する声も多くあります。
DeepSeekが受けた「モデル蒸留」非難は、現在のAI業界に存在する激しい競争态势、およびデータ利用権や技術革新の境界線を取り巻く法的なグレーゾーンによってもたらされる課題を反映しています。









