
 脚本プランナー▸
 AIアプリ
 AIニュース
DeepSeek Janus Proをローカル環境にデプロイする方法
小编 ·

DeepSeek Janus Proをローカル環境にデプロイする方法
DeepSeekが発表したJanus-Pro-7Bはオープンソースのマルチモーダル大規模モデルであり、画像認識と生成をサポートし、性能はOpenaiのDALL·E 3を超えています。以下は、DeepSeek Janus Pro-7Bをローカル環境にデプロイする方法の詳細な手順、コツ、注意点です:
一、環境準備
ハードウェア要件
GPU:ビデオメモリ ≥24GB(NVIDIA RTX A6000以上の高性能グラフィックスカードを推奨)。ビデオメモリが不足する場合は、低精度モード(model.half())や生成パラメータの削減をお試しください。
ストレージ:≥30GB の空き容量(モデルファイルは約20GB以上)。
オペレーティングシステム:Ubuntu 20.04+ または Windows(CUDA対応が必要)を推奨。
Python:3.8以上。Condaで仮想環境を管理することを推奨。
ソフトウェア依存関係
CUDA:11.7+(PyTorchのバージョンと一致させる必要あり)。
PyTorch:指定バージョン torch==2.0.1+cu117(公式インデックスからインストールする必要あり)。
その他のツール:Git、HuggingFace Hub ダウンロードツール(huggingface-cli)。
二、デプロイ手順
1. リポジトリのクローン
git clone https://github.com/deepseek-ai/Janus.git
cd Janus
2. 仮想環境の作成
conda create -n janus python=3.8 -y
conda activate janus
3. 依存関係のインストール
pip install torch==2.0.1+cu117 --index-url https://download.pytorch.org/whl/cu117
pip install -r requirements.txt
pip install -e .[gradio]  # Gradio拡張をインストール
4. モデルのダウンロード
方法一:huggingface-cli を使用して完全モデルをダウンロード(中国国内のユーザーはミラーで高速化を推奨):
HF_ENDPOINT=https://hf-mirror.com huggingface-cli download deepseek-ai/Janus-Pro-7B \
  --local-dir ./models/Janus-Pro-7B \
  --resume-download --cache-dir ./cache
方法二:HuggingFace リポジトリ からモデルファイルを手動でダウンロードし、./models/Janus-Pro-7B に解凍します。
5. アプリの起動
テキストインターフェース:
python demo/app_text.py --model-path ./models/Janus-Pro-7B
マルチモーダルインターフェース(画像生成と質疑応答をサポート):
python demo/app_multimodal.py --model-path ./models/Janus-Pro-7B --port 7860
http://localhost:7860 または http://127.0.0.1:7860 にアクセスしてインターフェースを使用します。
三、機能の使用例
テキストから画像生成(Text-to-Image)
from janus.utils import generate_image
generate_image(
    model_path="./models/Janus-Pro-7B",
    prompt="夕阳下的雪山,山脚下有蓝色的湖泊",
    output_dir="./outputs",
    num_images=4  # 4枚の画像を生成)
マルチモーダル質疑応答(Visual QA)
from janus.models import MultiModalityCausalLM, VLChatProcessor
processor = VLChatProcessor.from_pretrained("./models/Janus-Pro-7B")
model = MultiModalityCausalLM.from_pretrained("./models/Janus-Pro-7B").to("cuda")
# 対話と画像パスを入力
conversation = [
    {"role": "", "content": "描述这张图片的内容", "images": ["sample.jpg"]},
    {"role": "", "content": ""}
]
inputs = processor(conversations=conversation)
outputs = model.generate(**inputs)
print(processor.decode(outputs[0]))
四、よくある問題と最適化
ビデオメモリ不足
生成パラメータを削減する:max_new_tokens=256。
低精度モードを有効にする:model = model.half()。
ダウンロード速度が遅い
国内ミラーを使用する:HF_ENDPOINT=https://hf-mirror.com。
マルチスレッドダウンロードを有効にする:--workers 8。
依存関係の競合
指定バージョンを厳密にインストールする:
pip install transformers==4.33.2
画像生成品質の最適化
CFG 重みを調整する(5〜7の範囲)。
並列サンプリング数を増やす:parallel_size=16。
ここで、X(旧Twitter)で私がフォローしている技術者のローカルデプロイ方法も共有します:
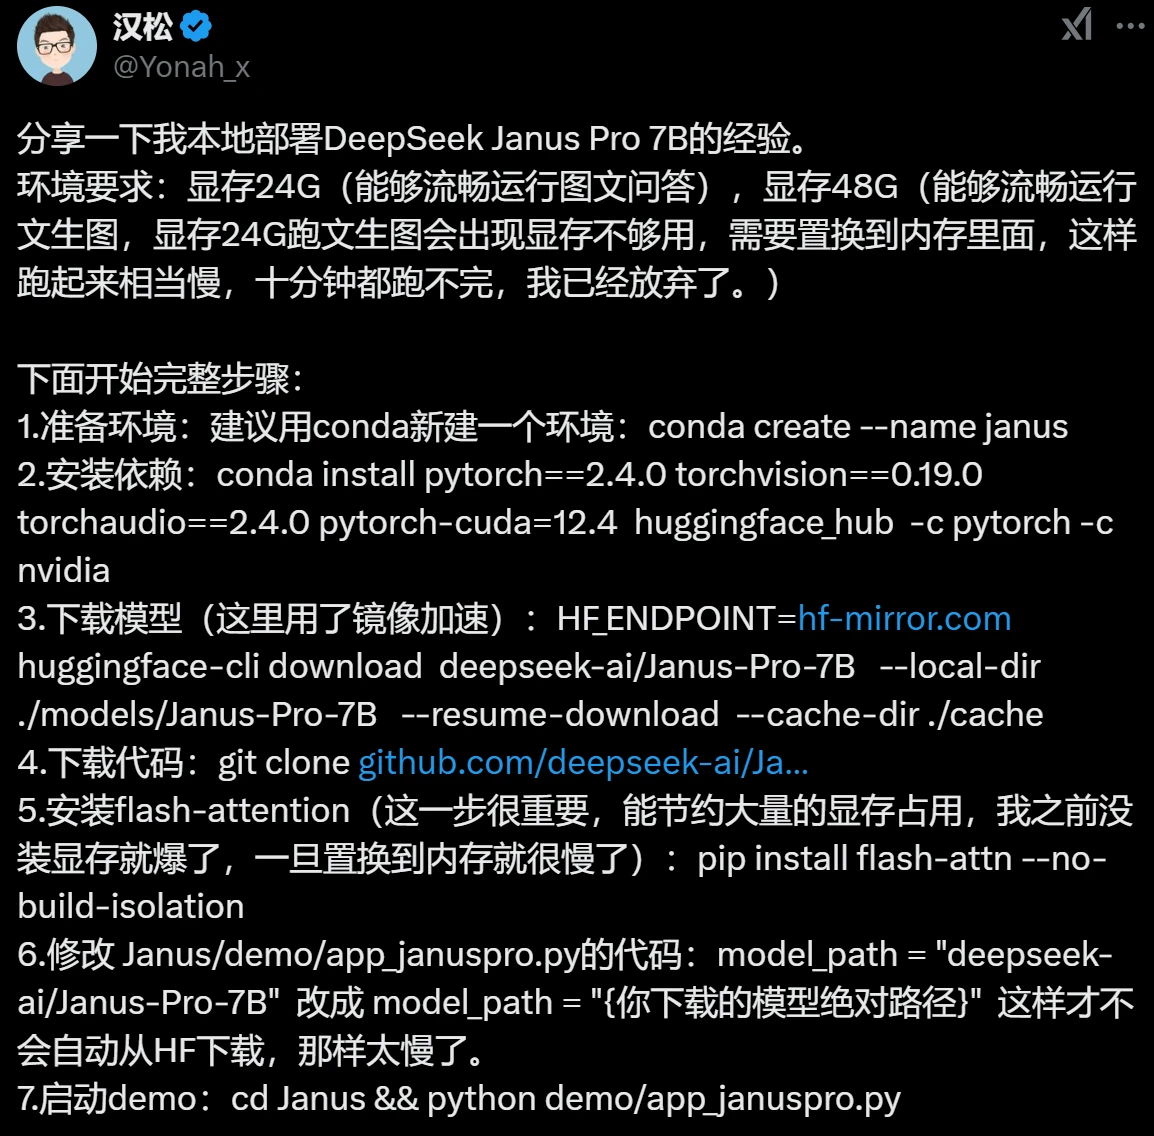
コツ:
コツ1:以前にcondaのpytorch環境をインストールしたことがある場合は、conda create --name myenv --clone base で直接クローンできます。毎回pytorchを再ダウンロードすると遅く、時間の無駄になります。
コツ2:flash-attentionは必ずインストールしてください。インストールしなくても動作しますが、ビデオメモリが足りなくなります。A100をお持ちの方は無視して構いません。
上記の手順により、ローカル環境でJanus-Pro-7Bのマルチモーダル機能を迅速にデプロイし体験できます。さらに最適化したい場合やモデルの詳細を知りたい場合は、GitHubリポジトリおよび技術ドキュメントを参照してください。









