
 脚本プランナー▸
 AIアプリ
 AIニュース
FunAudioLLM:Alibabaの音声AIブレイクスルー
小编 ·

FunAudioLLM:Alibabaの音声AIブレイクスルー
FunAudioLLMはAlibabaが開発した音声処理モデル群であり、人間と大規模言語モデルの間の音声インタラクションを向上させることを目的としています。主にSenseVoiceとCosyVoiceの2つのモデルで構成されています。
SenseVoice:音声認識モデルで、複数言語の音声を認識し、話者の感情を識別し、音声内の特殊イベント(音楽、笑い声など)を検出することができます。音声内容を高速かつ正確に文字起こしできます。
CosyVoice:音声生成モデルで、自然で感情豊かな音声を生成することを主な目的としています。異なる話者を模倣したり、数秒の音声サンプルから人の声をクローンすることもできます。
SenseVoiceとCosyVoiceの組み合わせにより、FunAudioLLMは包括的な音声理解および生成能力を提供し、人間と大規模言語モデルの間の音声インタラクションをより自然で豊かなものにします。
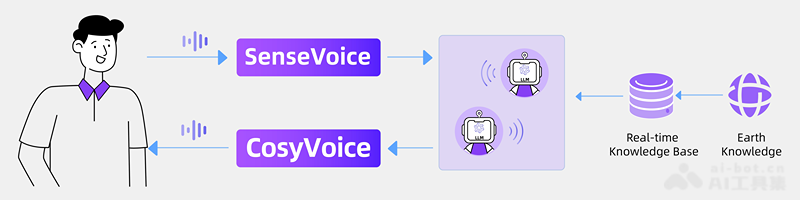
SenseVoiceとCosyVoiceの主な特徴:
SenseVoiceは多言語音声認識、感情認識、音声イベント検出に焦点を当て、高精度で低遅延の音声処理能力を提供します。CosyVoiceは自然な音声生成と制御に焦点を当て、複数言語、話者の声色、話し方の生成をサポートし、ゼロショット学習と細粒度な音声制御を実現します。両者の組み合わせにより、FunAudioLLMは多様なアプリケーションシーンで優れた音声インタラクション体験を提供することができます。
SenseVoiceの主な特徴
1. 多言語音声認識
SenseVoice-Small:中国語、英語、広東語、日本語、韓国語の5言語をサポートします。非自己回帰型のエンドツーエンドアーキテクチャを採用しており、認識遅延が極めて低いです。Whisper-smallより5倍速く、Whisper-largeより15倍速いです。
SenseVoice-Large:高精度な音声認識で、50以上の言語をサポートします。
2. 感情認識
音声の高さ、リズム、音調の変化を検出することで、喜び、悲しみ、怒りなど音声内の感情を認識します。
3. 音声イベント検出
音声内の音楽、笑い声、拍手などの特殊イベントを検出し、イベントの開始時刻と終了時刻を予測します。
SenseVoice-Smallは、BGM、拍手、笑い声、泣き声、咳、くしゃみなど、さまざまな人間とコンピュータのインタラクションイベントを検出できます。
4. 言語識別
話者が使用している言語を識別し、音声認識とコンテキスト理解の正確性を確保します。
5. 逆テキスト正規化(ITN)
句読点やフォーマットされた文字起こし結果を提供し、文字起こしテキストの可読性と正確性を向上させます。
FunAudioLLMの主な特徴:
多言語音声認識:40万時間以上のトレーニングデータで、Whisperモデルよりも優れた認識性能を持ちます。
高効率な推論:SenseVoice-Smallモデルは非自己回帰型のエンドツーエンドフレームワークを採用しており、推論遅延が極めて低いです。10秒の音声処理にはわずか70ミリ秒で済み、Whisper-Largeより15倍速いです。
感情認識:複数のテストデータセットで、現在最高の感情認識モデルの結果を達成しています。
イベント検出:複数の一般的な音声イベントの検出をサポートします。
便利なファインチューニング:便利なファインチューニングスクリプトと戦略を提供し、ユーザーはビジネスシナリオに応じてロングテールのサンプル問題に簡単に対応できます。
サービス展開:サービス展開パイプラインを提供し、複数の並行リクエストをサポートします。クライアント言語にはPython、C++、HTML、Java、C#などが含まれます。
CosyVoiceの主な特徴:
1. 音声生成
中国語、英語、広東語、日本語、韓国語を含む多言語の音声生成をサポートします。
自然で感情豊かな音声を生成でき、異なる話し方や感情表現をサポートします。
2. 多様な音声制御
声色制御:生成される音声の音色を正確に制御し、特定の話者の声と一致させることができます。
話し方制御:テキストコマンドによって、感情、話速、音調など、音声の話し方を制御します。
3. ゼロショット学習
数秒の音声サンプルだけで音声をクローンでき、追加のトレーニングデータは不要です。
クロス言語音声クローンをサポートし、ある言語の声を別の言語で使用することができます。
4. 副言語的特徴の細粒度な制御
笑い声、ため息、つなぎ語などの微妙な音声特徴を挿入することができ、生成される音声をより自然で生き生きとしたものにします。
テキストコマンド制御:テキストコマンドによって話者のアイデンティティ、感情、話し方を正確に制御できます。
5. 複数キャラクター対話
複数キャラクターの対話音声を生成することができ、インタラクティブポッドキャストや感情チャットなどのシナリオに適しています。
プロジェクトアドレス:https://github.com/FunAudioLLM









