
 脚本プランナー▸
 AIアプリ
 AIニュース
Hallo:ポートレート画像アニメーションのための階層型オーディオ駆動ビジュアル合成
小编 ·

Hallo:ポートレート画像アニメーションのための階層型オーディオ駆動ビジュアル合成
Halloは、1枚の画像と音声入力に基づいて、歌ったり話したりする動画を生成することができ、人物の表情や姿勢を制御することも可能です。EMOと比較すると、Halloは階層的なオーディオ駆動型ビジュアル合成を実現するために拡散モデルを採用しているため、音声を入力することで、対応する人物の口の動き、表情の変化、姿勢の変化を伴うアニメーションを生成できます。これにより、生成されたアニメーションと音声との間で、口、表情、姿勢の同期精度が向上しています。の同期。
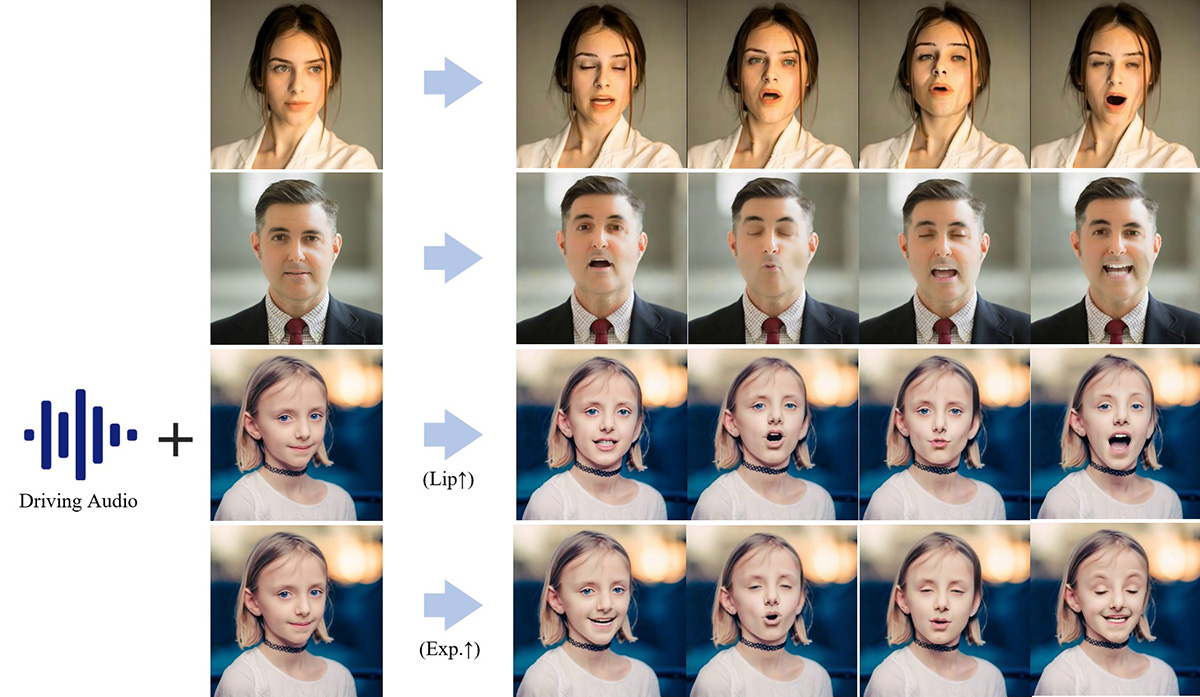
Halloの機能と特徴:
バーチャルキャラクターアニメーション生成:音声入力によってリアルでダイナミックなバーチャルキャラクターアニメーションを生成し、口の動き、表情、姿勢の精密な同期を実現します。
実在キャラクターアニメーション生成:技術を実在人物の音声駆動アニメーション生成に適用し、生成されたアニメーションが実在人物の表情や動作の変化を正確に反映します。
多様な動作制御:キャラクターの表情、姿勢、口の動きを精密に制御し、さまざまな表情や姿勢の適応制御をサポートすることで、アニメーションの多様性とリアルさを高めます。
異なるアクターへの応用:異なるアイデンティティの個別アニメーション生成をサポートし、音声入力によって異なるキャラクターアイデンティティに適応したアニメーション効果を生成します。
歌唱アニメーション生成:音声および歌の音声入力によって同期された歌唱アニメーションを生成し、歌っているときの口の動きや表情の変化を正確に反映します。
Halloのその他の特徴:
リアルタイム性:拡散モデル構造を採用することで、アニメーション生成のリアルタイム性を強化し、生成されるアニメーションがよりリアルで自然なものになります。
パーソナライズ:異なる俳優やキャラクターに応じて個別化されたアニメーション効果をカスタマイズできます。
多様性:表情、姿勢、口の動きなど多様な動作制御を提供し、アニメーションの多様性とリアルさを高めます。
Halloプロジェクトページ:https://fudan-generative-vision.github.io/hallo
Hallo Github:https://github.com/fudan-generative-vision/hallo
Hallo論文:https://arxiv.org/abs/2406.08801
HuggingFace:https://huggingface.co/fudan-generative-ai/hallo









