
 脚本プランナー▸
 AIアプリ
 AIニュース
Alibaba CloudがQwen2オープンソースモデルを公開
小编 ·

Alibaba CloudがQwen2オープンソースモデルを公開
阿里云がオープンソースモデル Qwen 2 を発表、性能は既存のすべてのオープンソースモデルおよび国内のクローズドソースモデルを上回る。
Qwen 2 モデルは複数のサイズがあり、0.5B、1.5B、7B、57B-A14B、72B の 5 種類のサイズが含まれます。Qwen 2 モデルは、同サイズのモデル評価において、すべてのオープンソースモデルを上回る成績を収めています。CompassArena 大規模モデルアリーナで試してみましたが、確かに非常に強力で、現時点では中国語において非常に優れたモデルと言えるでしょう。
Qwen 2 の機能と特徴:
5 つのサイズの事前訓練および指示チューニングモデル(Qwen2-0.5B、Qwen2-1.5B、Qwen2-7B、Qwen2-57B-A14B、Qwen2-72B);
英語と中国語に加え、27 言語のデータで訓練されている;
多数のベンチマーク評価で最先端の性能を発揮;
コーディングと数学の性能が大幅に向上;
Qwen2-7B-Instruct および Qwen2-72B-Instruct のコンテキスト長は最大 128K トークンまで拡張対応。
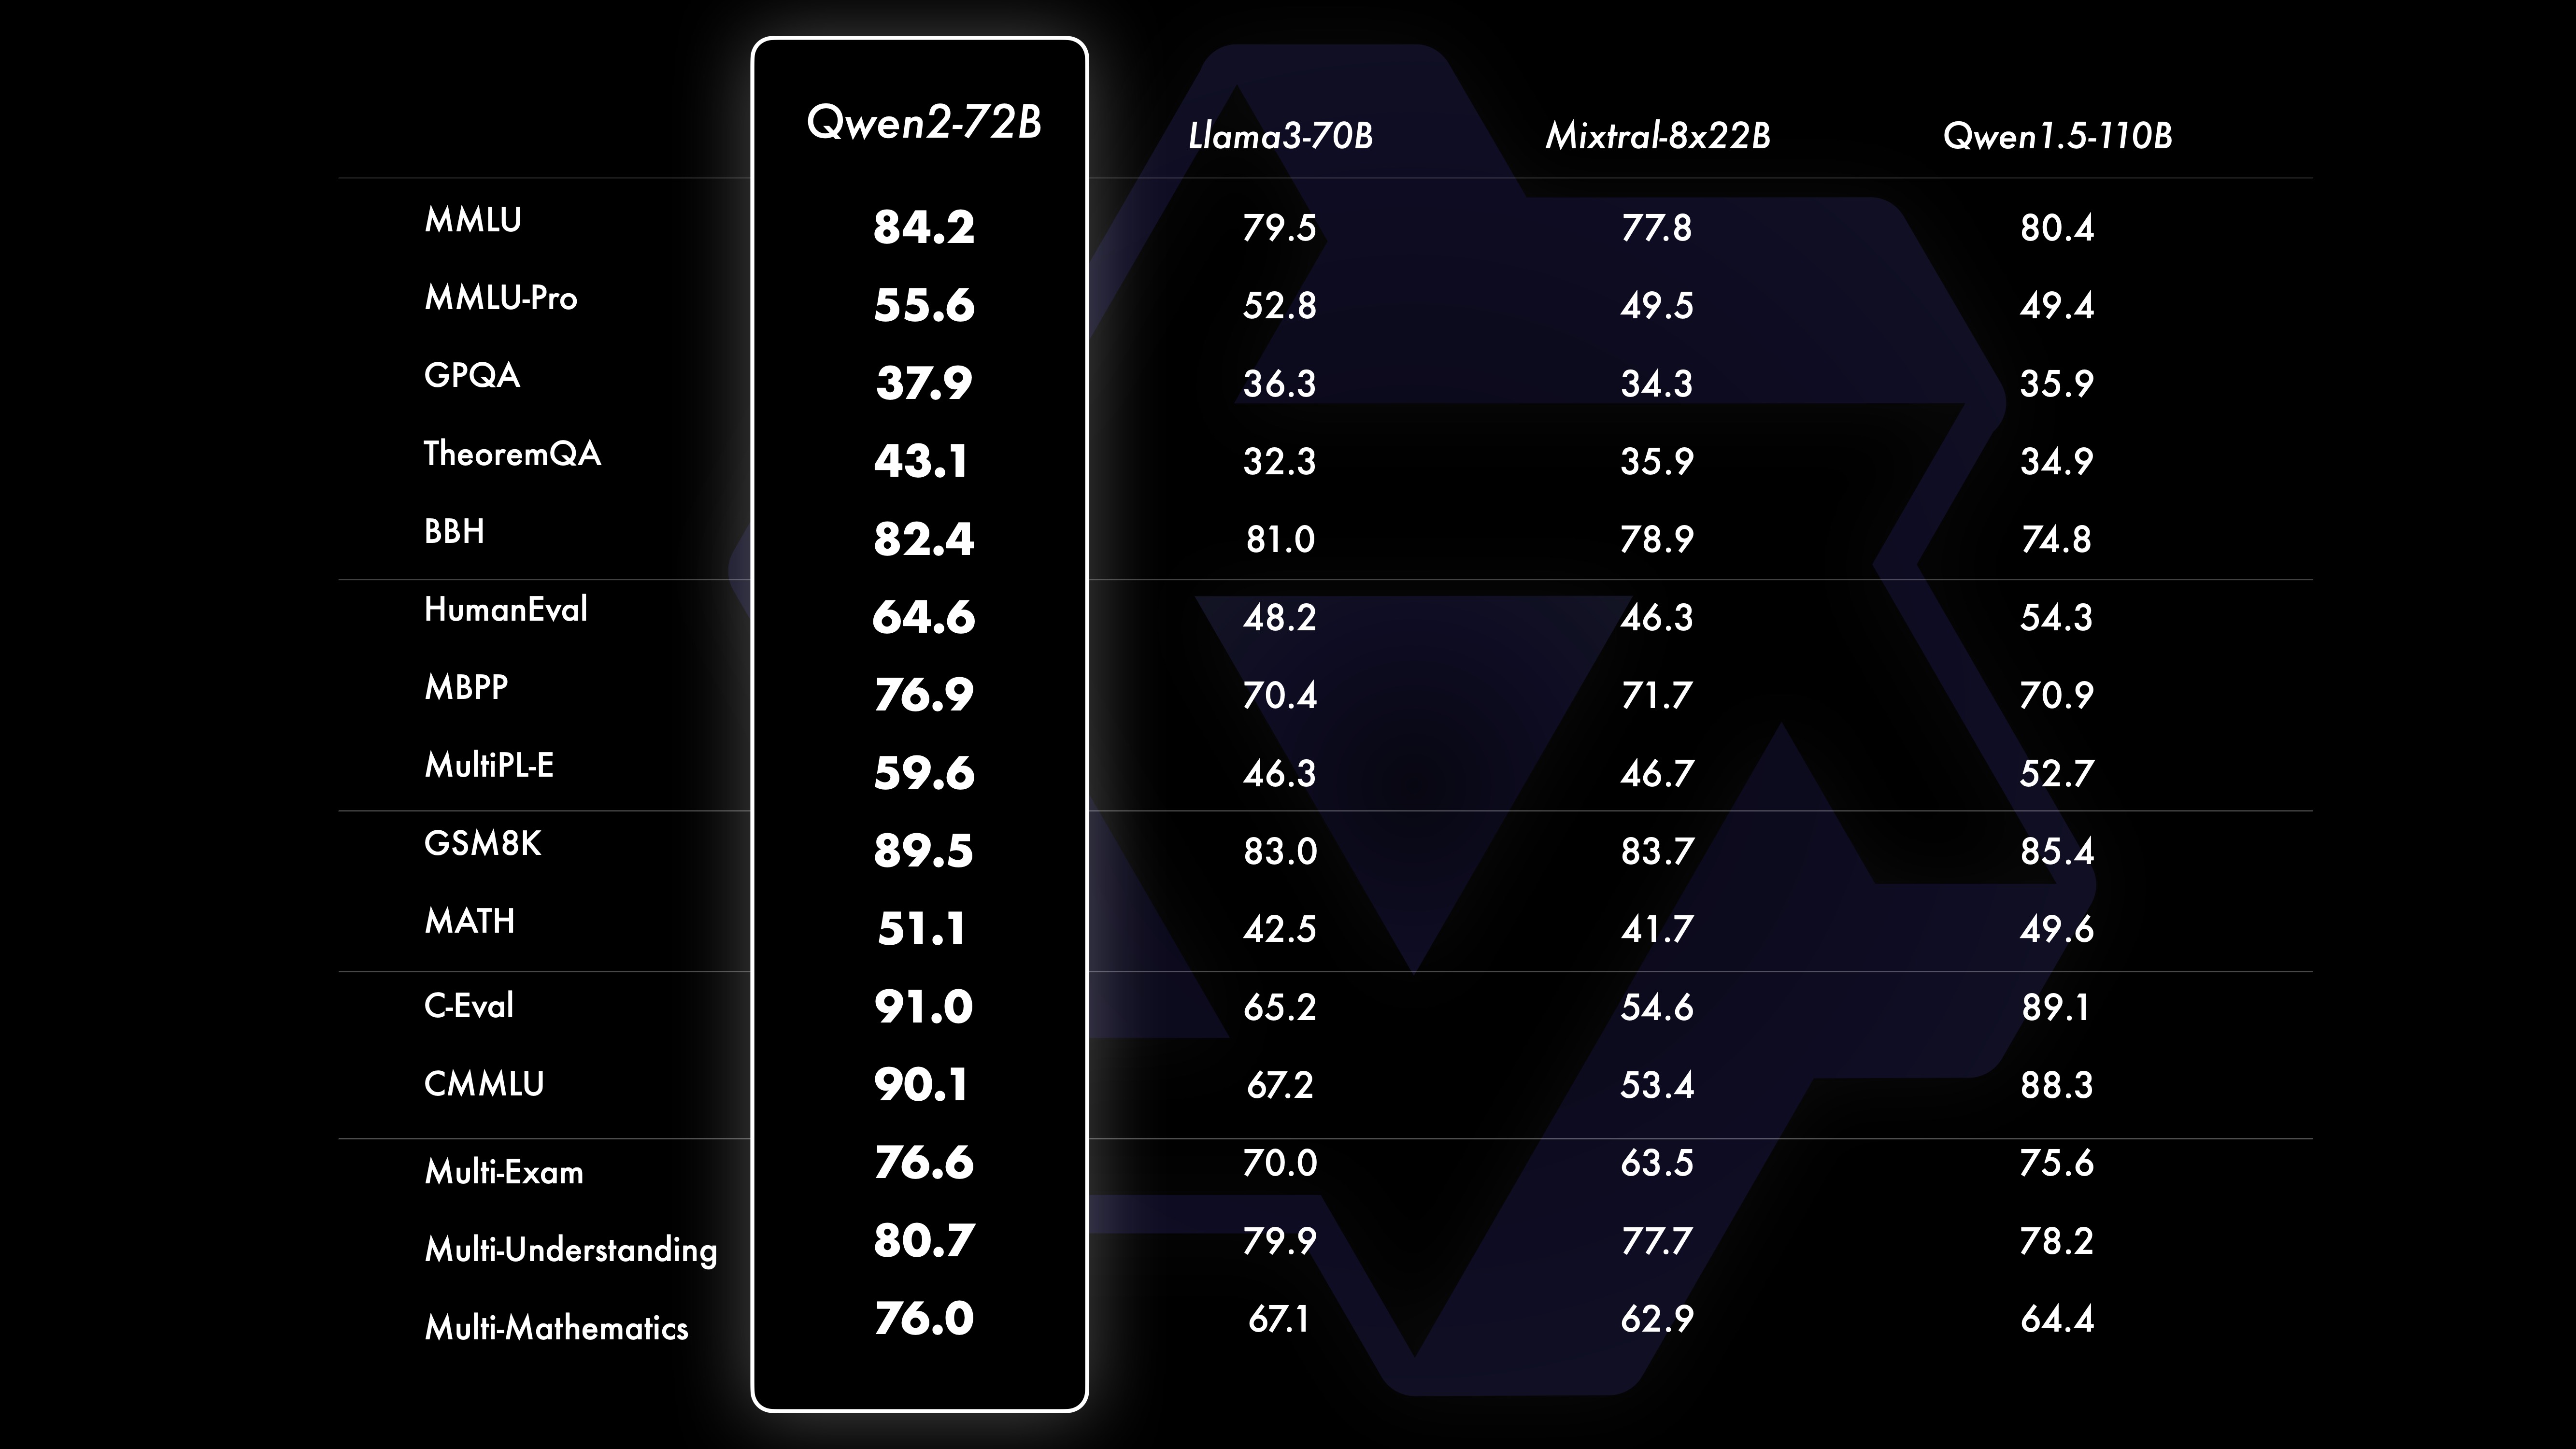
比較評価によると、Qwen1.5 と比較して、大規模モデル(70B+ パラメータ)の性能が顕著に強化されました。ここで重点的に評価するのは、大規模サイズのモデル Qwen2-72B です。基礎言語モデルにおいて、Qwen2-72B と最先端のオープンモデルを、自然言語理解、知識獲得、コーディング能力、数学スキル、多言語能力など、さまざまな能力で評価しました。精心策划されたデータセットと最適化された訓練方法により、Qwen2-72B は Llama-3-70B などの先進的なモデルと比較して卓越した性能を発揮します。特に、参数が少ないにもかかわらず、先代の Qwen1.5-110B の性能を上回っています。
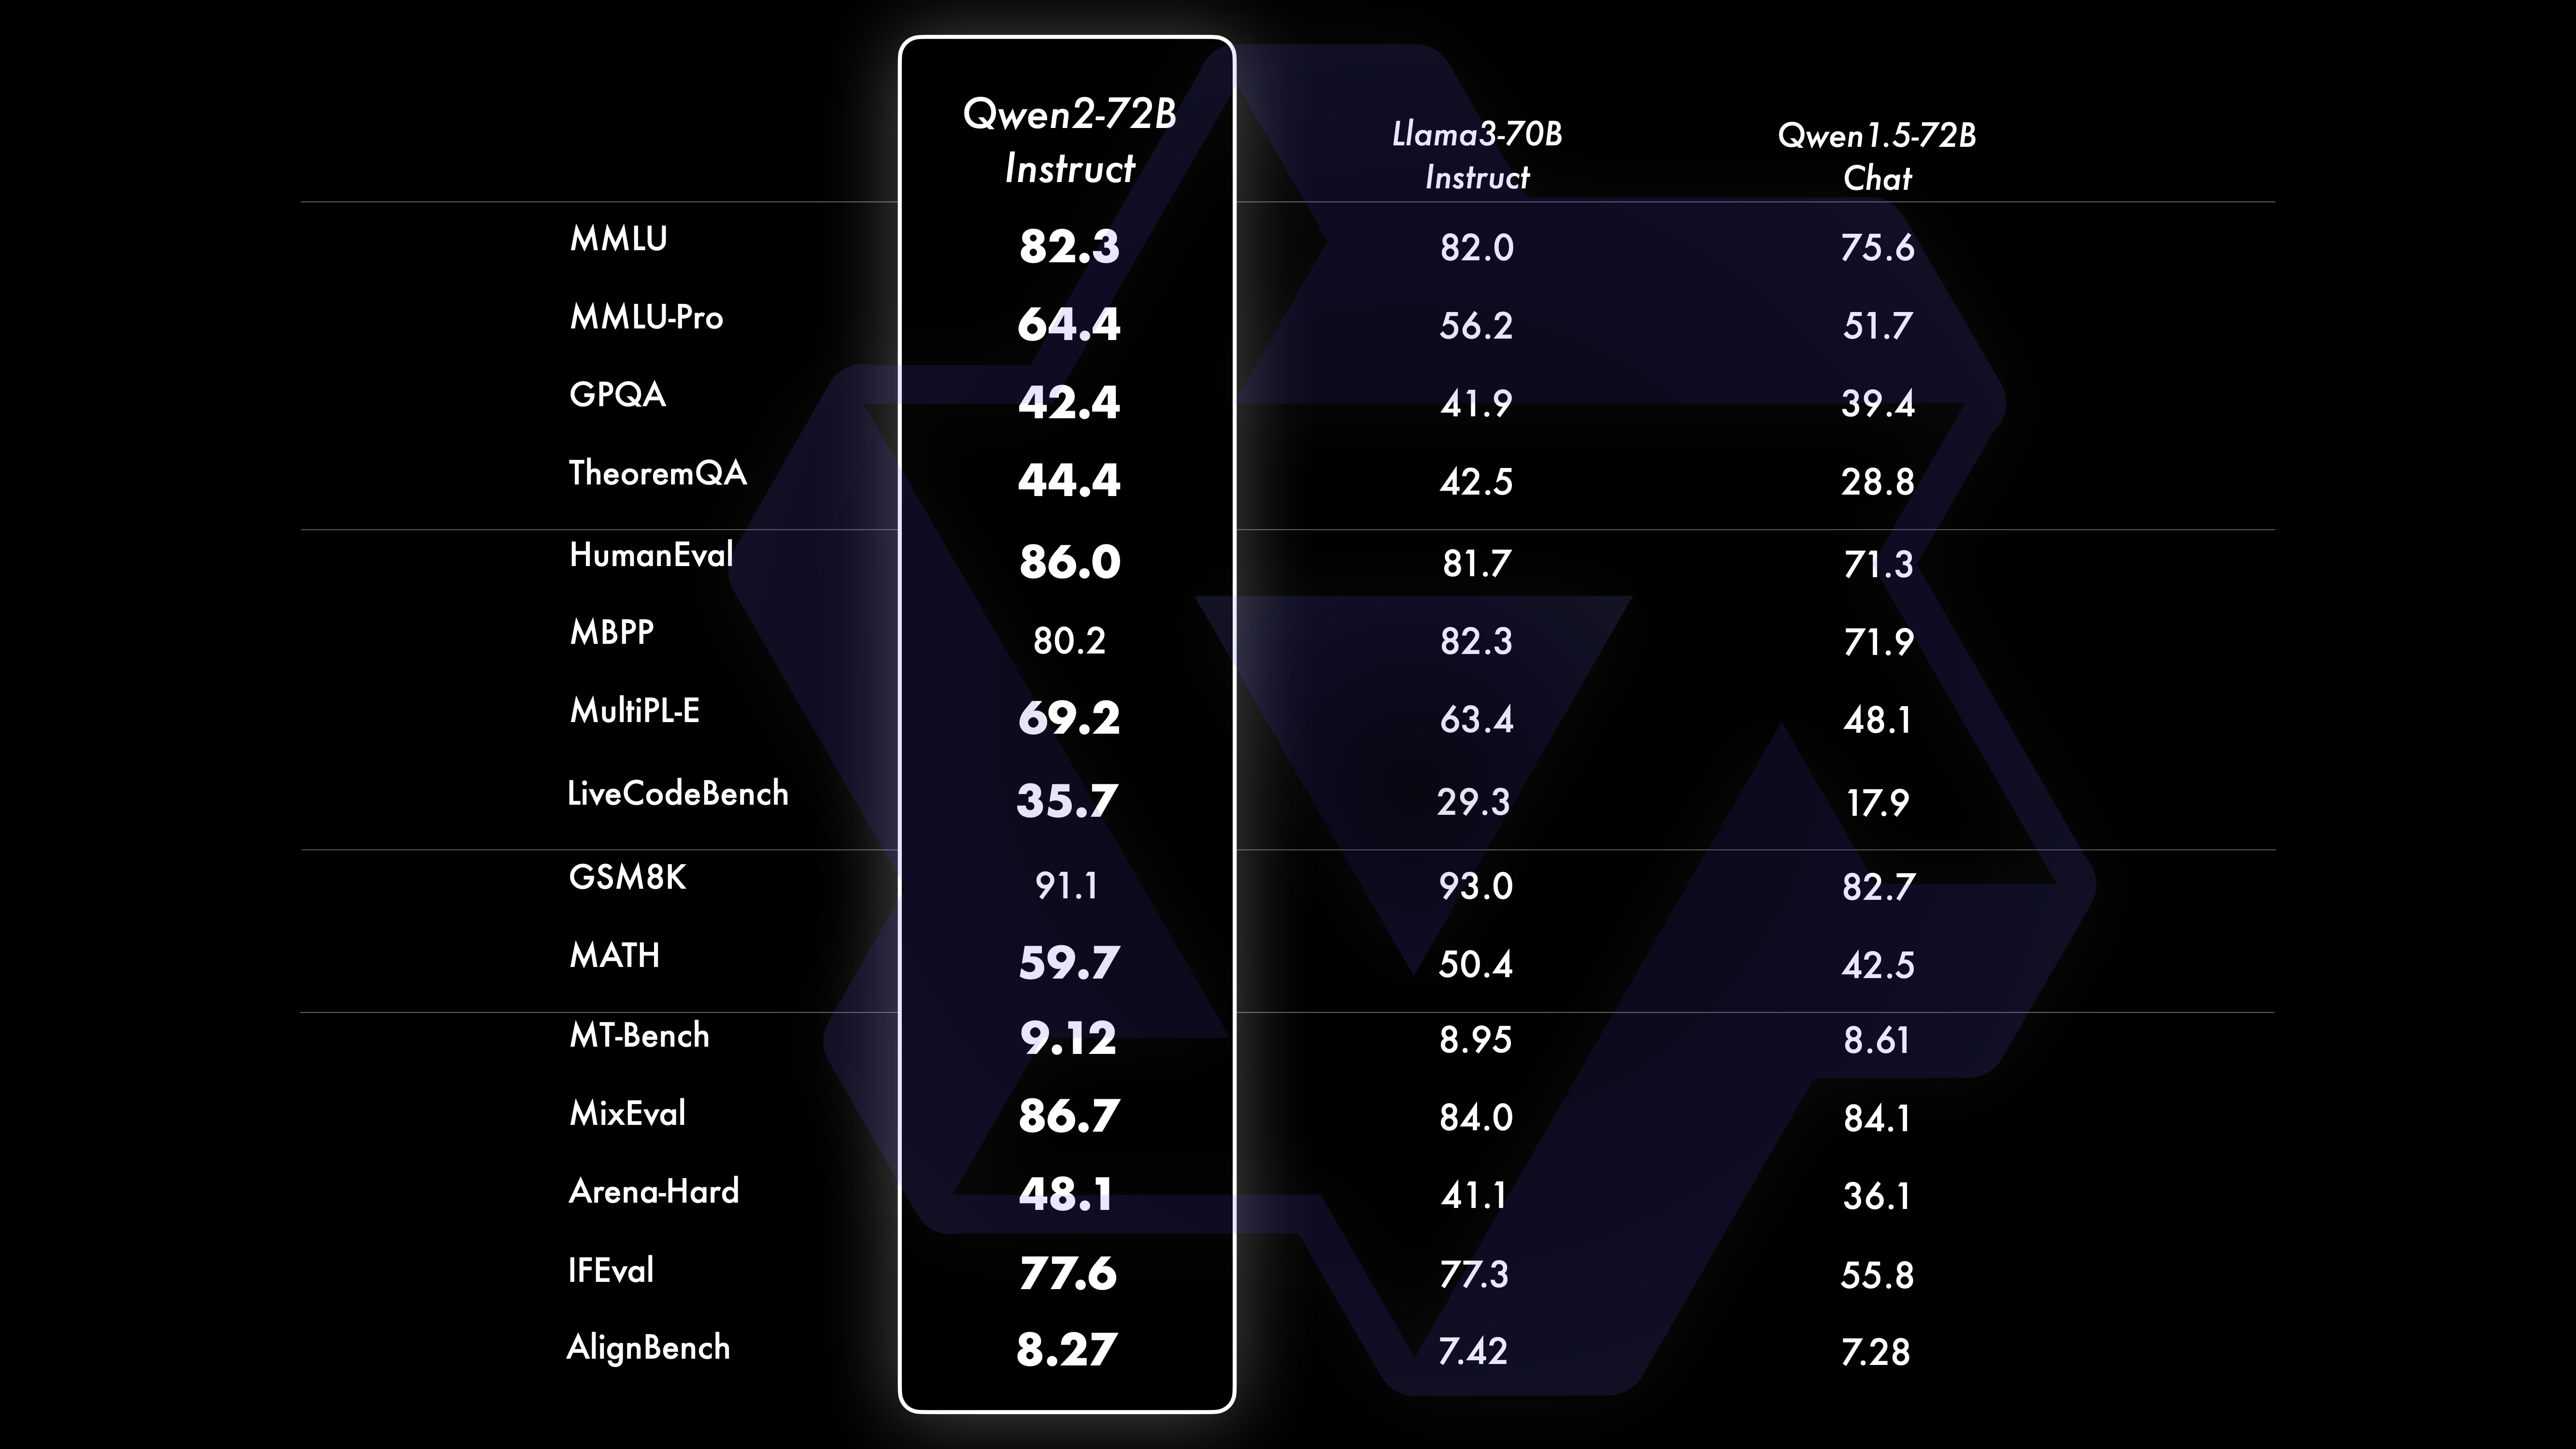
大規模な事前訓練を経た後、私たちはポストトレーニングを行い、Qwen の知性をさらに高めて人間に近づけます。このプロセスは、コーディング、数学、推論、指示追従、多言語理解などの分野でのモデルの能力をさらに向上させます。また、モデルの出力を人間の価値観に沿うようにし、有益で誠実、かつ無害であることを保証します。ポストトレーニング段階の設計はスケーラブルな訓練の原則に従っており、必要とする人手のアノテーションは最小限です。具体的には、数学における拒否サンプリング、コーディングおよび指示追従の実行フィードバック、クリエイティブ写作の逆方向翻訳、ロールプレイなどのスケーラブルな監督など、さまざまな自動アラインメント戦略を通じて高品質で信頼性が高く多様性に富んだ創造的なデモデータと選好データを取得する方法を研究しています。訓練面では、教師あり微調整、報酬モデル訓練、オンライン DPO 訓練を組み合わせた手法を採用しています。また、アラインメント税を最小限に抑えるために、新しいオンラインマージオプティマイザも採用しています。これらの総合的な取り組みにより、以下のようにモデルの能力と知性が大幅に向上しました。
Qwen2 の次の一手は何ですか?
私たちはさらに大きな Qwen2 モデルを訓練し、モデルのスケーリングと最近のデータ拡張を探求しています。さらに、Qwen2 言語モデルをマルチモーダルに拡張し、視覚情報や音声情報を理解できるようにします。近い将来、新しいモデルを継続的にオープンソース化し、ai オープンソース化を加速していきます。ご期待ください!
Github:https://github.com/QwenLM/Qwen2
ダウンロード先:https://modelscope.cn/organization/qwen
体験先:https://modelscope.cn/studios/opencompass/CompassArena/summary
詳細紹介:https://qwenlm.github.io/blog/qwen2/









