
 脚本プランナー▸
 AIアプリ
 AIニュース
ViViD:拡散モデルによるバーチャル試着ビデオ
小编 ·

ViViD:拡散モデルによるバーチャル試着ビデオ
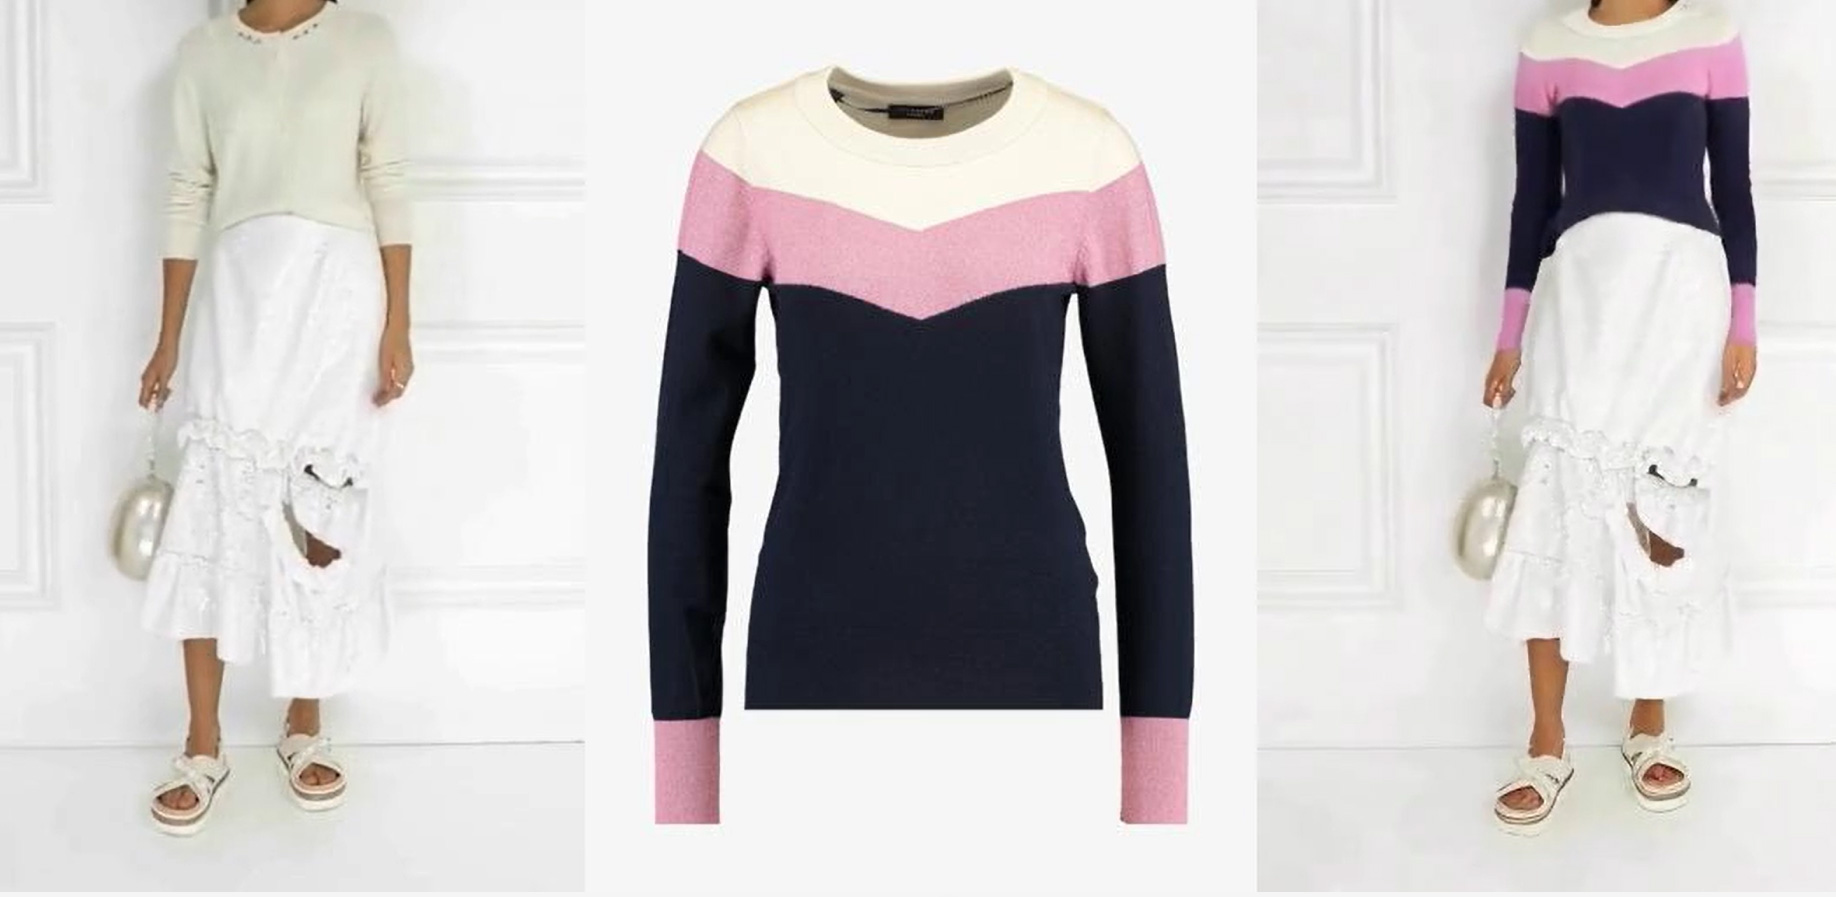
ViViDは、Alibabaが開発した動画バーチャル試着技術で、動画内の人物の衣服を自由に置き換えることができます。ViViDは自然でリアルなバーチャル試着動画を生成でき、服装を動画内の人物に転送しながら、動画の他の部分は変更しません。
ViViDデモサイト:https://becauseimbatman0.github.io/ViViD
ViViD論文アドレス:https://arxiv.org/abs/2405.11794
電子商取引の急速な発展に伴い、消費者はTaobaoやJD.comなどのオンライン電子商取引プラットフォームを通じて、あらゆる種類の服装に簡単にアクセスできるようになりました。しかし、電子商取引サイト上の服装画像だけに依存すると、消費者が自分の身にその服装をどのように着こなすかを想像することは難しいです。画像による試着技術は比較的成熟していますが、動画による試着、特に身体の動きとの相互作用に関する技術はあまり見かけません。
バーチャル試着動画は、衣服をターゲット人物に転送することで実現されます。画像ベースの試着技術をフレームごとに動画分野に直接適用すると、時間的に一貫性のない結果になります。また、これまでの動画ベースの試着ソリューションでは、視覚的な品質が低く、ぼやけた結果しか生成できませんでした。
中国科学技術大学とAlibabaグループの研究チームが共同で開発したViViD動画バーチャル試着技術は、動画を合成することでこの問題を解決し、消費者が実際に衣服を着用した姿を確認できるようにすることを目的としています。この動画フレームワークは、拡散モデル(Diffusion Models)を活用して、高品質で一貫性のある試着動画を実現しています。
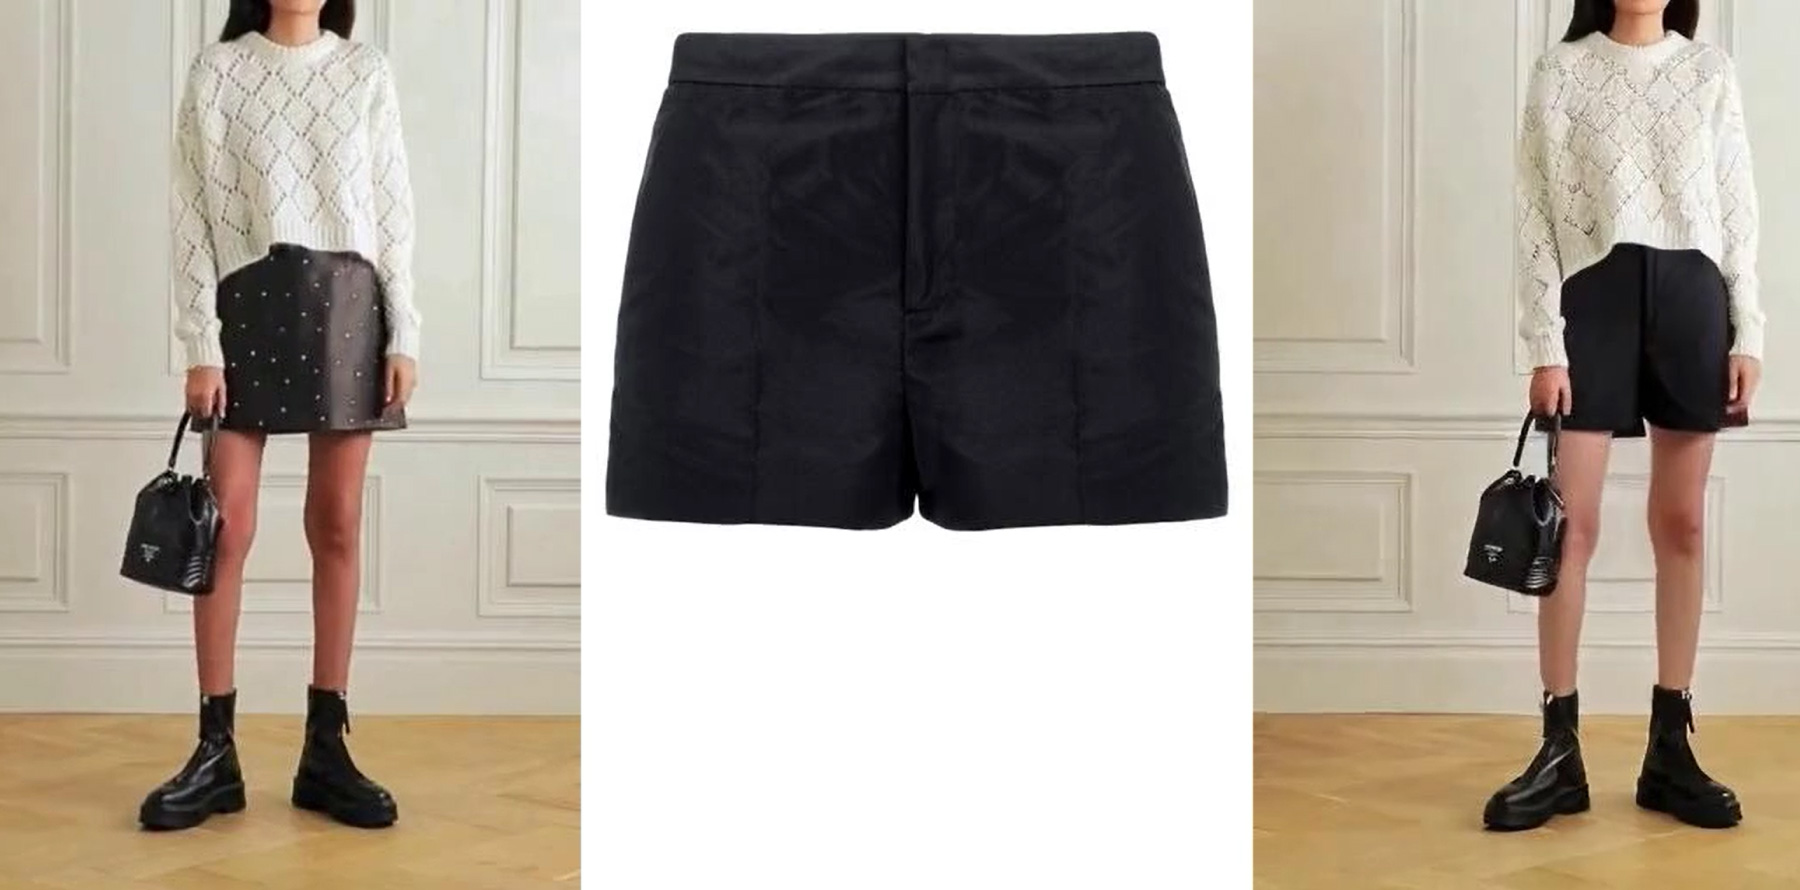
具体的には、衣服エンコーダを設計し、きめ細かい衣服の意味的特徴を抽出してモデルの衣服の詳細を捕捉し、提案された注意特徴融合メカニズムによってそれらをターゲット動画に注入します。時空間の一貫性を確保するために、ポーズ信号をエンコードする軽量なポーズエンコーダを導入し、衣服と人体のポーズとの相互作用をモデルが学習できるようにし、階層的な時間モジュールをテキストから画像への安定した拡散モデルに組み込むことで、より一貫性がありリアルな効果を持つ動画合成を実現します。
さらに、これまでに動画バーチャル試着タスクにおいて最大規模で、最も多様な服装タイプを持ち、最高解像度となる新しいデータセットも収集しました。大規模な実験を通じて、本手法が満足度の高い動画試着結果を生成できることが実証されています。データセット、コード、およびウェイトは公開される予定です。









