
 脚本プランナー▸
 AIアプリ
 AIニュース
SignLLM:世界初の多言語手話生成モデル
小编 ·

SignLLM:世界初の多言語手話生成モデル
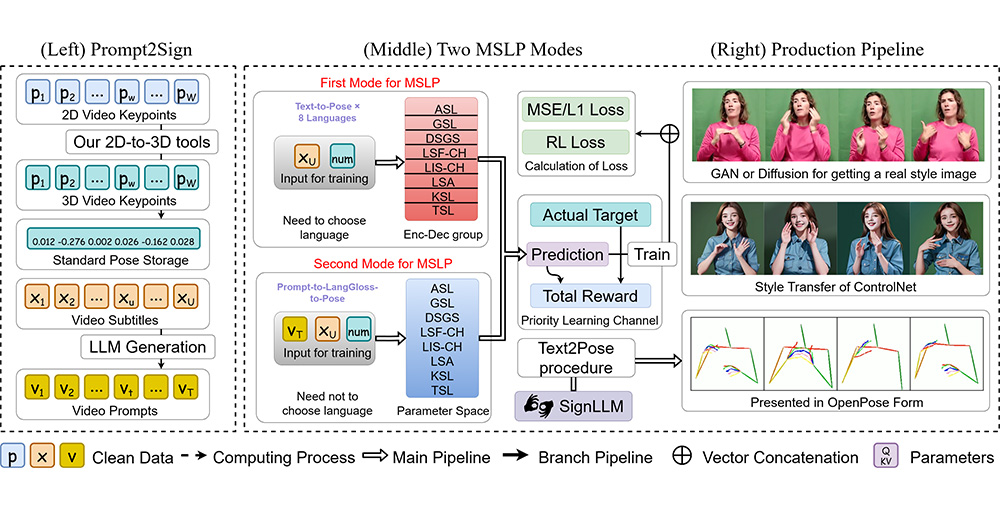
SignLLMは、入力されたテキストやプロンプトを対応する手話のジェスチャーに変換できる最初の多言語手話生成モデルです動画。SignLLMは高度なai技術を用いて、複数種類の手話を生成・翻訳します。SignLLMはPrompt2Signという初の多言語手話データセットを導入し、このデータセットに基づいて手話生成用の複数のモデルを開発しました。このデータセットは、大量の動画をモデルの学習に適した形式に変換し、seq2seqやtext2textなどの翻訳モデルの学習を最適化します。これらのデータセットに基づき、SignLLMのベンチマーク結果を示し、8種類の手話における手話生成タスクで最先端の性能を達成したことを示しました。
SignLLMは、広範な多言語テキストコーパスで学習された大規模言語モデル(LLMs)の強力な翻訳能力に触発され、市販のLLMsを活用してSLTを処理することを目指しています。本論文では、手話動画を口語の言語特徴を反映するように正規化し、市販のLLMsの可読性を向上させるために手話動画を言語類似の表現に変換する新しいSignLLMフレームワークを提案しています。
SignLLMには2つの重要なモジュールが含まれています:
1、ベクトル量子化された視覚記号化モジュールは、手話動画を一連の離散的な文字レベルの記号トークンに変換します。
2、コードブックの再構築とアライメントモジュールは、これらの文字レベルのトークンを単語レベルの記号表現に変換します。記号-テキストアライメント損失は、記号トークンとテキストトークン間のギャップをさらに埋め、意味的な互換性を強化します。2つの広く使用されているSLTベンチマークで最先端のグルスレス(gloss-free)結果を達成しました。
SignLLM GitHubアドレス:https://signllm.github.io/









