
 脚本プランナー▸
 AIアプリ
 AIニュース
Synthesia、表情を予測するAIデジタルヒューマン「Expressive-1 AI Avatars」を発表

Synthesia、表情を予測するAIデジタルヒューマン「Expressive-1 AI Avatars」を発表
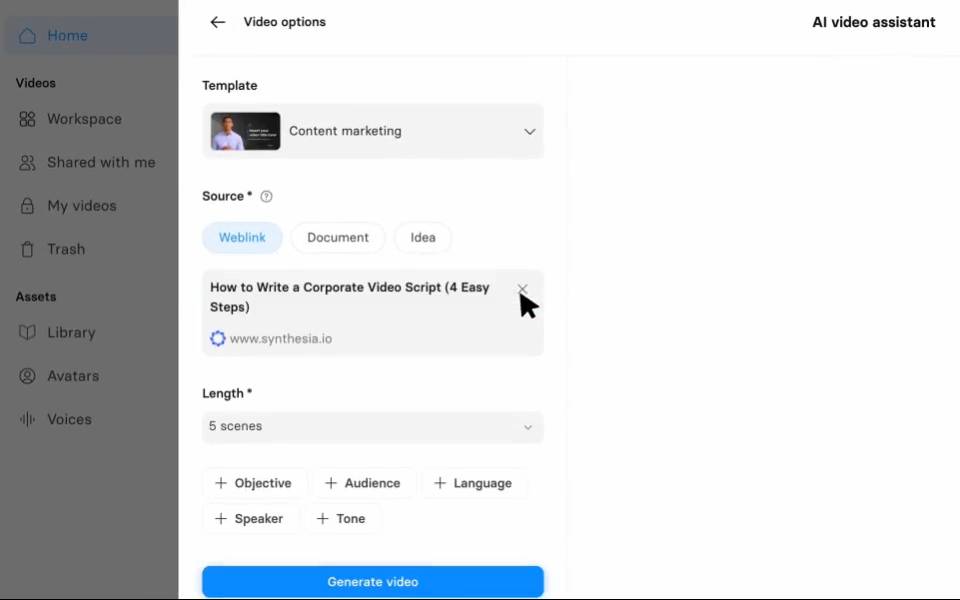
Synthesia社がExpressive-1 ai Avatarsを発表しました。これはスクリプトを通じて表情を予測できるAIデジタルヒューマンの形象で、高い表現力と適応性を備えています。Expressive-1 AI Avatarsはデジタルヒューマンによる動画制作に革命的な変化をもたらし、効率的でコストパフォーマンスに優れた使いやすいソリューションを multiple な言語とシーンに提供します。
Expressive-1 AI Avatarsの主な機能:
表情予測:テキストスクリプトに基づいて眉をひそめる、微笑むなどの表情を予測します。
表現力の強化:トーン、顔の表情、ボディランゲージを用いた表現。
感情反応の同期:スクリプトの感情コンテンツに応じて、一致する表情とトーンを披露します。
人間の微表情とボディランゲージの模倣:人間の微表情や微妙な身体の動きを再現します。
音声と口の動きの同期:音声と唇の動きの一貫性を確保します。
シーンへの適応:交流のシーンやコンテンツに応じて表現方法を調整します。
Synthesia社の紹介:
Synthesiaは人工知能驱動の動画制作ツールであり、高品質で魅力的な動画を、高価な機材や専門的なスキルを必要とせずに制作できます。AIデジタルヒューマンを生成するという独自のアプローチで動画を作成します。
主要なAI動画生成プラットフォーム:スタジオ品質の高い動画を迅速に作成できます。
多言語サポート:130以上の言語に対応したAIアバターと音声合成。
カスタムAIアバター:個性的で専門的な動画コンテンツを提供します。
テキストから動画への変換:スクリプトを自動的に高品質な音声付き動画に変換します。
自動字幕生成:動画の高いアクセシビリティを実現します。
効率的な動画作成フロー:スライド作成のようにシンプルで迅速。
コストと時間の効率:従来の動画制作のコストと時間を大幅に削減します。
ユーザーエンゲージメントと教育効果の向上:e-learningへの参加率を向上させます。
簡単な保守と更新:動画更新やフィードバックツールを提供し、ユーザーツールへの埋め込みをサポートします。









