
 Assistant scénario▸
 Apps AI
 Actualités AI
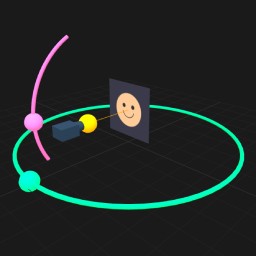
Qwen-Image-Edit-2511 : contrôle de caméra 3D
Qwen-Image-Edit-2511 : contrôle de caméra 3DIntroduction
📝 Présentation de Qwen-Image-Edit-2511
Qwen-Image-Edit-2511 est un modèle d'édition d'images open source développé par l'équipe Tongyi Qianwen d'Alibaba. Il peut être considéré comme une version améliorée du modèle précédent (Qwen-Image-Edit-2509). Il résout principalement un problème assez gênant : après que de nombreux modèles d'IA aient modifié une image, le personnage semble « changer de visage » et ne ressemble plus à la personne d'origine. Le terme technique pour ce phénomène est la dérive d'image.
Ce modèle combine un encodeur visuel et un grand modèle de langage. Il vous suffit de lui indiquer en langage naturel comment modifier l'image, et il se charge de la retoucher tout en préservant globalement l'éclairage, les textures et la structure de l'arrière-plan de l'image originale.
🚀 Fonctionnalités principales
Cohérence des personnages très élevée
C'est l'amélioration la plus notable de la version 2511.
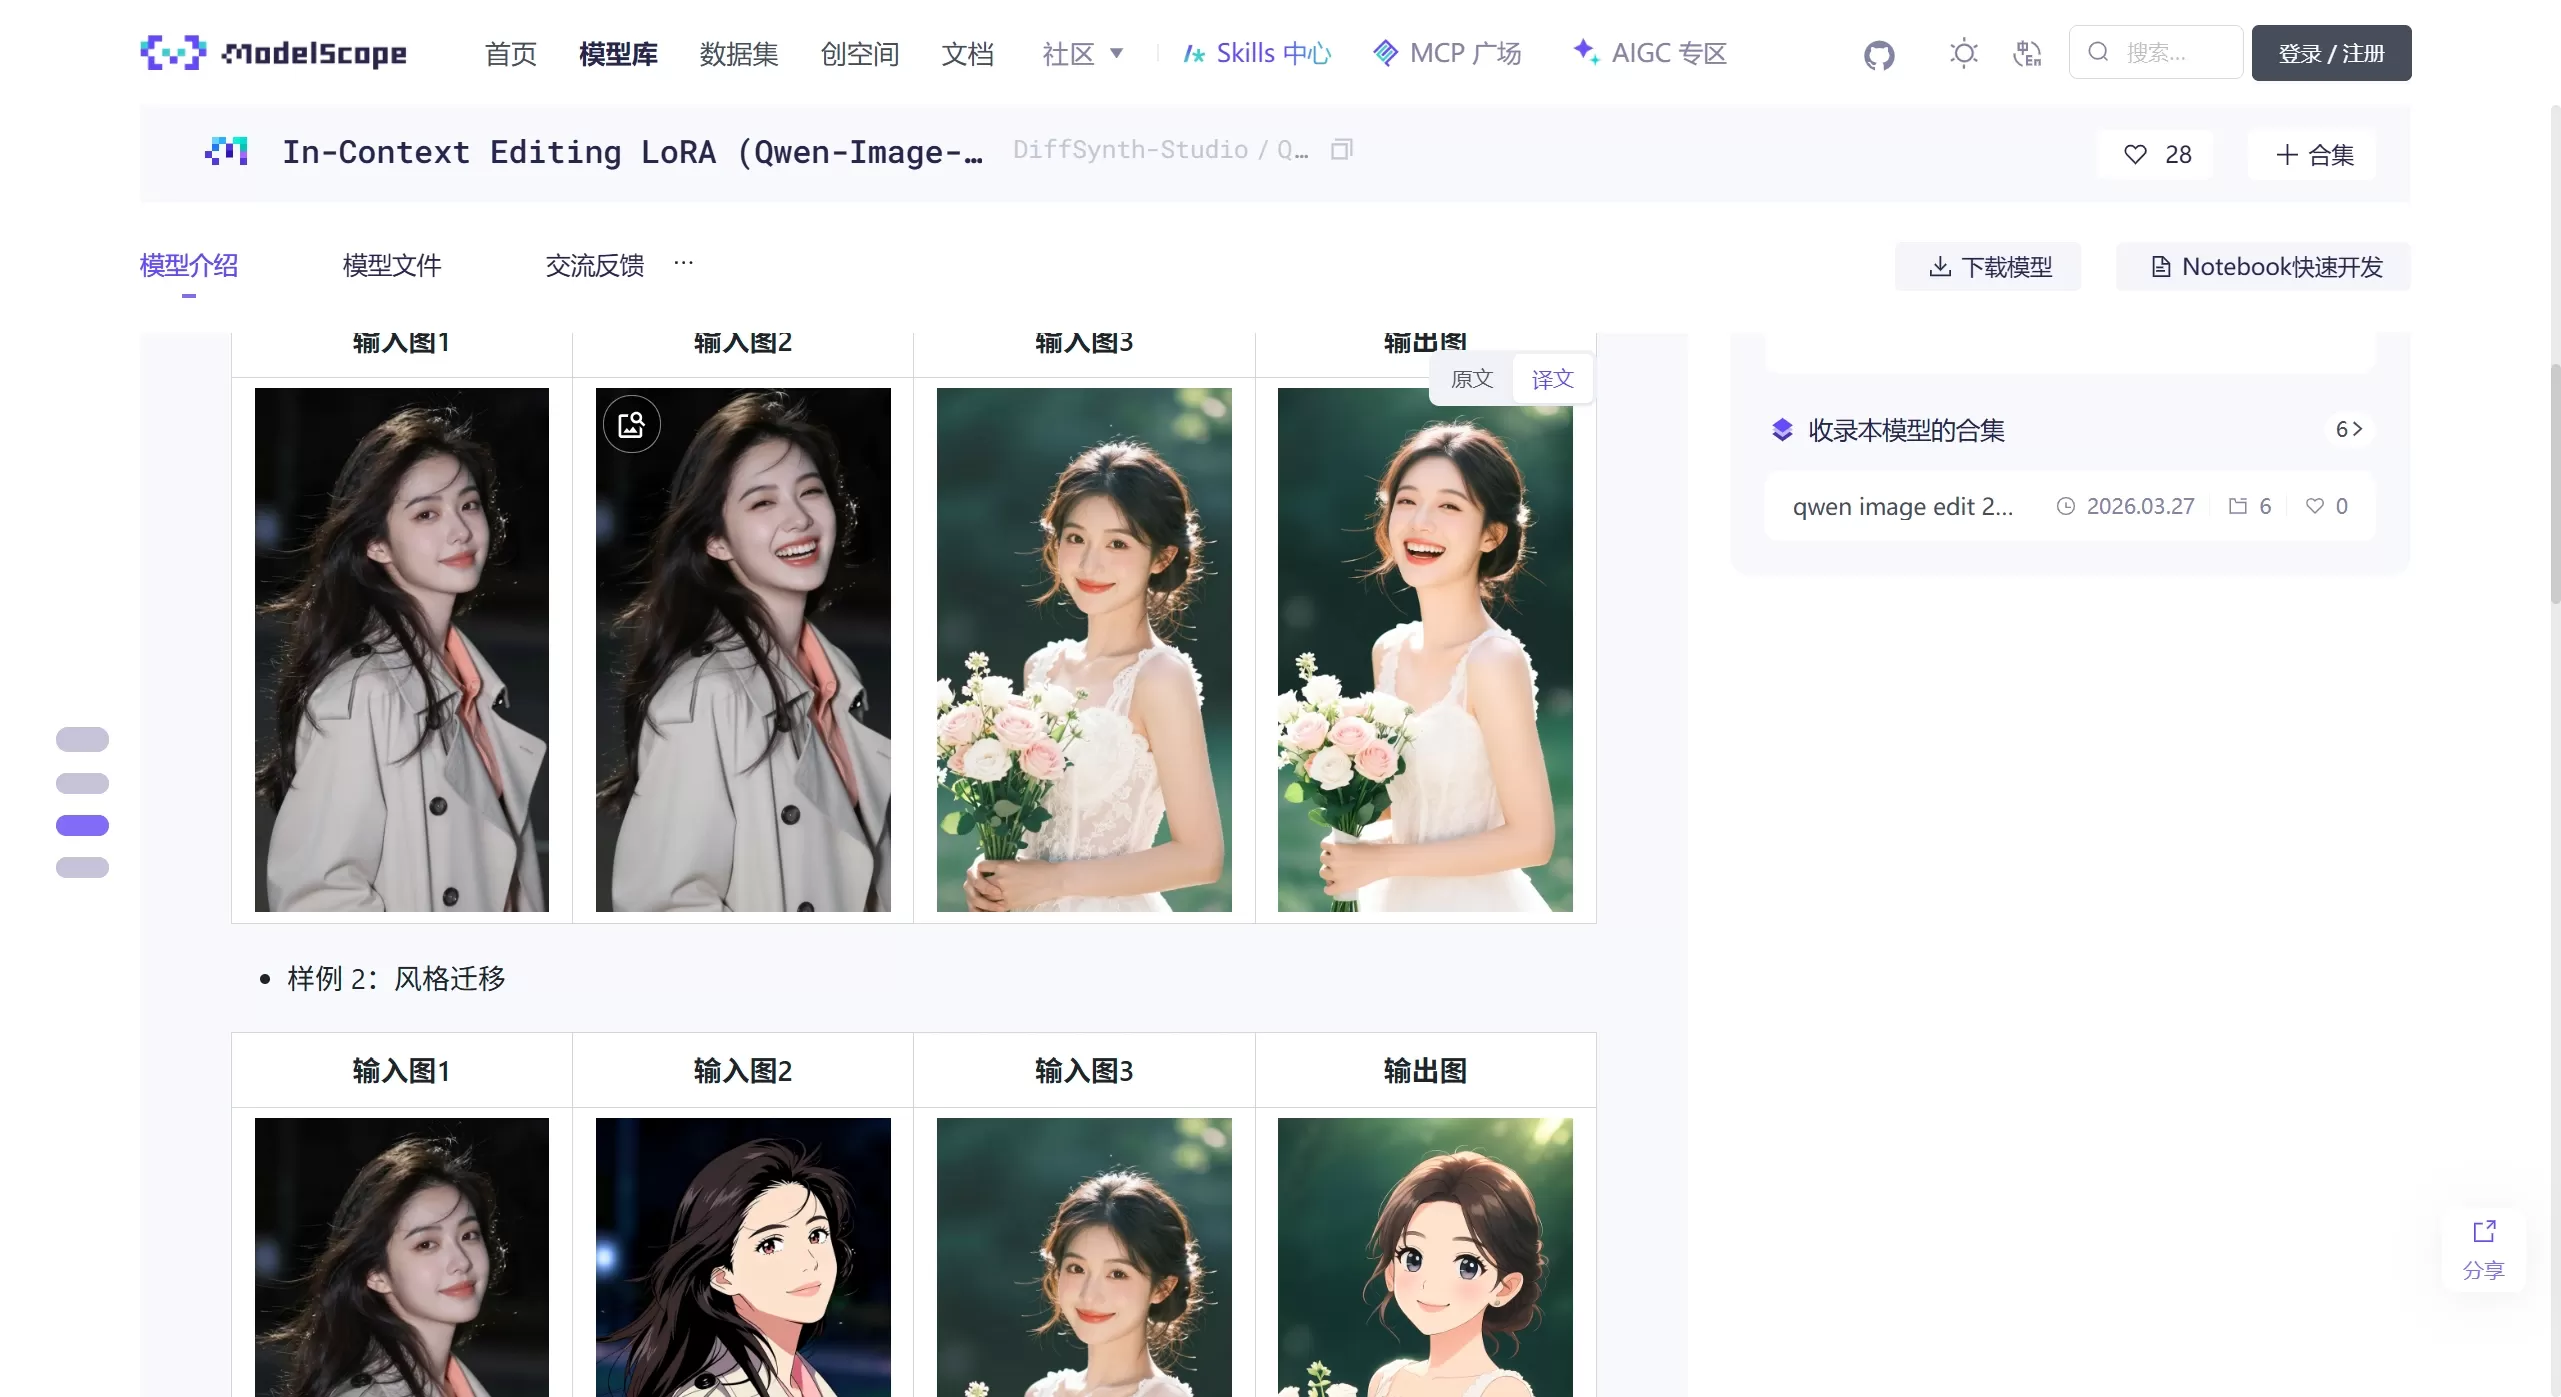
Édition d'une seule personne : que vous changiez les vêtements, l'arrière-plan ou la pose, le modèle parvient à préserver les traits du visage (yeux, coiffure, expression), évitant ainsi que le résultat ne soit méconnaissable.
Fusion de photos de groupe : il est possible de combiner deux portraits individuels de personnes différentes en une photo de groupe naturelle. Le modèle ajuste automatiquement l'éclairage, l'angle de perspective et la posture d'interaction des deux personnes pour que le résultat ressemble à une véritable prise de vue réalisée en même temps.
Fonctions « contrôle de caméra 3D » et LoRA intégrées
Plus besoin d'ajouter une multitude de plugins, le modèle intègre directement plusieurs capacités LoRA courantes :
Génération multi-vues : indiquez-lui « vue de gauche », « vue en contre-plongée » ou « gros plan », et il modifiera l'angle comme s'il manipulait une caméra.
Rééclairage : possibilité de modifier la direction ou le type de source lumineuse, par exemple « lumière douce » ou « contre-jour latéral », pour changer l'ambiance.
Améliorations en compréhension géométrique et en design industriel
La compréhension spatiale est meilleure que celle de la génération précédente, avec la capacité de tracer automatiquement des lignes auxiliaires ou d'effectuer de simples annotations structurelles.
Remplacement fiable des matériaux : sans modifier la forme de l'objet, il est possible de transformer une table en bois en table en métal, tout en conservant les reflets et l'éclairage adaptés.
🛠️ Cas d'utilisation
Design e-commerce : essayage virtuel pour mannequins (le visage et la pose restent inchangés, seuls les vêtements changent) ; génération de plusieurs vues d'angle à partir d'une seule image produit.
Photographie créative : photos de couple à distance, en combinant deux portraits individuels en une photo de groupe naturelle ; transfert de style, par exemple transformer une photo réelle en style Pixar ou pixel art, tout en conservant les traits du visage.
Design industriel : rendu rapide d'esquisses en rendus avec différents matériaux (cuir, métal, etc.) ; ajout automatique de lignes auxiliaires géométriques sur les plans de conception.
Création de contenu : développement d'un personnage d'IP, en s'appuyant sur une seule image de design pour générer des photos de ce personnage dans différents contextes (bureau, montagne enneigée, café), facilitant ainsi la narration d'histoires.
⚖️ Avantages et inconvénients
✅ Avantages
Cohérence très élevée : parmi les modèles open source, il fait partie de ceux qui réussissent le mieux à préserver les traits du visage, résolvant pratiquement le problème du « changement de visage à chaque modification ».
Faible barrière à l'entrée : LoRA intégrée, pas besoin d'entraîner ou de télécharger des poids supplémentaires. Il suffit d'utiliser des prompts pour ajuster des fonctions avancées comme l'éclairage et l'angle de vue.
Bonne compréhension du chinois : comme il s'appuie sur Tongyi Qianwen, il comprend globalement les instructions en chinois et gère bien les descriptions complexes.
Open source et gratuit : peut être exécuté en local dans des outils comme ComfyUI, les données ne sortent pas de votre machine et il n'y a pas de frais d'API à payer.
❌ Inconvénients
Difficultés avec les angles extrêmes : bien qu'il prenne en charge le contrôle de vue 3D, face à des angles très prononcés (par exemple un fish-eye extrême ou une rotation particulièrement complexe), la structure des objets se déforme parfois ou leur nombre est incorrect.
Précision géométrique limitée : il possède des capacités de raisonnement géométrique, mais n'atteint pas la précision d'un logiciel de CAO professionnel. Il ne convient pas pour dessiner des plans techniques de précision.
Exigences matérielles élevées : pour une exécution en local, une mémoire vidéo importante est nécessaire. Pour une utilisation confortable, une RTX 4090 ou supérieure est recommandée.
💻 Comment utiliser Qwen-Image-Edit-2511
La méthode主流 actuelle consiste à utiliser ComfyUI pour un déploiement en local.
Préparation de l'environnement : installez ComfyUI et placez les fichiers du modèle Qwen-Image-Edit-2511 (généralement au format .safetensors) dans le répertoire models/checkpoints.
Mise en place du workflow : ajoutez le nœud Qwen2.5-VL (pour comprendre le contenu de l'image), puis connectez un VAE Encoder (pour contrôler l'apparence), et enfin fournissez l'image source ainsi qu'un prompt, par exemple « remplace les vêtements de l'image 1 par ceux de l'image 2, sans changer la composition ».
Techniques avancées (LoRA) : le modèle intègre déjà des LoRA, qui peuvent également être déclenchées par des prompts. Par exemple, en écrivant lighting: soft ou view: side, vous activez les modules intégrés d'éclairage ou de changement d'angle. Pour l'essayage virtuel en e-commerce, l'entraînement d'une LoRA dédiée aux vêtements donnera des résultats plus précis.
❓ Questions fréquentes
Q1 : Pourquoi le personnage généré ne ressemble-t-il toujours pas à l'original ?
R : Vérifiez d'abord si votre prompt ne contient pas par erreur des descriptions modifiant les traits du visage. La version 2511 est sensible aux prompts ; essayez d'utiliser des formulations restrictives comme « conserver l'apparence d'origine » ou « ne modifier que l'arrière-plan/les vêtements ». De plus, maintenez le CFG (guidage par prompt) dans la plage recommandée (par exemple 1,0–1,5), car une valeur trop élevée peut dégrader les résultats.
Q2 : Peut-il faire des mouvements de caméra vidéo ?
R : Il ne peut pas générer directement de vidéo, il ne produit que des images statiques. Cependant, vous pouvez utiliser le même personnage pour générer des images sous différents angles (face, profil, dos), puis les assembler dans un logiciel de montage vidéo pour simuler un effet de travelling 3D.
Q3 : Peut-il fonctionner sur un téléphone portable ?
R : C'est peu réaliste, car le modèle comporte un nombre important de paramètres (échelle 20B) et ne peut pas être exécuté sur un mobile. Il est préférable de le déployer en local sur un ordinateur équipé d'une carte graphique performante (par exemple RTX 4090), ou d'utiliser un service GPU dans le cloud.














