
 Assistant scénario▸
 Apps AI
 Actualités AI
Story-Iter : solution de visualisation d'histoires longues par UCSC-VLAA
Story-Iter : solution de visualisation d'histoires longues par UCSC-VLAAIntroduction
Qu'est-ce que Story-Iter ?
Story-Iter est une solution de visualisation d'histoires longues proposée par UCSC-VLAA. Cette tâche consiste à générer des séquences d'images cohérentes à partir d'un texte narratif, prenant en charge des scénarios d'histoire longue pouvant aller jusqu'à 100 images.
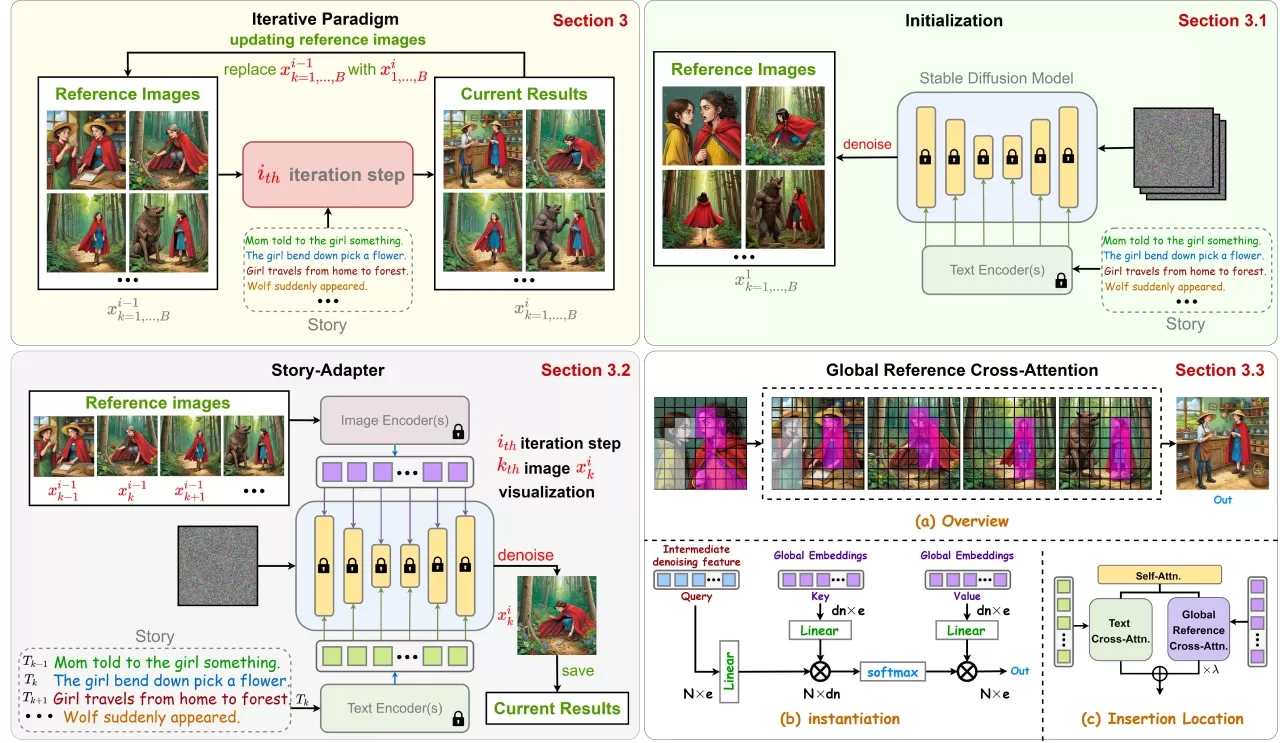
Contrairement aux méthodes autorégressives, Story-Iter adopte un mécanisme d'itération externe — en dehors des étapes de débruitage du modèle de diffusion, une boucle d'itération supplémentaire est introduite pour améliorer la qualité de chaque image en intégrant continuellement toutes les images de référence générées au tour précédent.
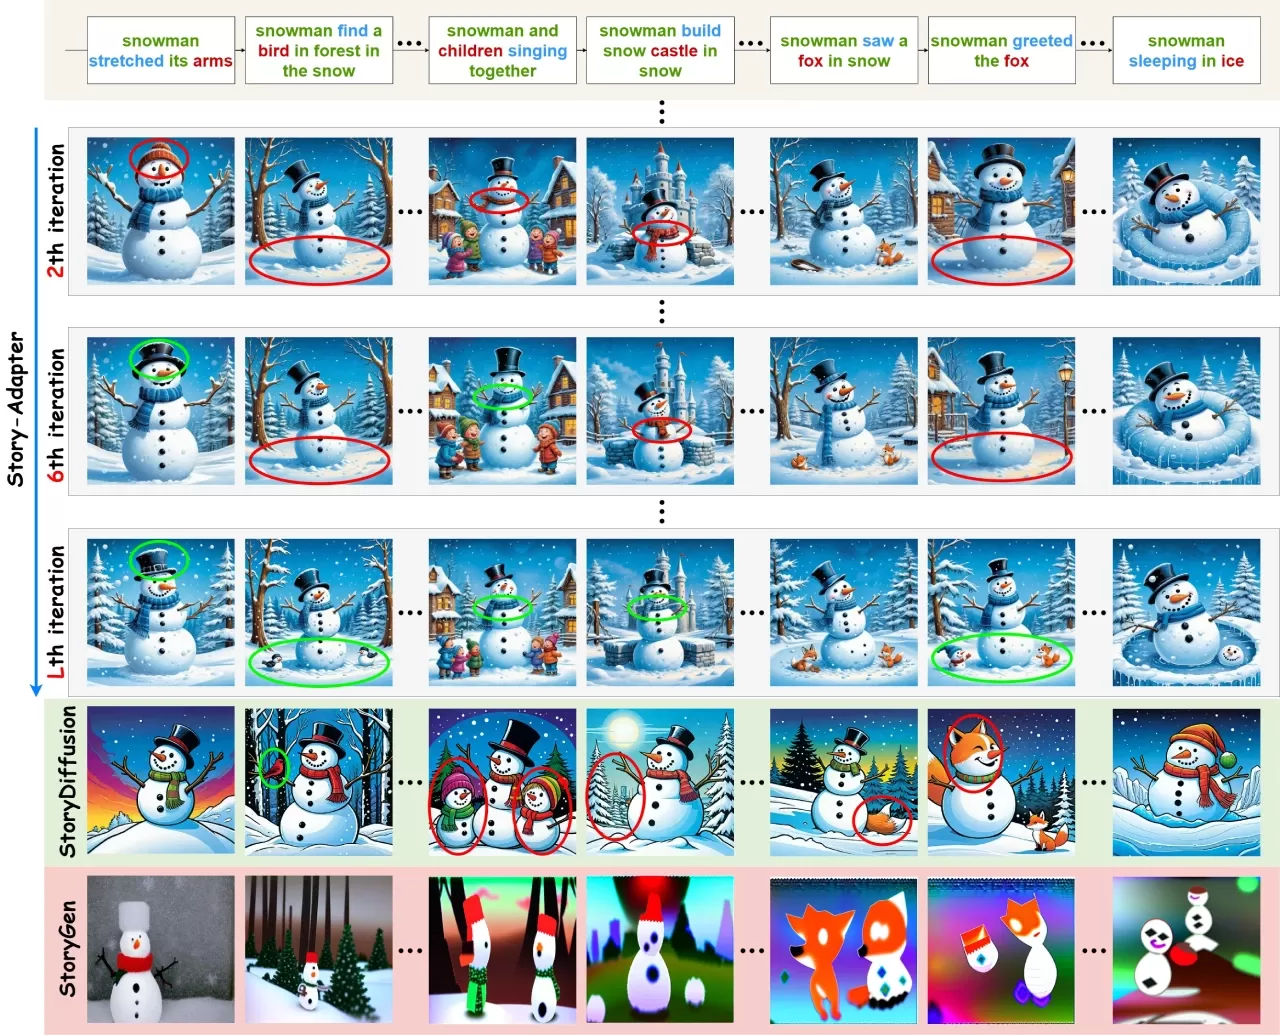
🔧 Fonctionnalités de Story-Iter
1. Module d'attention croisée de référence globale
Plug-and-play : aucune formation requise, intégration directe dans les modèles de diffusion existants (tels que Stable Diffusion)
Intégration globale : utilisation d'une intégration globale pour modéliser toutes les images de référence, garantissant la cohérence sémantique sur de longues séquences
Mécanisme d'attention croisée : agrégation du flux d'informations de toutes les images de référence pendant le processus de génération d'images
2. Paradigme d'optimisation itérative
Phase d'initialisation : génération de la version initiale de chaque image basée sur le texte narratif
Raffinement itératif : utilisation de toutes les images générées au tour précédent comme références pour le tour suivant, optimisation progressive
Amélioration progressive : obtention d'une génération d'interactions fines précise en combinant de manière répétée le contexte visuel global et les contraintes textuelles
3. Prise en charge des longues séquences
Prise en charge de la génération de séquences d'images narratives longues pouvant atteindre 100 images
Performances excellentes en termes de cohérence sémantique et d'interactions fines
🎯 Cas d'utilisation de Story-Iter
Génération de bandes dessinées/livres illustrés : génération automatique de pages de BD cohérentes à partir de longs textes narratifs
Pré-visualisation d'animation : fourniture de prévisualisations visuelles au niveau du storyboard pour la production d'animations
Storyboards de films : aide aux réalisateurs et aux directeurs de la photographie à générer rapidement des esquisses de plans
Livres d'histoires pour enfants : création de livres narratifs richement illustrés pour les contenus éducatifs
Créativité publicitaire : génération de récits visuels promotionnels longs pour les produits
Cinématiques de jeux vidéo : génération de récits visuels continus pour les scénarios de jeux
✅ Avantages et inconvénients de Story-Iter
Avantages
Sans formation : aucune formation ou réglage fin supplémentaire du modèle requis, plug-and-play
Efficacité computationnelle : coût computationnel inférieur par rapport aux méthodes introduisant de grands encodeurs multimodaux
Garantie de cohérence : maintien efficace de la cohérence des personnages, des scènes et du style sur de longues séquences grâce au mécanisme de référence globale
Interactions fines : capable de générer des scènes de haute qualité avec des interactions complexes entre les personnages
Évolutivité : prend en charge la génération d'histoires longues pouvant atteindre 100 images, bien au-delà des méthodes traditionnelles
Inconvénients
Coût d'itération : bien que sans formation, le processus itératif nécessite plusieurs inférences, ce qui entraîne un coût en temps élevé
Dépendance au modèle de base : les performances sont limitées par les capacités du modèle de diffusion sous-jacent (tel que SD)
Défi des histoires longues : malgré la prise en charge de 100 images, une dérive de cohérence peut encore apparaître dans des histoires très longues
Pas de code officiel : le dépôt GitHub peut ne pas être encore entièrement public ou être à un stade précoce
🛠️ Comment utiliser Story-Iter
Préparation de l'environnement
# Cloner le dépôt (en supposant qu'il est déjà public)
git clone https://github.com/UCSC-VLAA/story-iter.git
cd story-iter
# Installer les dépendances
pip install -r requirements.txt
Flux d'utilisation de base
Préparer le texte de l'histoire : décomposer l'histoire en descriptions textuelles continues (chaque image correspond à une description)
Génération initiale : exécuter la première itération de génération, produisant la séquence d'images initiale uniquement à partir des invites textuelles
Optimisation itérative :
Utiliser les images générées comme références pour la prochaine itération de génération
Activer le module GRCA pour agréger les informations de référence globales
Répéter l'itération jusqu'à convergence ou jusqu'à atteindre le nombre d'itérations prédéfini
Résultat de sortie : obtenez la séquence d'images narrative cohérente finale optimisée
Paramètres clés
--num_iterations : nombre d'itérations (généralement 3 à 5 itérations donnent une amélioration notable)
--use_grca : activer le module d'attention croisée de référence globale
--num_frames : nombre d'images de l'histoire (jusqu'à 100 images prises en charge)
❓ Questions fréquentes sur Story-Iter
Q1 : Quelle est la relation entre Story-Iter et Story-Adapter ?
Selon les informations arXiv, Story-Iter et Story-Adapter sont des noms différents pour le même projet. La référence de l'article indique Story-Adapter: A Training-free Iterative Framework for Long Story Visualization, mais le nom Story-Iter est utilisé dans la page du projet et dans la soumission à ICLR 2026.
Q2 : Faut-il entraîner son propre modèle ?
Non. Story-Iter est un cadre sans formation (training-free) qui peut être utilisé directement sur des modèles Stable Diffusion pré-entraînés.
Q3 : Quels modèles de base sont pris en charge ?
Principalement basé sur la famille de modèles Stable Diffusion (tels que SD 1.5, SDXL), avec extension des fonctionnalités grâce au module GRCA.
Q4 : Combien de temps faut-il pour générer une histoire de 100 images ?
Le temps exact dépend de la configuration matérielle et du nombre d'itérations. En raison du mécanisme d'optimisation itérative, le temps total = temps de génération d'une image × nombre d'images × nombre d'itérations. L'utilisation d'un GPU A100 peut accélérer considérablement le processus.
Q5 : Comment garantir la cohérence des personnages ?
Grâce au mécanisme de référence globale du module GRCA, les informations de toutes les images déjà générées sont agrégées à chaque itération, garantissant que l'apparence des personnages, les vêtements et les éléments de scène restent cohérents tout au long de l'histoire.
📚 Ressources connexes
Page du projet : https://jwmao1.github.io/storyiter/
Adresse de l'article : https://arxiv.org/abs/2410.06244
Dépôt GitHub : https://github.com/UCSC-VLAA/story-iter
Institution affiliée : UCSC-VLAA (Vision-Language and Artificial Intelligence Lab de l'Université de Californie à Santa Cruz)














