
 Assistant scénario▸
 Apps AI
 Actualités AI

StableAvatar : outil pour générer directement des vidéos de chant ou de parole à partir de l'audio
StableAvatar : outil pour générer directement des vidéos de chant ou de parole à partir de l'audioIntroduction
Qu'est-ce que StableAvatar ?
StableAvatar est un outil développé par des chercheurs de l'Université de Fudan, de Microsoft Research Asia et de l'Université Jiaotong de Xi'an, capable de générer directement des vidéos de chant ou de parole à partir de l'audio, sans limite de durée et avec une qualité d'image élevée.
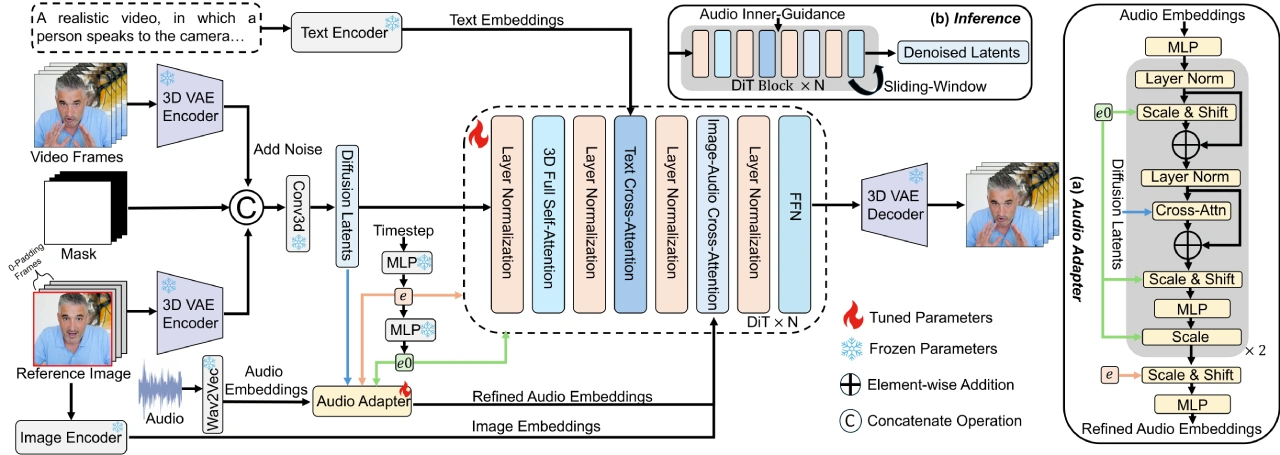
Technologie de base de StableAvatar
Adaptateur audio sensible au pas de temps : cette technologie vise principalement à éviter que les informations audio ne soient erronées lors du processus de conversion. Elle applique un « mécanisme d'attention croisée » (en termes simples, elle fait mieux correspondre les deux) entre les informations audio initiales et les informations initiales de l'image, puis utilise des « plongements de pas de temps » pour ajuster (un peu comme un réglage fin des informations à différents instants), afin d'obtenir des informations audio plus précises et d'éviter que l'image et l'audio ne soient désynchronisés ou que l'image ne soit déformée lors de la génération ultérieure de la vidéo.
Mécanisme de guidage natif audio : lors de la dernière étape de génération de la vidéo (c'est-à-dire la phase d'inférence), il utilise l'audio et les informations d'image prédits par le modèle lui-même, en traitant ces informations dynamiques comme des « signaux de guidage » pour renforcer la synchronisation entre la vidéo générée et l'audio, évitant ainsi tout décalage entre le son et le mouvement des lèvres.
Stratégie de débruitage par fenêtre glissante à pondération dynamique : lors de la génération de longues vidéos, l'image a tendance à saccader ou à être incohérente. Cette technologie fusionne les informations latentes de l'image (que l'on peut comprendre comme les caractéristiques cachées de l'image) sur la dimension temporelle, rendant la transition entre chaque image plus fluide et évitant les sauts ou déformations soudaines.
Fonctionnement de StableAvatar
Traitement de l'audio : d'abord, l'audio en entrée est passé dans le modèle Wav2Vec pour extraire les caractéristiques audio (c'est-à-dire les audio embeddings), puis ces caractéristiques sont optimisées à l'aide du « adaptateur audio » mentionné précédemment, afin de rendre les informations audio plus précises.
Traitement de l'image de référence (par exemple la photo initiale du personnage) : l'image de référence est introduite dans le modèle de génération vidéo via deux chemins :
Premier chemin : l'image de référence et les frames remplies de zéros (équivalentes à des frames vides) sont concaténées selon l'axe temporel, puis converties en codage latent (semblable à des informations cachées de l'image) via un encodeur 3D VAE figé. Ce codage latent est concaténé avec les frames vidéo compressées ainsi qu'un masque binaire (servant à indiquer les zones nécessitant un traitement重点) le long de l'axe des canaux, fournissant ainsi une base pour la génération ultérieure de l'image.
Second chemin : l'image de référence est convertie en image embeddings (caractéristiques de l'image) via un encodeur CLIP (un modèle capable d'extraire les caractéristiques clés d'une image), puis ces caractéristiques sont injectées dans chaque « module d'attention croisée image-audio » du module de débruitage (DiT), dans le but de garantir que l'apparence du personnage dans la vidéo générée reste cohérente avec celle de l'image de référence.
Génération de la vidéo : lors de la phase d'inférence, les frames vidéo réelles qui devraient normalement être fournies en entrée sont remplacées par un bruit aléatoire (c'est une pratique courante pour ce type de modèle), tandis que les autres entrées (comme les caractéristiques audio optimisées et les informations de l'image de référence traitées) restent inchangées. Le modèle calcule ensuite et génère des frames vidéo continues qui forment une vidéo complète.
Avantages de StableAvatar
Capable de générer des vidéos très longues : les outils précédents ne pouvaient générer que de courtes vidéos de moins de 15 secondes, alors que StableAvatar peut générer des vidéos de n'importe quelle durée, tout en conservant une qualité d'image élevée (haute fidélité).
Apparence du personnage inchangée : même pour de très longues vidéos, le visage et les mouvements corporels du personnage restent cohérents, sans déformation du visage, proportions corporelles étranges ou incohérences d'apparence entre le début et la fin.
Aucun traitement supplémentaire nécessaire : les vidéos générées sont prêtes à l'emploi, sans avoir besoin de recourir à d'autres outils pour retoucher le visage (comme les outils courants d'échange de visage FaceFusion ou les modèles de restauration GFP-GAN, CodeFormer, etc.), ce qui fait gagner beaucoup de temps et d'efforts.
Scénarios d'application de StableAvatar
1. Cinéma et production vidéo
Scènes d'action à haut risque : plus besoin d'exposer les acteurs à des cascades dangereuses (comme sauter d'un immeuble, scènes d'explosion) ; générer la vidéo avec cet outil réduit les coûts et les risques.
Animation de personnages : ajouter des mouvements et des expressions réalistes aux personnages d'un film ou d'une vidéo pour les rendre plus vivants.
Restauration de vieux films : restaurer et rendre plus nets les personnages de vieux films, redonnant vie à des rôles emblématiques.
2. Développement de jeux vidéo
Animation de personnages : les mouvements et expressions des personnages de jeu deviennent plus réalistes, renforçant l'immersion du joueur.
Cinématiques : les vidéos de transition de l'histoire du jeu deviennent plus spectaculaires, incitant les joueurs à continuer l'aventure.
Interactions avec des personnages virtuels : les mouvements et expressions des PNJ (personnages non jouables) sont plus naturels, rendant l'univers du jeu plus crédible.
3. Réalité virtuelle (VR) et réalité augmentée (AR)
Création de personnages virtuels : générer des personnages réalistes dans des applications VR/AR, donnant aux utilisateurs l'impression d'interagir avec de vraies personnes.
Socialisation en VR : les utilisateurs peuvent discuter et interagir avec les personnages virtuels générés, rendant les échanges sociaux plus ludiques.
Tourisme en VR : permettre aux utilisateurs de « visiter » les paysages du monde entier via un casque VR, comme s'ils voyageaient réellement.
4. Réseaux sociaux et streaming en direct
Streameurs virtuels : l'apparence des streameurs virtuels générés reste constante et les animations sont plus réalistes pendant le live.
Contenu créatif : les créateurs de courtes vidéos et les artistes numériques peuvent l'utiliser pour concevoir toutes sortes d'images dynamiques originales et produire des contenus plus créatifs.
5. Éducation et service client
Assistants virtuels : dans des contextes éducatifs ou de service client, générer des enseignants ou conseillers virtuels à l'apparence stable, offrant un service plus vivant et personnalisé (par exemple un enseignant virtuel qui garde toujours la même apparence tout au long du cours).
6. Publicité et marketing digital
Publicités de qualité cinématographique : capable de générer des mouvements de personnages et des effets de caméra complexes, idéal pour les publicités, courts métrages ou animations promotionnelles, avec une qualité d'image atteignant le niveau du cinéma.













