
 Assistant scénario▸
 Apps AI
 Actualités AI

BrowserAct : un puissant outil de web scraping IA sans code
BrowserAct : un puissant outil de web scraping IA sans codeIntroduction
BrowserAct 是一款云浏览器自动化工具,支持用自然语言指令实现无编码的数据提取与任务自动化,可从任意网站采集结构化数据、监控行业内容、训练 ai 代理,具备全球住宅 IP 网络、自动验证绕过、实时数据访问等功能,适用于为大语言模型提供数据支持、市场研究及 AI 助手交互自动化等场景。
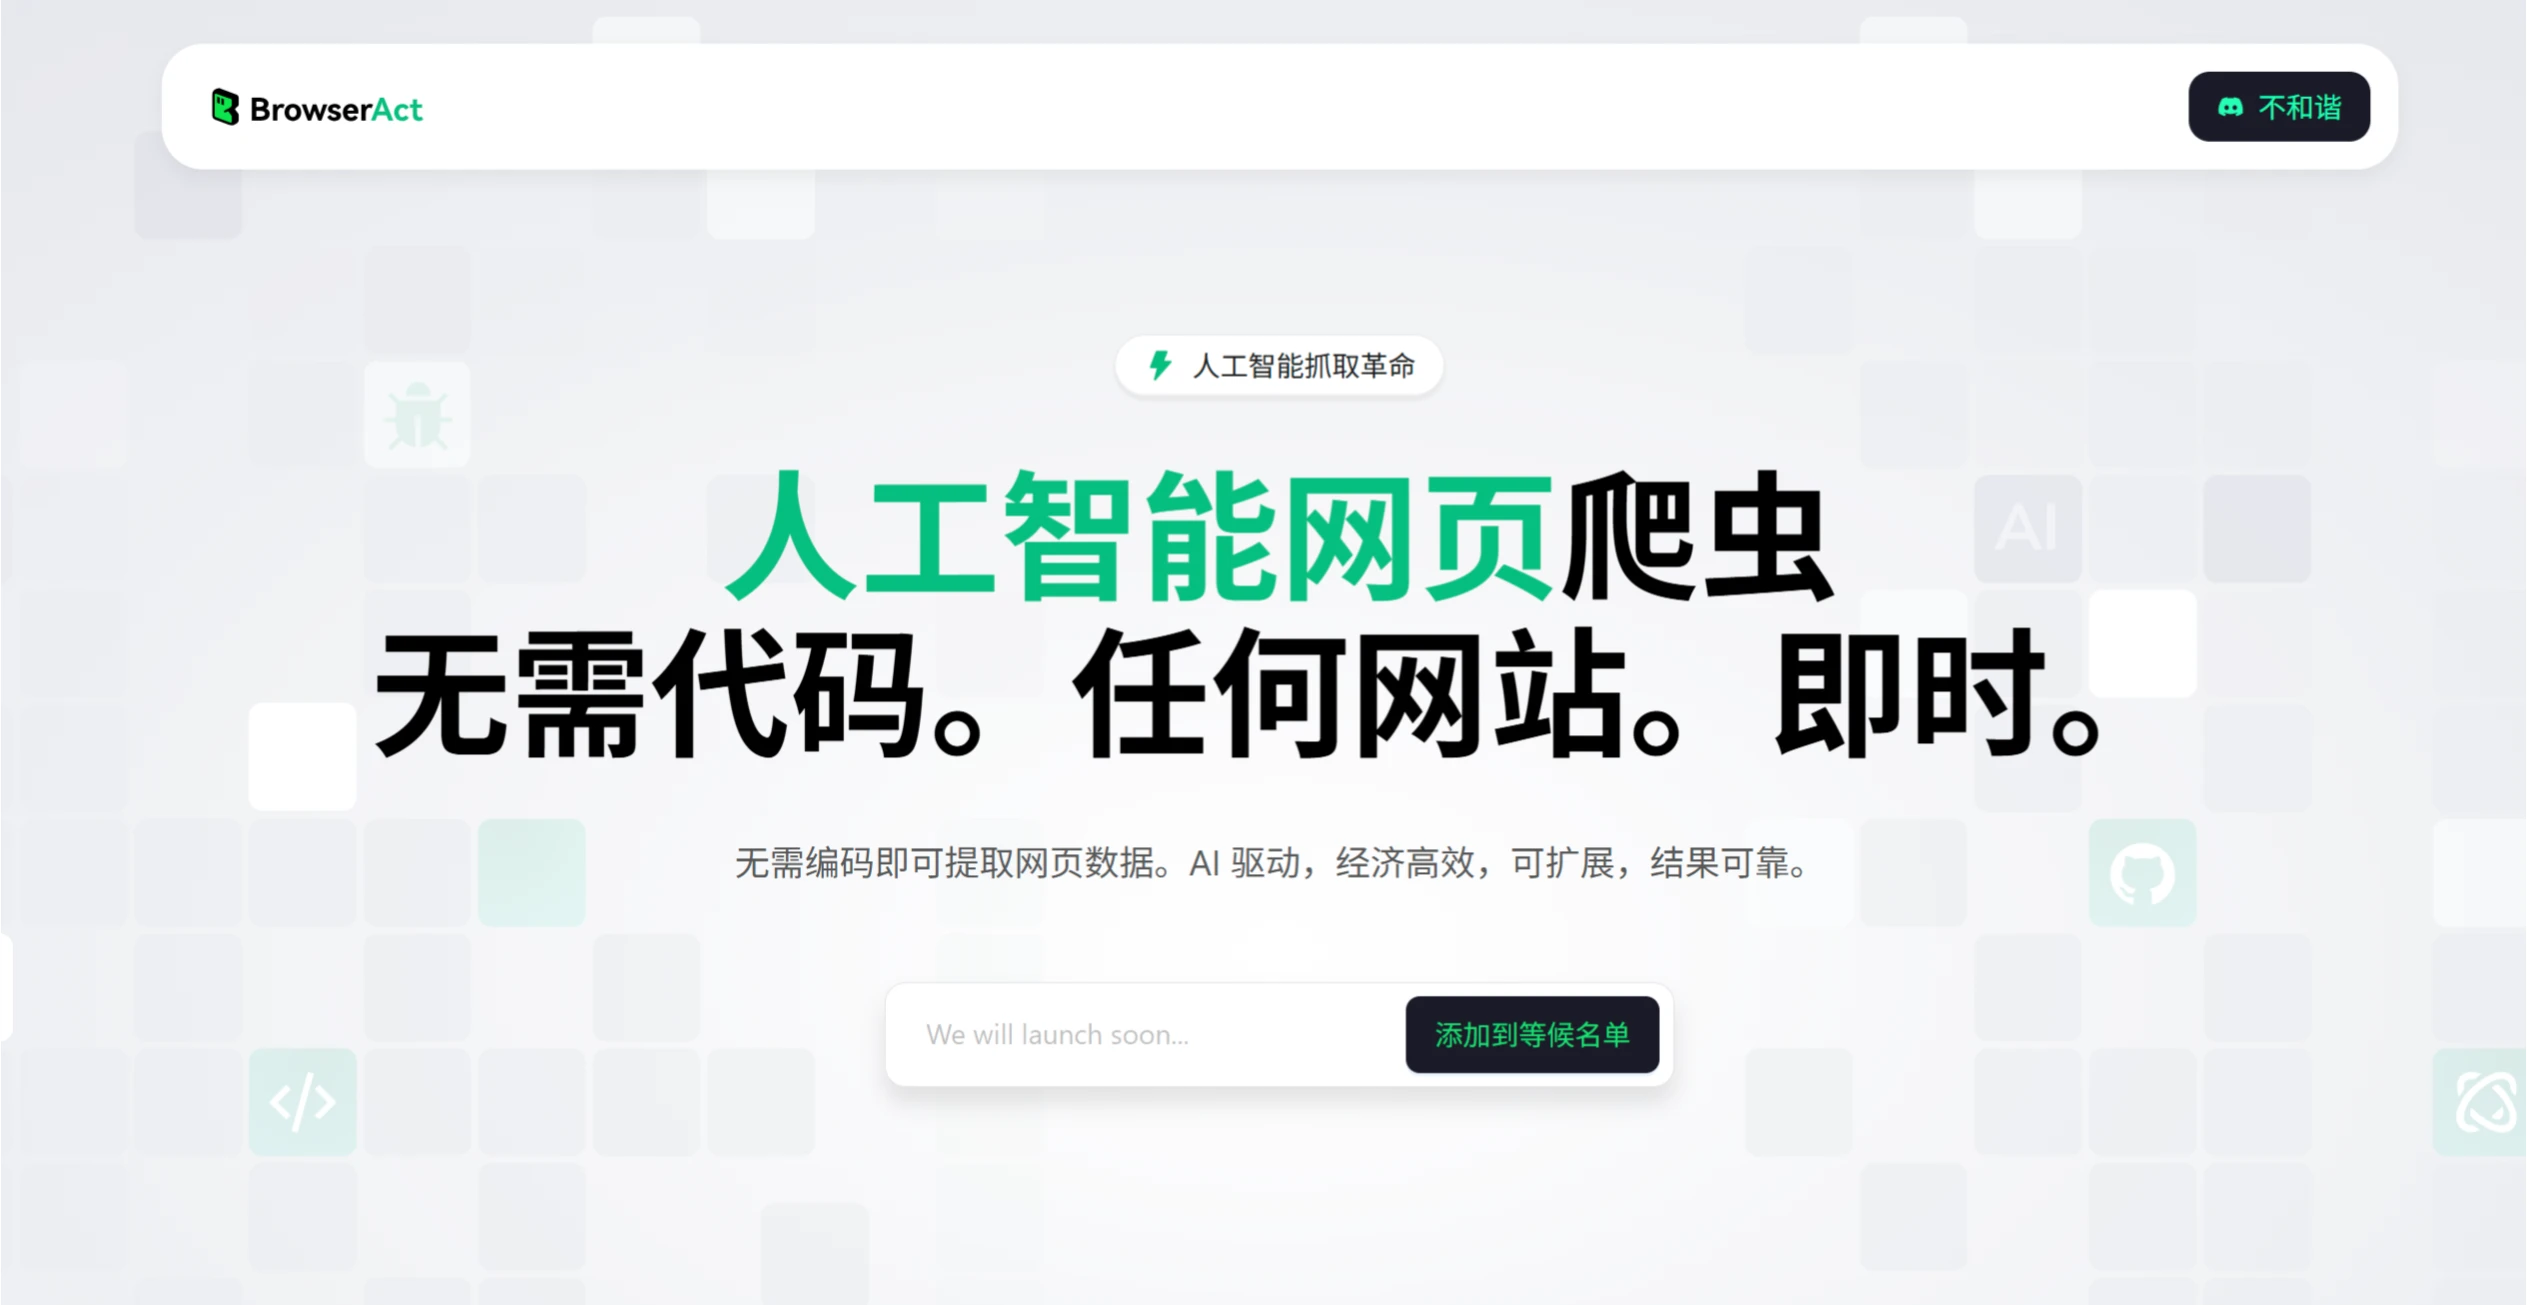
核心功能
无代码网页数据提取:不用编程知识,简单操作就能从任何网站抓取数据,适用于电商、社交媒体、新闻、论坛等多种网站。
智能优化:自动识别并提取关键数据(如价格、产品信息、文章内容等),过滤广告、导航栏、弹窗等非必要内容,提高数据纯净度。
绕过反爬机制:模拟人类浏览行为(如鼠标移动、滚动、点击),避免被检测为爬虫,自动处理验证码(CAPTCHA)、IP 封锁、行为验证等反爬措施。
实时 & 批量抓取
实时抓取:动态获取最新数据(如价格变动、库存更新)。
定时/批量抓取:支持长期数据存储,可定期更新或一次性抓取大量数据。
高成功率 & 稳定性:优化爬取策略,减少被封 IP 或封账号的风险,支持代理 IP 轮换,提高抓取效率和隐蔽性。
适用场景
电商监控:竞品价格、库存、评论抓取
市场调研:行业数据、用户评论分析
新闻 & 社交媒体监测:舆情分析、热点追踪
学术研究:论文、公开数据收集
自动化数据采集:替代手动复制粘贴
优势总结
无需编程:拖拽式操作,适合非技术人员。
智能优化:自动过滤干扰,提高数据质量。
绕过反爬:模拟真人操作,降低封禁风险。
灵活抓取:支持实时 & 批量数据获取。
高性价比:比传统爬虫工具更易用、更稳定。
常见问题
Q:非技术人员能否使用 BrowserAct?
A:完全可以。工具主打无编码、自然语言交互,用户只需通过简单指令或工作流配置即可完成数据提取,适合市场人员、研究人员、中小企业等非技术背景用户。
Q:如何应对网站的反爬策略?
A:可以通过三重机制保障:① 全球住宅 IP 池模拟真实用户访问,降低被识别为爬虫的风险;② 自动化验证绕过技术(如验证码识别);③ AI 驱动的智能路由,动态调整抓取策略。
Q:BrowserAct 如何与大语言模型(如 GPT)结合使用?
A:可以通过数据提取结果直接输入模型 ,或为模型提供实时网页浏览能力(如调用 BrowserAct 接口获取指定网页信息),帮助模型突破训练数据时效性限制,实现动态信息交互。















