Assistant scénario▸
 Apps AI
 Actualités AI

Scrapeless_云技派,专注ai人工智能!
Scrapeless_云技派,专注ai人工智能!Introduction
Qu'est-ce que Scrapeless ?
Scrapeless est un outil de web scraping piloté par l'IA qui permet d'extraire efficacement des données structurées à partir de sites web. Il prend en charge le mode navigateur headless, contourne automatiquement les CAPTCHA et les blocages d'IP, et offre un service de proxy de haute qualité couvrant plus de 195 pays dans le monde. Son API de scraping est simple et facile à utiliser, adaptée à la collecte de données à grande échelle par les entreprises et les développeurs. Les fonctionnalités de nettoyage et de transformation des données garantissent que les données sont exactes et exploitables. Scrapeless propose un essai gratuit pour faciliter la collecte efficace de données.
Outils principaux de Scrapeless
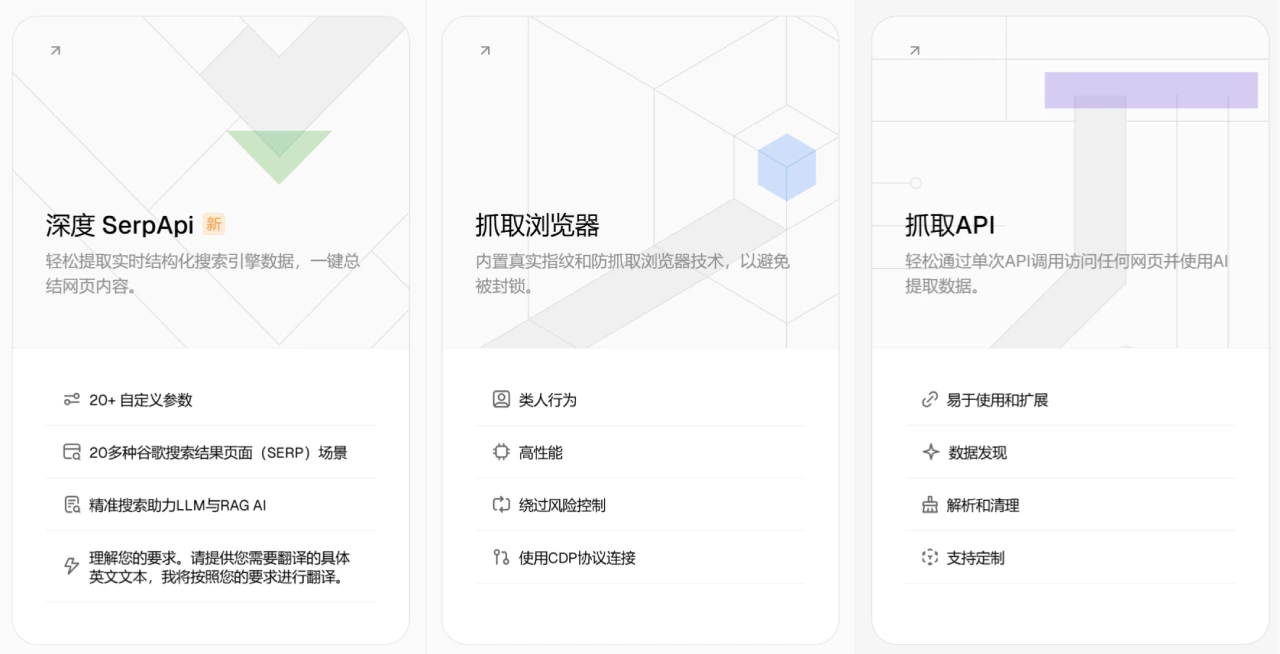
API de scraping : obtenez des données structurées à partir de n'importe quel site web via un seul appel d'API, adapté à l'extraction de données à grande échelle.
Navigateur de scraping : piloté par l'IA, prend en charge le mode navigateur headless, peut simuler le comportement d'un utilisateur réel et capturer facilement du contenu dynamique.
Web Unlocker : contourne automatiquement les CAPTCHA, les blocages d'IP et les restrictions de contenu dynamique, garantissant une collecte de données ininterrompue.
Service de proxy : fournit des proxys de haute qualité et rotatifs, couvrant plus de 195 pays dans le monde, afin d'éviter le blocage des IP.
Résolveur de CAPTCHA : résout automatiquement divers CAPTCHA, tels que reCAPTCHA et Cloudflare, garantissant un processus de scraping fluide.
Avantages de Scrapeless
Extraction de données efficace : extraction rapide et précise de données à partir de sites web complexes, prenant en charge une concurrence élevée et des performances élevées.
Personnalisation flexible : propose des solutions personnalisées en fonction des besoins de l'entreprise, pour répondre à différents scénarios métier.
Nettoyage et transformation des données : améliore l'exactitude et la disponibilité des données, transformant les données brutes en informations précieuses.
Sécurité et confidentialité : adopte des mesures de sécurité avancées, respecte strictement les normes de conformité et protège les données des utilisateurs.
Rentabilité : facturation uniquement pour les requêtes réussies, avec des formules tarifaires flexibles.
Cas d'utilisation de Scrapeless
Scraping de données à l'échelle de l'entreprise : fournit des solutions de web scraping de haute qualité et personnalisées pour des projets métiers critiques.
Push de données en temps réel : grâce à une intégration API puissante, garantit que les applications restent synchronisées avec les informations les plus récentes.
Workflows automatisés : simplifie le processus de collecte de données, réduit l'intervention manuelle et améliore l'efficacité du travail.
Public concerné par Scrapeless
Entreprises : entreprises ayant besoin d'une collecte de données efficace à grande échelle.
Développeurs : développeurs souhaitant obtenir rapidement et facilement des données depuis le web.
Analystes de données : professionnels ayant besoin d'outils d'extraction de données fiables et performants.
Tutoriel d'utilisation de Scrapeless
1. Créer un compte : rendez-vous sur le site officiel de Scrapeless pour vous inscrire et obtenir un compte d'essai gratuit, sans carte de crédit requise pendant la période d'essai.
2. Obtenir la clé API : après l'inscription et la connexion, récupérez la clé API dans le tableau de bord pour authentifier les requêtes.
3. Choisir un outil : sélectionnez selon vos besoins le navigateur de scraping, l'API de scraping, le Web Unlocker, le résolveur de CAPTCHA ou les proxys.
4. Installer le SDK : installez le SDK Scrapeless adapté à votre langage de programmation, tel que Python, Node.js, etc.
5. Envoyer des requêtes : utilisez la clé API pour envoyer des requêtes ; une requête de base doit inclure l'URL cible et les identifiants d'authentification. Par exemple, le code Python suivant permet d'appeler l'API de scraping :
import requests
import json
API_KEY = "your_api_key"
host = "api.scrapeless.com"
url = f"https://{host}/api/v1/unlocker/request"
payload = json.dumps({
   "actor": "unlocker.webunlocker",
   "input": {
      "url": "https://httpbin.io/get",
      "redirect": False,
      "method": "GET",
   },
   "proxy":{
       "country": "ANY",
   }
})
headers = {
   'Content-Type': 'application/json',
   'x-api-token': f'{API_KEY}'
}
response = requests.request("POST", url, headers=headers, data=payload)
print(response.text)
6. Traiter la réponse : les données de scraping renvoyées au format JSON sont nettoyées et structurées, prêtes à l'emploi.
7. Augmenter l'échelle du scraping : augmentez le nombre de requêtes simultanées et le volume de scraping selon vos besoins ; Scrapeless gère automatiquement les mesures anti-bots.
8. Surveiller l'utilisation : suivez via le tableau de bord l'utilisation de l'API, le taux de réussite et le crédit restant.
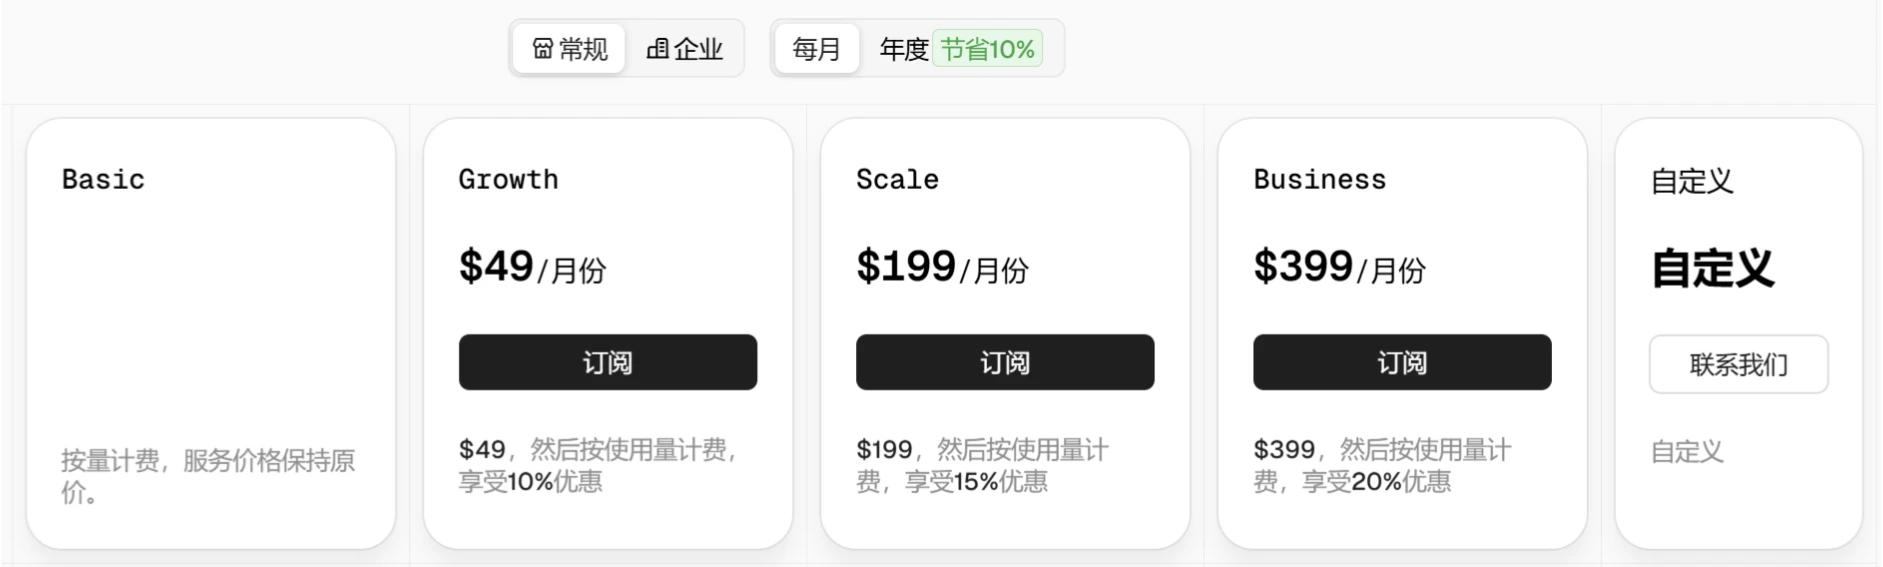
Tarifs de Scrapeless