
 Assistant scénario▸
 Apps AI
 Actualités AI
Spark-TTS : système TTS efficace avec clonage vocal zero-shot et synthèse multilingue
Spark-TTS : système TTS efficace avec clonage vocal zero-shot et synthèse multilingueIntroduction
Qu'est-ce que Spark-TTS ?
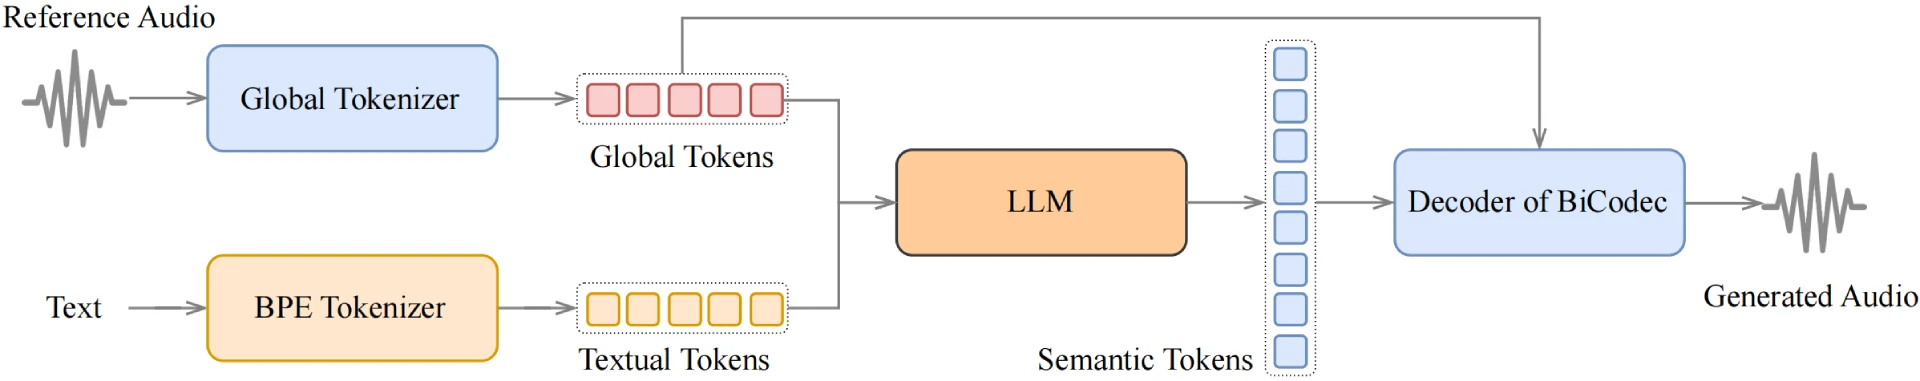
Spark-TTS est un système de synthèse vocale (TTS) développé par l'équipe SparkAudio, construit sur Qwen2.5. Il contrôle directement la hauteur, la vitesse et le style du locuteur à partir du texte, prend en charge le clonage vocal zero-shot, la synthèse multilingue, le contrôle vocal fin ainsi que la génération vocale via une interface Web, permettant de convertir rapidement du texte en contenu vocal naturel et de haute qualité. Contrairement aux systèmes TTS traditionnels, il reconstruit l'audio directement à partir des encodages prédits par le LLM, simplifiant ainsi le processus de génération vocale et améliorant l'efficacité.
Fonctionnalités principales de Spark-TTS
Clonage vocal zero-shot : Spark-TTS prend en charge le clonage vocal zero-shot, ce qui permet de reproduire la voix d'un locuteur même sans données d'entraînement spécifiques à ce locuteur. Dans des scénarios multilingues et de code-switching, il excelle dans la transition fluide entre différentes langues et locuteurs.
Prise en charge multilingue : le système prend en charge le chinois et l'anglais, et maintient un haut degré de naturel et de précision lors de la synthèse interlangues. L'utilisateur saisit du texte dans une langue et obtient une sortie vocale dans une autre langue.
Contrôle vocal fin : les utilisateurs peuvent personnaliser la voix d'un locuteur virtuel en ajustant des paramètres tels que le genre, la hauteur et la vitesse d'élocution, répondant ainsi aux besoins de contenus vocaux variés pour des scénarios tels que les présentateurs virtuels et les livres audio.
Synthèse vocale efficace : Spark-TTS est entièrement basé sur l'architecture Qwen2.5, sans nécessiter de modèle génératif supplémentaire. Il reconstruit l'audio directement à partir des encodages prédits par le LLM, simplifiant ainsi le processus et réduisant la complexité.
Création de locuteurs virtuels : les utilisateurs peuvent créer leurs propres locuteurs virtuels et leur conférer un style vocal unique en ajustant les paramètres.
Architecture technique de Spark-TTS
La base technique de Spark-TTS est le codec vocal à flux unique BiCodec, qui décompose la parole en jetons sémantiques à faible débit binaire (responsables du contenu linguistique) et en jetons globaux de longueur fixe (responsables des attributs du locuteur). Cette séparation facilite l'ajustement flexible des caractéristiques vocales. Combinée à la technique de chaîne de pensée (Chain-of-Thought) de Qwen2.5, elle améliore encore la qualité et la contrôlabilité de la génération vocale.
Scénarios d'application de Spark-TTS
Production de livres audio : la qualité naturelle de sa voix le rend particulièrement adapté aux livres audio.
Présentateurs virtuels : en ajustant les paramètres vocaux, il génère des locuteurs virtuels répondant à des besoins spécifiques.
Synthèse vocale interlangues : prise en charge de plusieurs langues, ce qui élargit son applicabilité à l'échelle mondiale.
Installation et utilisation de Spark-TTS
1. Préparation de l'environnement
Installer Python : assurez-vous que Python 3.12 est installé.
Installer Conda : utilisé pour gérer les environnements virtuels, peut être téléchargé et installé depuis le site officiel de Miniconda.
2. Cloner le dépôt
git clone https://github.com/SparkAudio/Spark-TTS.git
cd Spark-TTS
3. Installer les dépendances
conda create -n sparktts -y python=3.12
conda activate sparktts
pip install -r requirements.txt
Si vous êtes en Chine continentale, vous pouvez utiliser le miroir d'Aliyun :
pip install -r requirements.txt -i https://mirrors.aliyun.com/pypi/simple/ --trusted-host=mirrors.aliyun.com
4. Télécharger le modèle pré-entraîné
Téléchargez le modèle pré-entraîné à l'aide de la commande suivante :
from huggingface_hub import snapshot_download
snapshot_download("SparkAudio/Spark-TTS-0.5B", local_dir="pretrained_models/Spark-TTS-0.5B")
5. Utilisation de base
Exécutez la commande suivante pour effectuer la synthèse vocale :
python -m cli.inference \
    --text "text to synthesis." \
    --device 0 \
    --save_dir "path/to/save/audio" \
    --model_dir pretrained_models/Spark-TTS-0.5B \
    --prompt_text "transcript of the prompt audio" \
    --prompt_speech_path "path/to/prompt_audio"
6. Utilisation de l'interface Web UI
python webui.py --device 0
Dépôt GitHub :https://github.com/SparkAudio/Spark-TTS
Bibliothèque de modèles HuggingFace : https://huggingface.co/spaces/Mobvoi/Offical-Spark-TTS
Article : https://arxiv.org/pdf/2503.01710
Démonstration : https://sparkaudio.github.io/spark-tts/
Actualités liées :
llasa 3B TTS : un modèle de synthèse vocale (TTS) basé sur l'architecture LLaMA














