Assistant scénario▸
 Apps AI
 Actualités AI

混元hunyuan-TurboS : le modèle de réflexion rapide lancé par Tencent offrant une réponse instantanée
混元hunyuan-TurboS : le modèle de réflexion rapide lancé par Tencent offrant une réponse instantanéeIntroduction
Qu'est-ce que Hunyuan-TurboS ?
Hunyuan-TurboS est le nouveau modèle de réflexion rapide lancé par Tencent. Contrairement aux modèles à réflexion lente comme Deepseek R1 ou Hunyuan T1, qui nécessitent de « réfléchir avant de répondre », Hunyuan-TurboS permet de répondre en une seconde, doublant la vitesse de réponse par rapport à la génération précédente et réduisant de 44 % la latence du premier caractère. Côté prix, le modèle optimisé permet une génération de contenu fluide et instantanée, et convient à de nombreux domaines d'application tels que la connaissance, les mathématiques et la création. Tencent prévoit de lancer progressivement des intégrations produits correspondantes, comme le « Tencent Yuanbao » dont le déploiement en gray launch est imminent.
Fonctionnalités et caractéristiques de Hunyuan-TurboS
Réponse rapide : sa capacité à répondre en une seconde offre une meilleure expérience utilisateur. Par rapport à la génération précédente, la vitesse de génération de texte est doublée et la latence du premier caractère est réduite de 44 %, pour une interaction à la fois rapide et fluide.
Sortie de haute qualité : malgré sa rapidité de réponse, la qualité du contenu produit reste élevée ; lors de la génération rapide de texte, les informations sont précises et la logique claire.
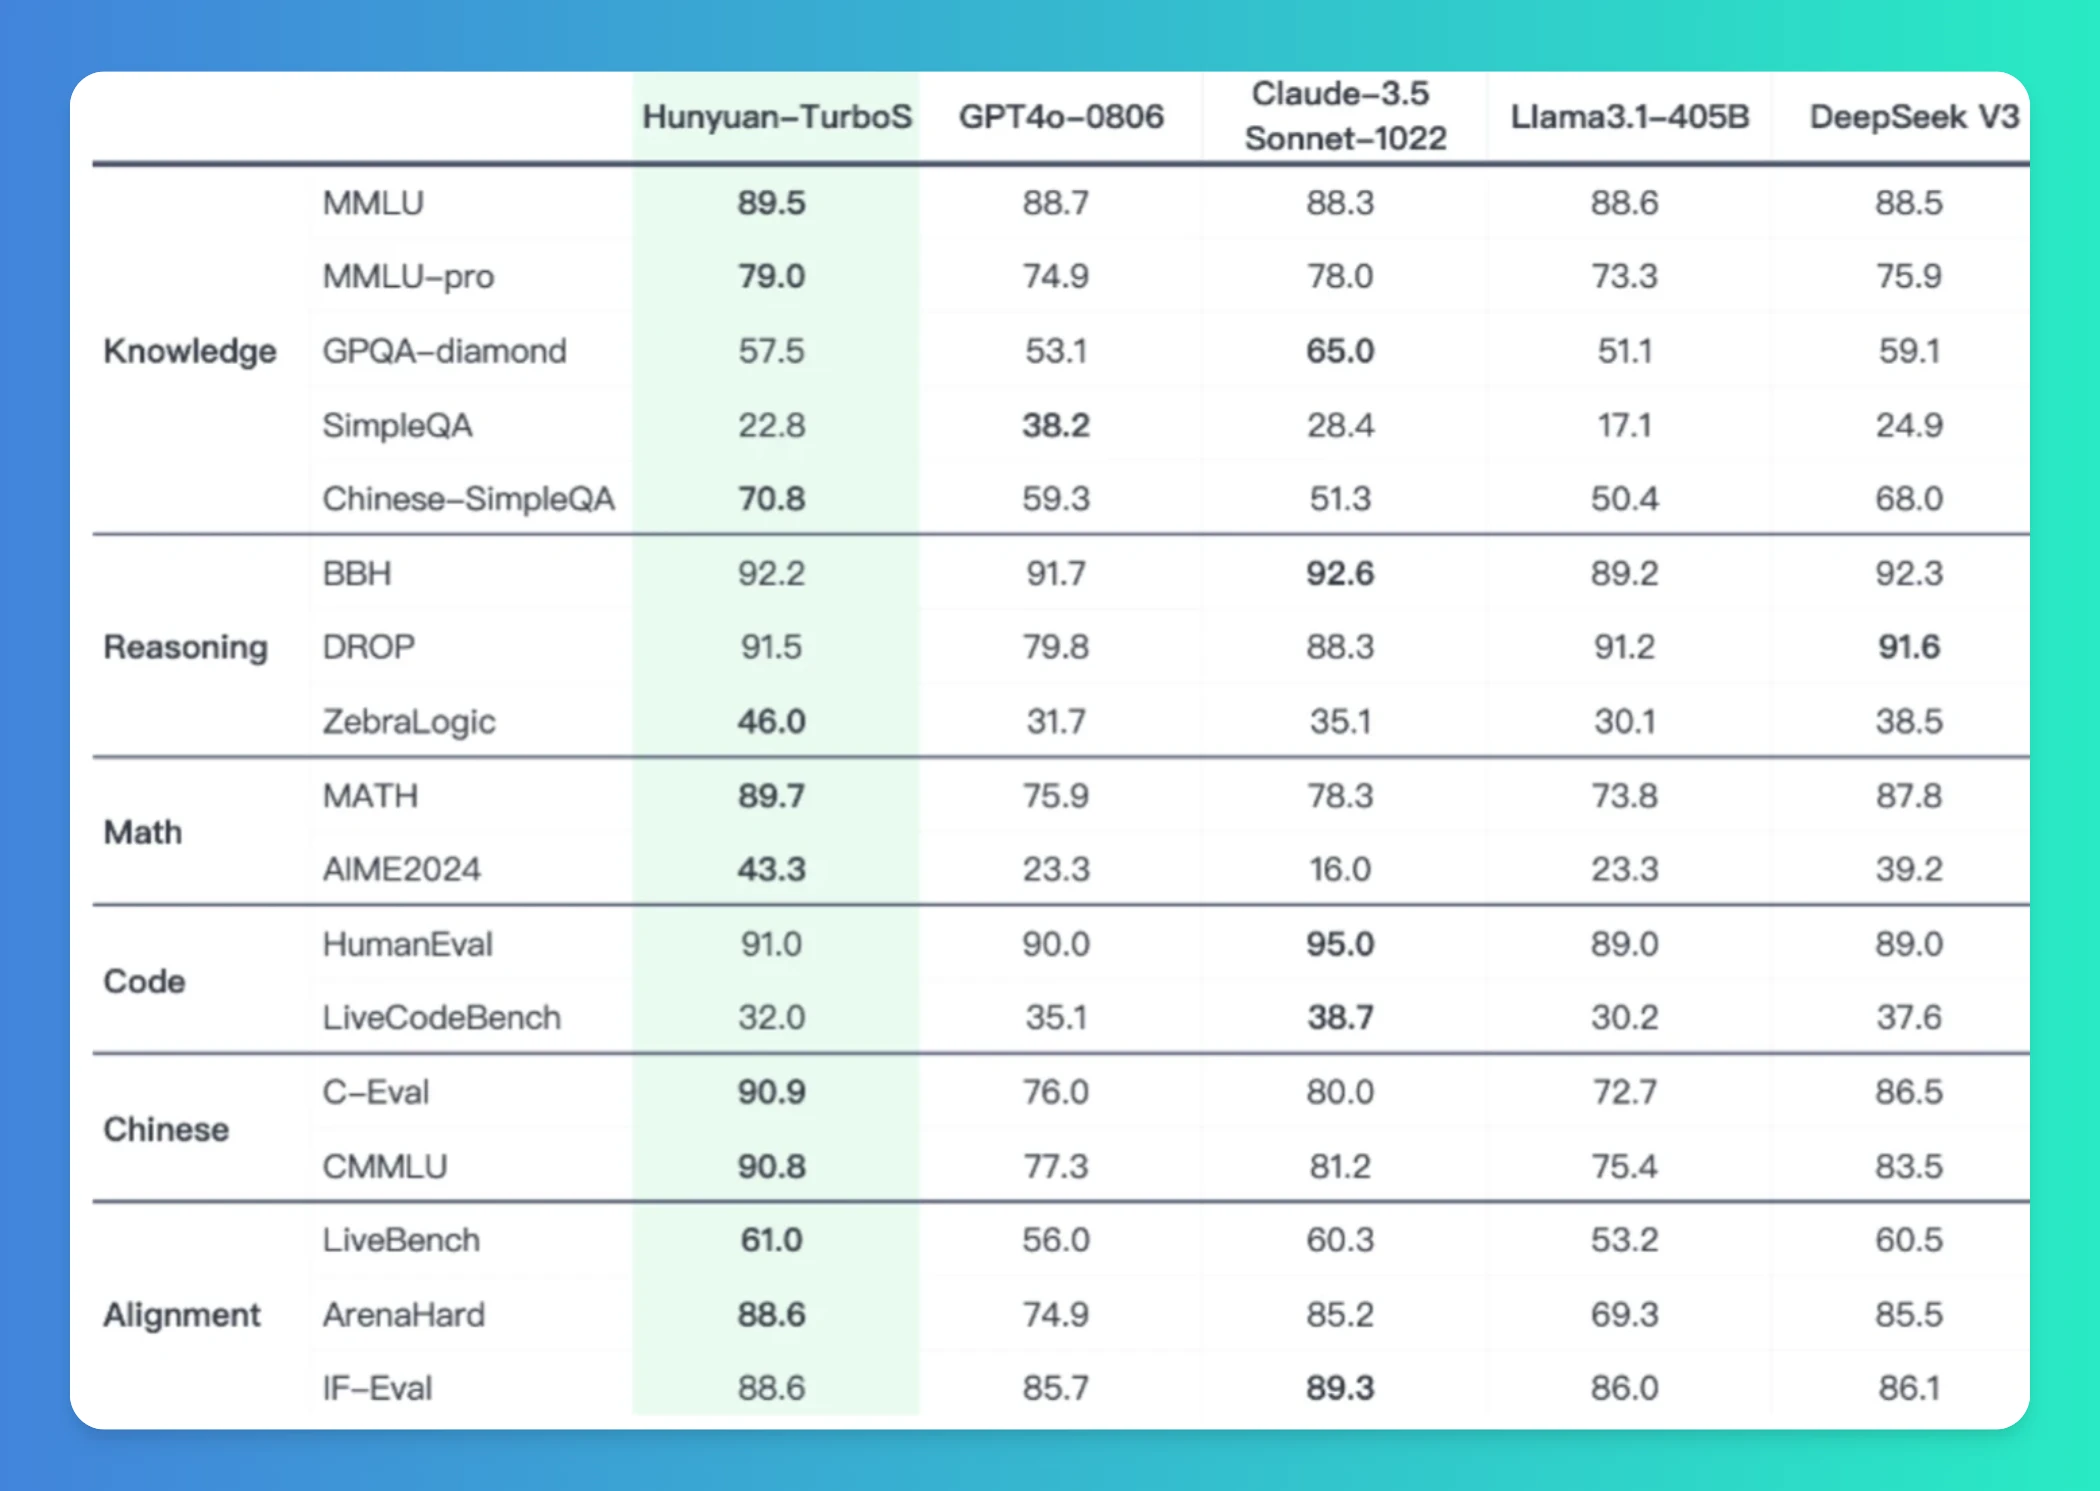
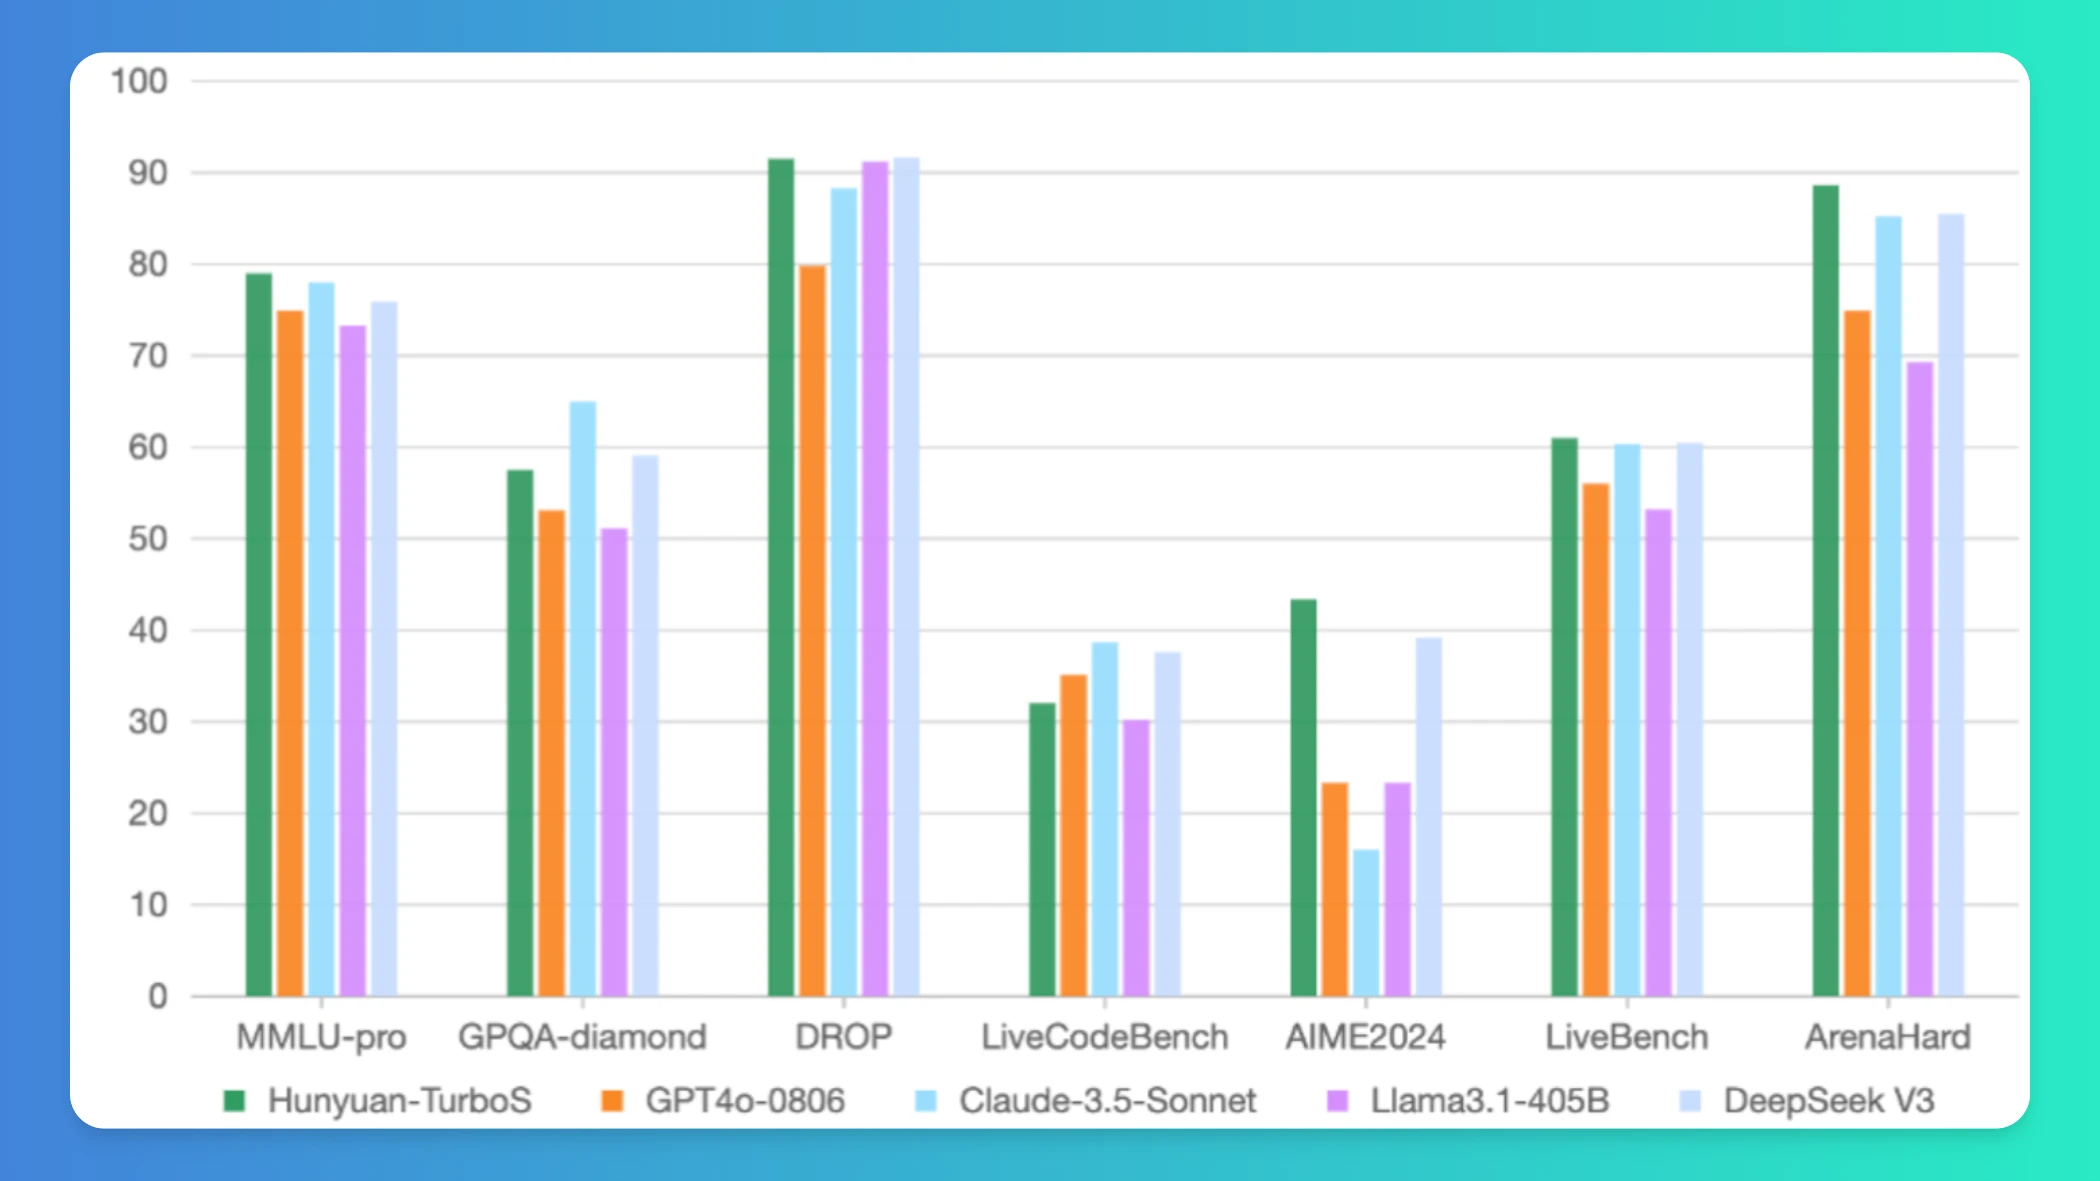
Performances dans de nombreux domaines : il excelle dans les questions-réponses de connaissance, le raisonnement mathématique, la génération de code de programmation, etc. Comparé à des modèles de pointe comme DeepSeek V3 ou GPT-4o, il n'a rien à leur envier et les surpasse même dans certains aspects.
Avantages architecturaux : l'architecture Hybrid-Mamba-Transformer combine Mamba et Transformer, optimisant l'efficacité de calcul et l'occupation mémoire, réduisant les coûts d'entraînement et d'inférence, et offrant une meilleure capacité à traiter les longs textes et les relations contextuelles complexes.
Applications multiples : il s'utilise dans de nombreux scénarios comme la conversation quotidienne, la création de contenu, la recherche d'informations, le soutien scolaire et l'aide à la programmation, et sert différents utilisateurs via l'API Tencent Cloud et l'application Tencent Yuanbao.
Construction d'un écosystème : en tant que cœur de la série Hunyuan, il prend en charge le développement de modèles dérivés, comme le modèle T1 combinant la réflexion approfondie, offrant aux utilisateurs une solution complète de capacités IA.
Innovations architecturales : il adopte l'architecture Hybrid-Mamba-Transformer, qui intègre les avantages technologiques, réduit la complexité de calcul des modèles Transformer traditionnels, diminue l'occupation du KV-Cache, améliore l'efficacité de calcul et abaisse les coûts de déploiement.
Tarification avantageuse : la tarification de Turbo S est compétitive, avec 0,8 yuan par million de tokens en entrée et 2 yuans par million de tokens en sortie, soit plusieurs fois moins cher que le modèle Hunyuan Turbo précédent.
Raisonnement plus intelligent : Hunyuan Turbo S est performant dans les domaines des mathématiques et du raisonnement logique ; la réflexion rapide permet un jugement précis en peu de temps, et combinée aux avantages des modèles à réflexion lente, elle améliore la stabilité et la précision globales du raisonnement.
Innovations technologiques de Hunyuan-TurboS
Architecture Hybrid-Mamba-Transformer : elle combine la capacité de l'architecture Mamba à traiter efficacement les longues séquences et l'avantage du Transformer à saisir des contextes complexes, pour bâtir une architecture hybride à la fois optimale en mémoire vidéo et en efficacité de calcul.
Fusion des chaînes de pensée longues et courtes : grâce à l'introduction de technologies telles que les chaînes de pensée longues, l'augmentation par la recherche et l'apprentissage par renforcement, les capacités de raisonnement scientifique sont nettement améliorées, ce qui se traduit par une hausse globale des performances du modèle.
Scénarios d'application de Hunyuan-TurboS
Scénarios sociaux : fournir un assistant intelligent instantané dans les discussions de groupe WeChat, avec une vitesse de génération de contenu pour le Moments proche de celle d'une saisie humaine.
Scénarios commerciaux : réduction du temps de réponse du service client e-commerce ; en développement de code, complétion automatique des descriptions de paramètres et des exemples de code.
Production de contenu : les créateurs de médias personnels utilisant Yuanbao constatent une réduction considérable du temps nécessaire pour passer des mots-clés du sujet à un flux de travail complet comprenant plan, suggestions d'illustrations et titres tendance.
Comment utiliser Hunyuan-TurboS ?
Appel d'API : les développeurs et les entreprises peuvent appeler Hunyuan-TurboS via l'API Tencent Cloud.
Tencent Yuanbao : les utilisateurs ordinaires peuvent sélectionner le modèle « Hunyuan » dans Tencent Yuanbao et désactiver la réflexion approfondie pour l'utiliser.