
 Assistant scénario▸
 Apps AI
 Actualités AI
Step-Audio : premier modèle d'interaction vocale open source par Stepfun
Step-Audio : premier modèle d'interaction vocale open source par StepfunIntroduction
Step-Audio, en tant que premier modèle d'interaction vocale open source de niveau produit dans l'industrie, possède la capacité de générer des expressions vocales diversifiées selon les besoins du scénario, couvrant les émotions, les dialectes, les langues, le chant et les styles personnalisés, avec une interaction naturelle et fluide. Lors de l'évaluation HSK de niveau 6, Step-Audio a obtenu d'excellents résultats et est considéré comme le modèle open source qui maîtrise le mieux le chinois. Ce modèle IA a été développé conjointement par StepFun et Geely Automobile Group, et a été officiellement publié en open source le 18 février 2025.
Caractéristiques fonctionnelles de Step-Audio :
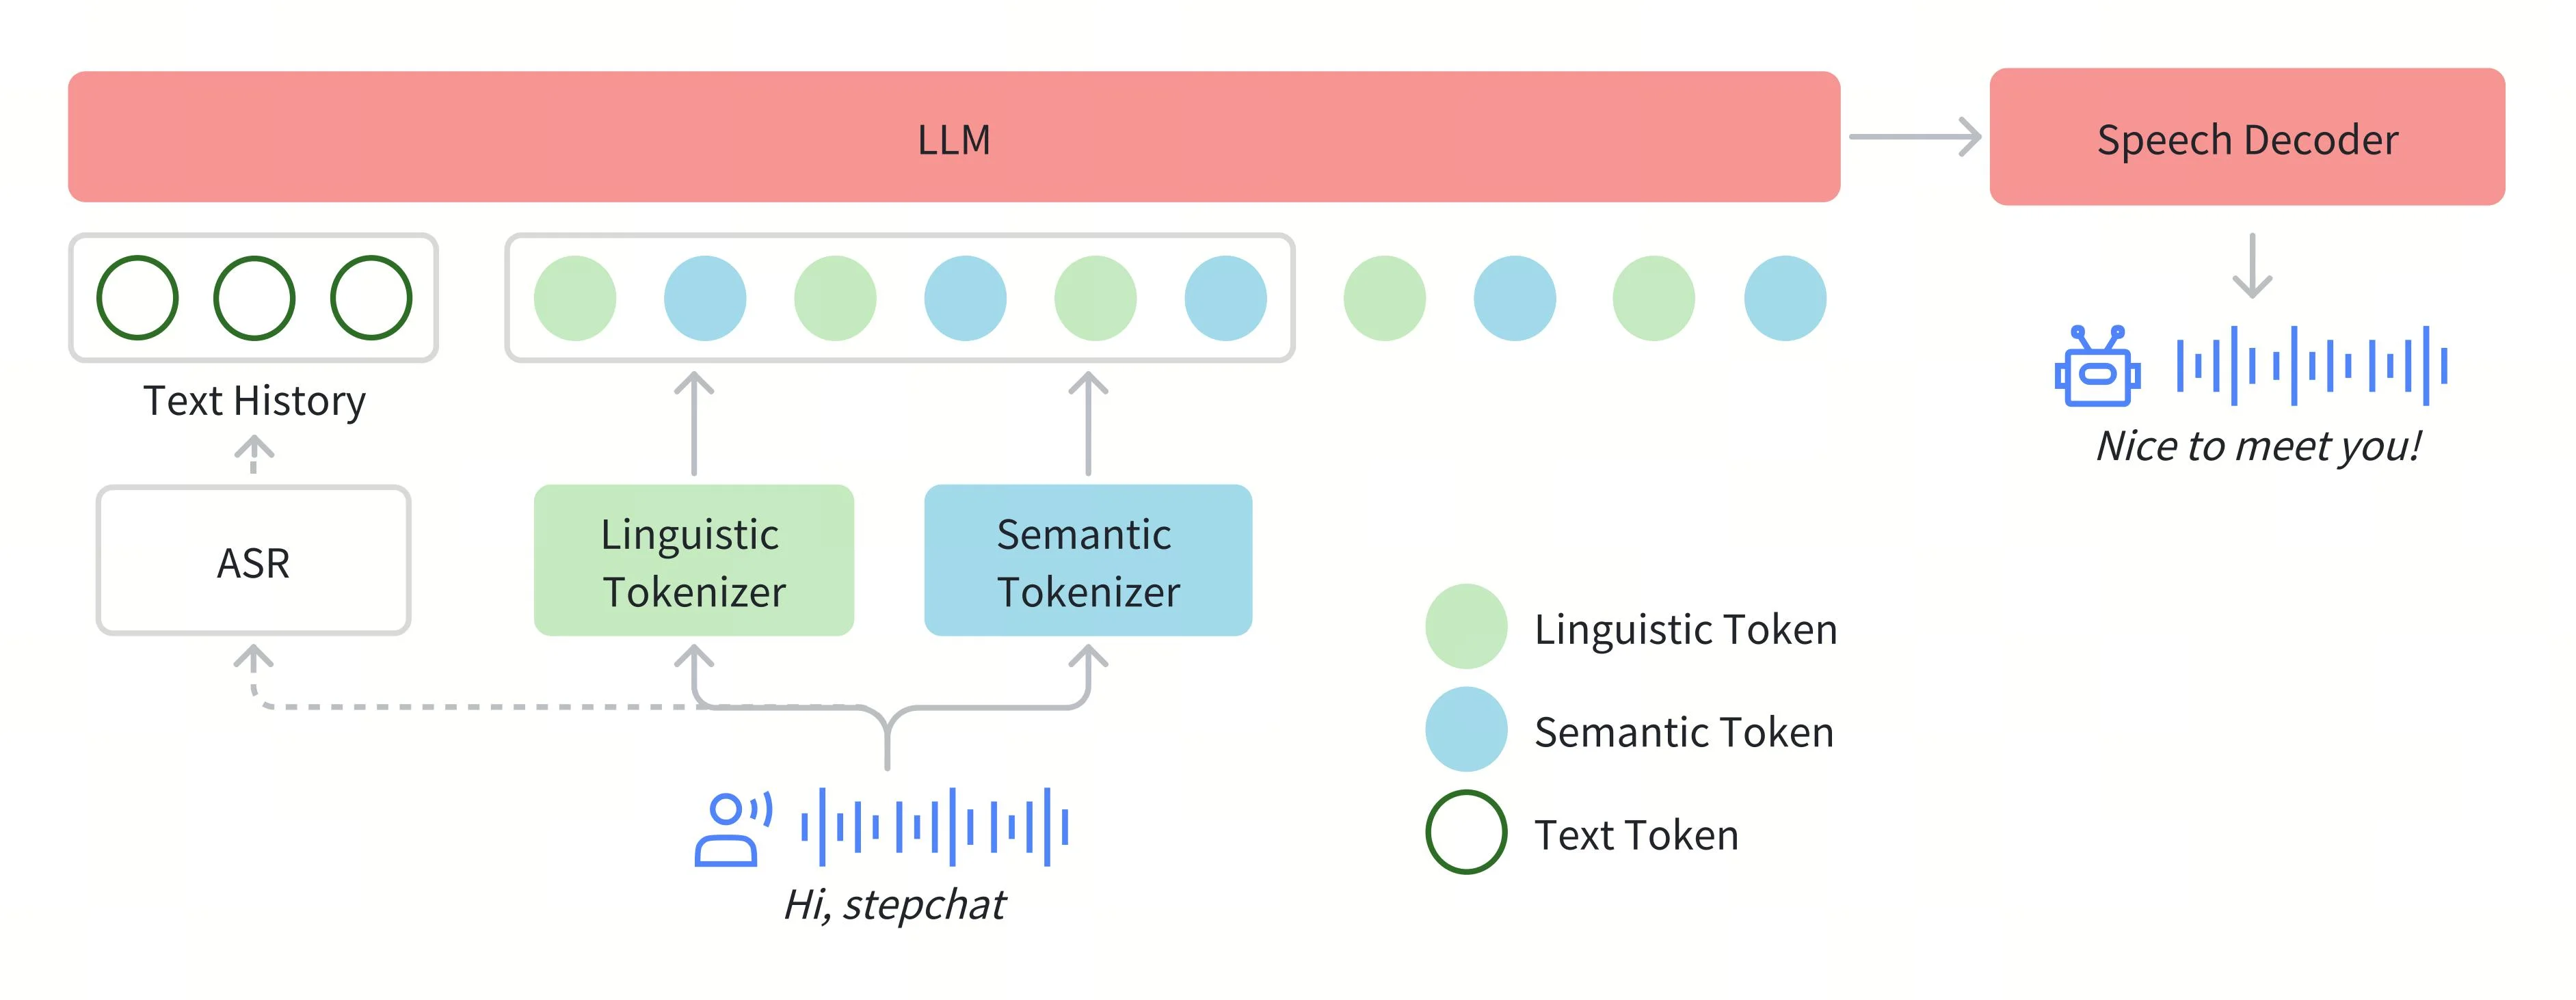
Modèle unifié : basé sur un modèle multimodal de 13 milliards de paramètres, il unifie la compréhension et la génération vocale, et peut traiter simultanément la reconnaissance vocale, la compréhension sémantique, le dialogue, le clonage vocal, l'édition audio et la synthèse.
Diversité des émotions et des styles : génère des voix dans diverses émotions (en colère / joie / tristesse), dialectes (cantonais / sichuanais, etc.), langues, chants (RAP / fredonnement) et styles personnalisés selon les besoins, avec un contrôle précis des émotions, dialectes, langues et chants.
Dialogue de haute qualité : offre une expérience de dialogue naturelle et de haute qualité, avec une interaction naturelle et fluide comme une conversation réelle.
Interaction intelligente : possède des caractéristiques d'interaction avancées telles que le raisonnement logique, la création, le contrôle des instructions, le langage, le jeu de rôle et les jeux de texte.
Scénarios d'application de Step-Audio :
Service client intelligent : fournit un service personnalisé et émotionnel pour améliorer l'expérience utilisateur.
Lecture audio : génère une lecture émotionnelle pour renforcer l'immersion dans l'écoute de livres.
Création audio-vidéo : génère automatiquement le doublage de vidéos ou le doublage de personnages d'animation.
PNJ de jeux : fournit une interaction vocale naturelle et fluide pour les personnages de jeux.
Comptes rendus de réunions : transcrit la voix en texte en temps réel et fournit un retour vocal.
Assistance éducative : assistant pédagogique personnalisé, ajustant le style et le ton de l'enseignement.
Caractéristiques techniques de Step-Audio :
Technique de haut taux de compression : adopte des techniques de compression efficaces telles que Video-VAE pour optimiser le traitement des données.
Capacité de traitement bilingue : utilise Hunyuan-CLIP et Step-LLM pour traiter les invites en chinois et en anglais.
Architecture DIT et algorithme Video-DPO : optimise le traitement des données vidéo et audio complexes.
Entraînement sur des jeux de données à grande échelle : construit de grands jeux de données pour garantir la généralisation du modèle et l'expression des détails.
Méthode d'utilisation de Step-Audio :
Obtenir le modèle : accédez à la version open source de Step-Audio sur l'APP Yuewen ou sur des plateformes telles que Hugging Face.
Rapport technique : consultez le rapport technique sur arxiv.org ou GitHub pour plus de détails.
Interface API : implémentez l'interaction vocale via des appels API, conformément au protocole open source MIT.
Développement intégré : intégrez dans votre application en suivant la documentation officielle ou les exemples de code.
Entraînement personnalisé : les utilisateurs avancés peuvent affiner le modèle pour s'adapter à des scénarios spécifiques ou améliorer les performances.
Comment obtenir Step-Audio
GitHub : https://github.com/stepfun-ai/Step-Audio
ModelScope : [Cliquez pour accéder]
Rapport technique : [Cliquez pour accéder]
Prise en charge du déploiement en un clic via PAI Model Gallery [Cliquez pour accéder]














