
 Assistant scénario▸
 Apps AI
 Actualités AI
RAGFlow : moteur RAG open source basé sur la compréhension approfondie des documents
RAGFlow : moteur RAG open source basé sur la compréhension approfondie des documentsIntroduction
RAGFlow est un moteur de génération augmentée par récupération (RAG) open source, spécialement conçu pour une compréhension approfondie des documents. Il offre aux entreprises et aux particuliers un flux de travail RAG simple et performant, combiné avec des grands modèles de langage (LLM), fournissant des réponses fiables avec des citations fondées pour divers formats de données complexes. RAGFlow est particulièrement adapté aux scénarios nécessitant une génération dynamique de contenu et s'appuyant sur des bases de connaissances externes, tels que le service client intelligent, la génération de documents et l'analyse de données, aidant les utilisateurs à exploiter efficacement les informations pertinentes dans de grands volumes de données.
Fonctionnalités principales de RAGFlow :
Intégration de grands modèles de langage : compatible avec les grands modèles tels que Zhipu et DeepSeek, et prend en charge le déploiement local via Xinference et Ollama, améliorant ainsi les capacités de问答.
Compréhension approfondie des documents : capable d'analyser des documents dans plusieurs formats tels que PDF, Word, Excel et PPT, en extrayant des informations clés comme le texte, les images et les tableaux.
Découpage guidé par des modèles : mécanisme de découpage intelligent, permettant aux utilisateurs de choisir des modèles selon leurs besoins, améliorant ainsi l'efficacité et la précision du traitement des données.
Prise en charge des citations réduisant les hallucinations : technologie de découpage visuel du texte, permettant de visualiser rapidement les références clés et les citations traçables, réduisant ainsi le risque d'hallucinations lors de l'utilisation des informations.
Compatibilité avec des sources de données multiples : prise en charge de nombreux types de données hétérogènes tels que documents, diapositives, Excel, texte, images, numérisations, données structurées et pages web.
Flux de travail automatisé et simplifié : flux RAG automatisé, configuration flexible des LLM et des modèles d'embedding, permettant le rappel des données et la refusion du reclassement.
Traitement diversifié des documents : compatible avec les formats de fichiers Word, PPT, Excel, TXT, images, PDF, pages web, ainsi qu'avec le traitement d'autres données non structurées.
Édition de flux de travail sans code : prise en charge de l'édition des tâches et des flux de travail sans code.
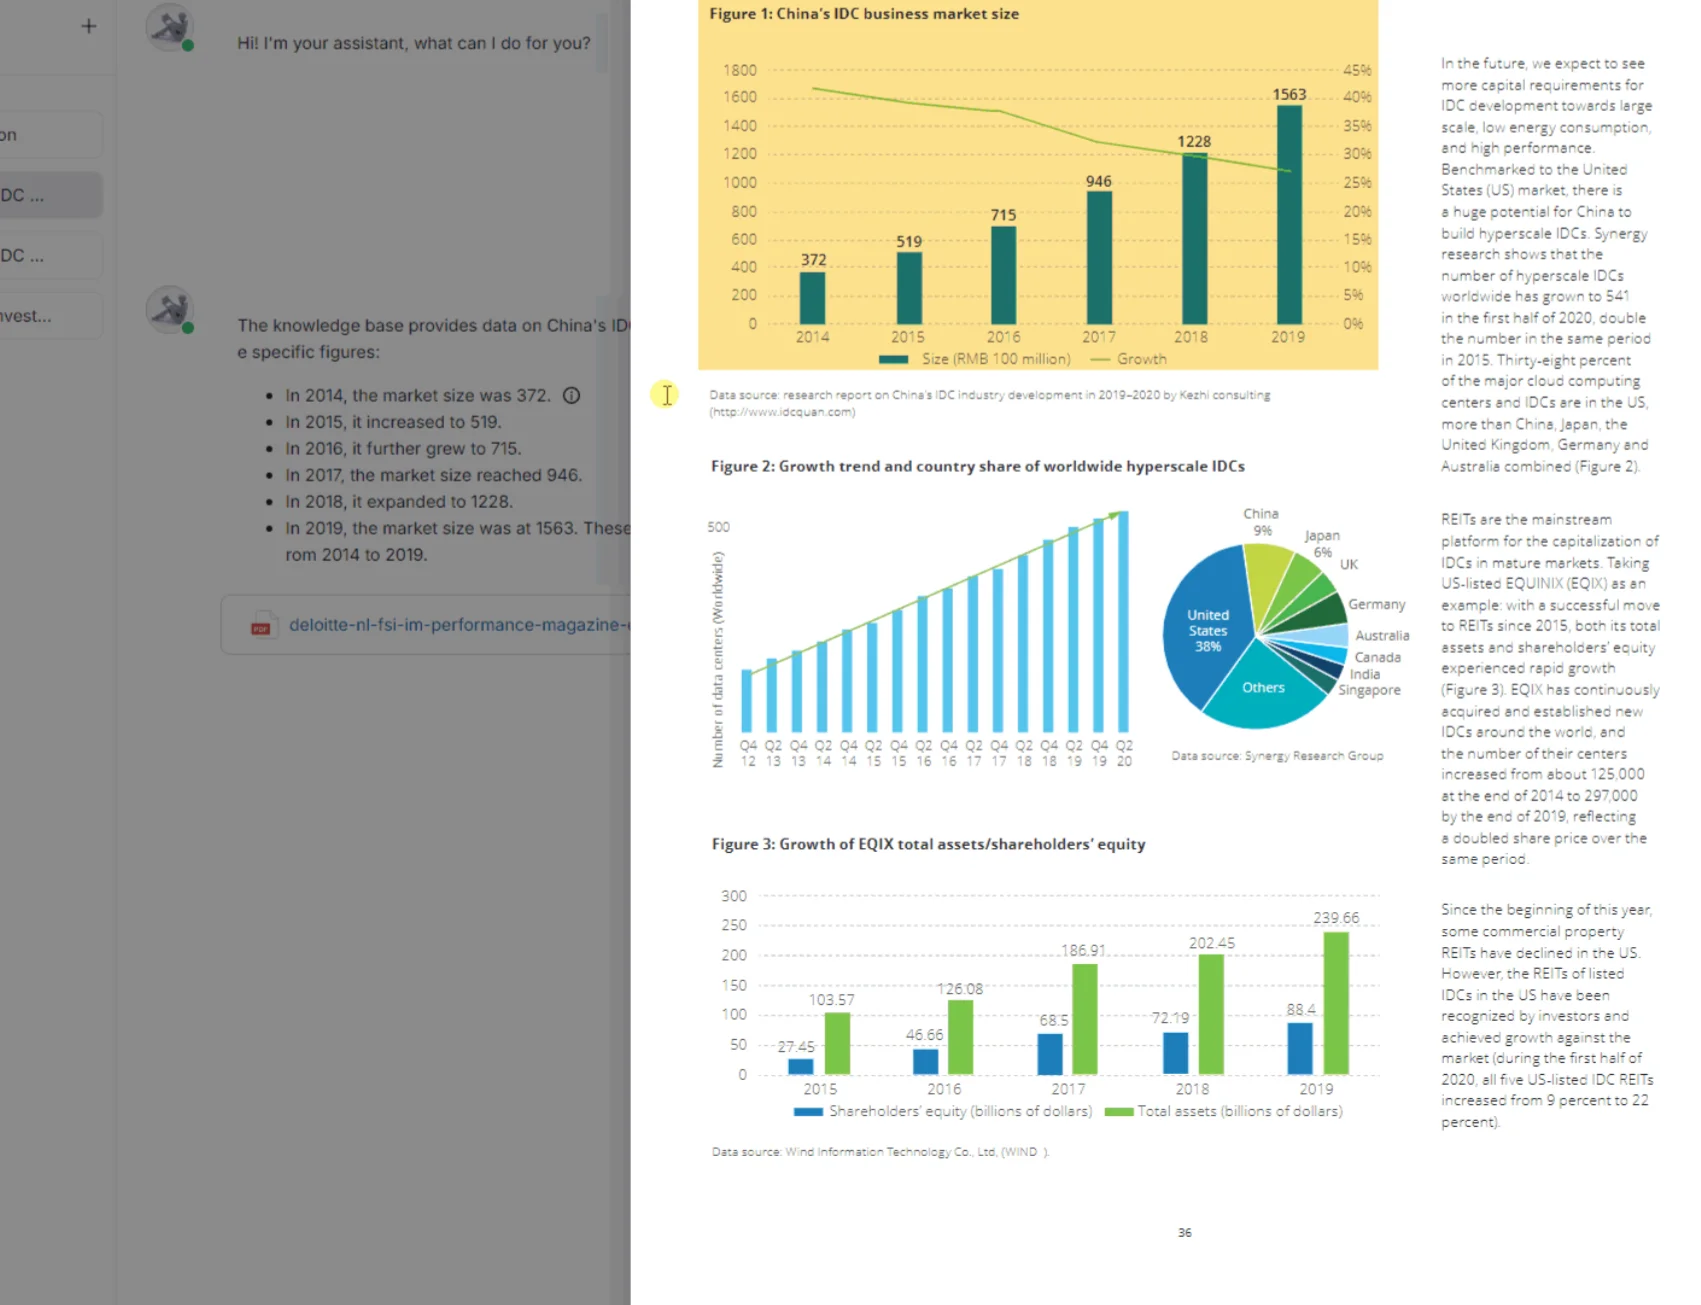
Architecture du système RAGFlow :
L'architecture du système RAGFlow comprend des composants clés tels qu'un analyseur de documents, un analyseur de requêtes, un module de récupération, un module de reclassement et un LLM (grand modèle de langage), permettant une réponse rapide et un traitement précis aux requêtes complexes.
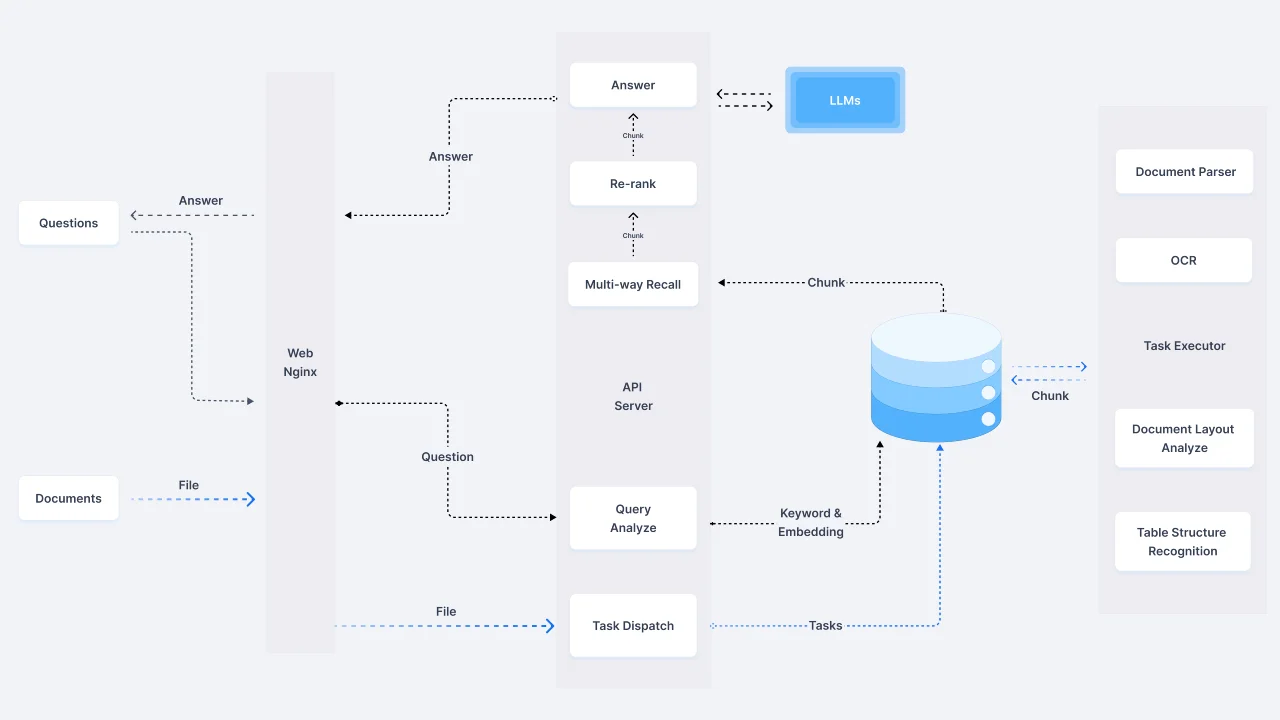
Applications de RAGFlow :
Gestion des connaissances en entreprise : construire une base de connaissances dédiée et optimiser le partage et la recherche des connaissances au sein de l'entreprise.
Service client : intégration aux systèmes de service client pour une recherche d'informations rapide et des réponses efficaces aux questions des clients.
Systèmes de recherche d'information : mettre en place des systèmes efficaces permettant d'obtenir rapidement les informations nécessaires.
Génération de documents : générer automatiquement des rapports, des résumés et d'autres documents.
Analyse de données : extraire des informations clés à partir de grands volumes de données pour analyse.
Soutien à l'éducation et à la recherche : les systèmes de tutorat intelligent peuvent générer des étapes de résolution ou des ressources d'apprentissage en fonction des questions des étudiants.
Comment utiliser RAGFlow ?
1. Mise en place de l'environnement : installer et configurer RAGFlow selon la documentation officielle, en disposant d'un environnement de développement tel que Python.
2. Définition des tâches : utiliser l'éditeur sans code ou l'interface de programmation pour définir les tâches et les flux de travail requis.
3. Saisie des données : entrer dans le système les données à traiter (telles que les requêtes des utilisateurs, les textes, etc.).
4. Recherche et génération dynamiques : rechercher et générer automatiquement du contenu selon le flux de travail prédéfini.
5. Ajustement et optimisation : évaluer et ajuster les résultats obtenus, et optimiser les tâches pour améliorer les performances du modèle.
GitHub :https://github.com/infiniflow/ragflow














